डिस्कवर पर AI उत्तर, रिपोर्ट, कोड और वर्कफ़्लो - पेज 1520
Claude Opus 4.7 बनाम GPT-5.5: लंबे कॉन्टेक्स्ट, एजेंटिक कोडिंग और API में किसे चुनें
Claude Opus 4.7 बनाम GPT-5.5: बेंचमार्क कैसे पढ़ें, सही मॉडल कैसे चुनें
Claude Opus 4.7 बनाम GPT-5.5: कोडिंग, एजेंट, रिसर्च और डिजाइन के लिए कौन-सा AI मॉडल बेहतर?
Claude Opus 4.7 बनाम GPT-5.5: enterprise deployment से पहले API, लागत और सबूत
Claude Opus 4.7 बनाम GPT-5.5 Spud: विजेता अभी साबित नहीं
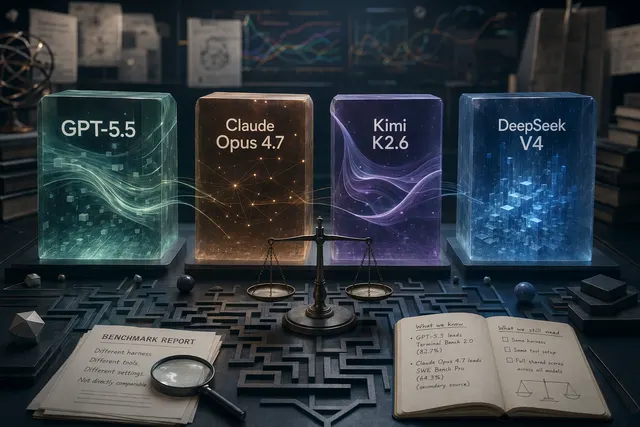
GPT-5.5, Claude Opus 4.7, Kimi K2.6 और DeepSeek V4-Pro: बेंचमार्क से सही मॉडल कैसे चुनें
GPT-5.5 अभी कैसे आज़माएँ: ChatGPT, Codex और API की स्थिति
GPT-5.5 बनाम Claude Opus 4.7 बनाम DeepSeek V4 बनाम Kimi K2.6: हर काम का विजेता अलग
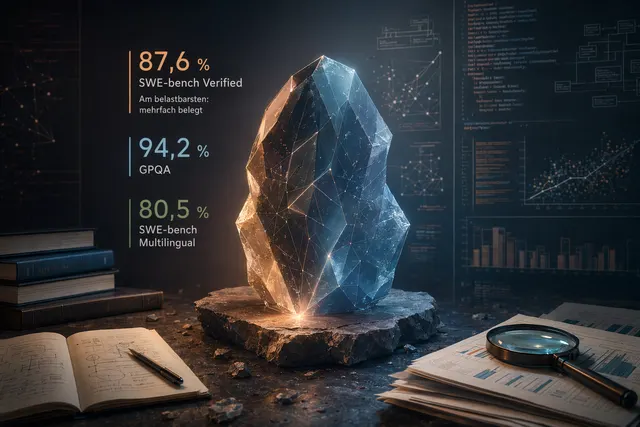
Claude Opus 4.7 बेंचमार्क: SWE-bench Verified में 87.6% का मतलब
Claude Opus 4.7 बेंचमार्क: 87.6% SWE-bench, 94.2% GPQA — आंकड़े कितने भरोसेमंद हैं?
Claude Mythos Preview: SWE-bench पर 93.9% स्कोर का असली मतलब
Claude Mythos बेंचमार्क: 93.9% SWE-bench, लेकिन तुलना इतनी सीधी नहीं