熱門 - 第 1729 頁
GPT-5.5 vs Claude Opus 4.7:寫程式該選哪個?
18 個來源0沒有絕對贏家:GPT 5.5 在 Terminal Bench 2.0 為 82.7%,適合先測終端機型 coding agent;Claude Opus 4.7 在 SWE Bench Pro 為 64.3%,大型 codebase 任務更值得先測。[6][36]
GPT-5.5 vs Claude Opus 4.7:寫程式該選誰?修補程式看 Claude,終端機代理看 GPT
19 個來源0既有程式碼庫的 bug 修補、測試通過與 PR patch,可先評估 Claude Opus 4.7;SWE bench Pro 上公開整理的數字為 Claude Opus 4.7 64.3%、GPT 5.5 58.6%。[16][29]
DeepSeek 怎麼用:網頁、App 到 API 串接入門
23 個來源0一般使用者可從 DeepSeek 官方首頁的 Start Now 或官方 App 開始;開發者先建立 API 金鑰,再用 Bearer 認證呼叫 OpenAI 相容的 /chat/completions。[24][23][1][12][13]
GPT-5.5、Claude Opus 4.7、DeepSeek V4、Kimi K2.6:別只看總榜,先看用途
24 個來源0不要把四個模型硬排成單一排行榜;公開基準的推理設定、更新時間、自報或第三方評測方式並不一致,較安全的做法是按任務選模型。[4][18]
GPT-5.5 有多強?從公開基準測試看優勢與弱點
16 個來源0GPT 5.5 是綜合最強候選之一:Terminal Bench 2.0 為 82.7,FrontierMath Tier 1–3 為 51.7;但 SWE Bench Pro 由 Claude Opus 4.7 領先,BrowseComp 則有 Gemini 3.1 Pro 與 Mythos Preview 高於它。[6][10]
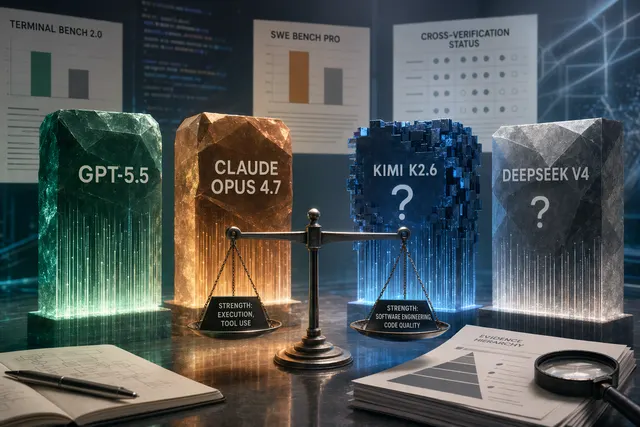
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試比較與證據等級
16 個來源0目前不能公平排出四模型總冠軍:同表可比的 OpenAI 數據顯示 Claude Opus 4.7 在 SWE Bench Pro 64.3% 高於 GPT 5.5 58.6%,但 GPT 5.5 在 Terminal Bench 2.0 82.7% 高於 Claude 69.4%;Kimi K2.6 與 DeepSeek V4 缺少同等級交叉驗證。[21]
Kimi K2.6 評測:編碼很亮眼,但還不是全能 AI 的定論
12 個來源0MLQ.ai 報告 Kimi K2.6 在 SWE Bench Pro 得 58.6、SWE bench Verified 達 65.8% pass@1;但有評測提醒獨立基準仍是初步結果 [8][9]。
Kimi K2.6 對上 GPT-5.5、Gemini、Claude:開發者選型結論
23 個來源0Kimi K2.6 在這組資料中的價格優勢最清楚:OpenRouter 列出 262,144 token 上下文,標準價格為每 100 萬輸入/輸出 token $0.75/$3.50,另有效價格頁列為 $0.60/$2.80 [26][32]。
GPT-5.5 vs Claude Opus 4.7:該選工作執行,還是長文 Agent?
21 個來源0若要從少量指令一路完成調查、分析、程式與文件產出,GPT 5.5 較適合先試;若要吃進 1M 長上下文、跑大型程式碼或 Agent 工作流,Claude Opus 4.7 更值得評估。[1][3][13][26]
DeepSeek V4 暫定評測:接近前沿,但說「全球最強」還太早
18 個來源0DeepSeek V4 已在 2026 年 4 月 24 日出現在官方 API 文件的「Preview Release」頁面;較穩妥的結論是:它看起來很強,但尚不足以斷言是全球最強。[13]