熱門 - 第 1730 頁
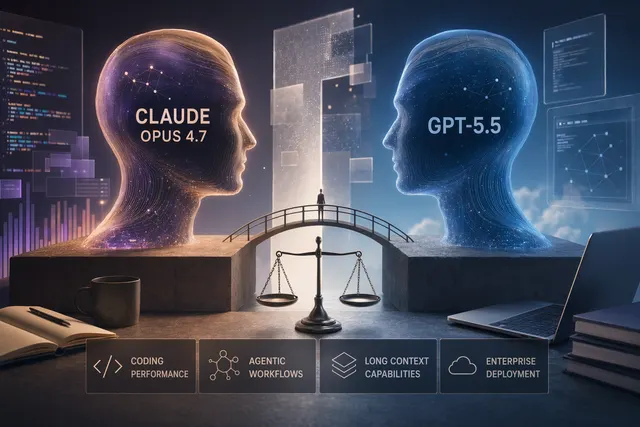
Claude Opus 4.7 vs GPT-5.5:長上下文、代理編碼與企業部署怎麼選
21 個來源0若今天要做 API 採購、長上下文 agent 或企業部署,Claude Opus 4.7 目前更容易直接評估:它有 1M context、標準 API 無 long context premium、5/25 美元每百萬 input/output tokens 與多雲可用性;GPT 5.5 更適合測試跨工具真實工作,但官方 API 成本與 context 資訊仍不完整。[38][29][1][10]
Claude Opus 4.7 vs GPT-5.5:基準怎麼看、實務怎麼選
11 個來源0目前沒有足夠的同條件基準能宣布 Claude Opus 4.7 或 GPT 5.5 全面勝出:Opus 4.7 在 GDPval AA 以 1,753 Elo 成為新領先者;GPT 5.5 high、low、non reasoning 在 Intelligence Index 分別為 59、51、41,且有 ChatGPT/Codex 整合,但這些不是同一套測試。[5][2][6][3][4]
Claude Opus 4.7 vs GPT-5.5:寫程式、Agent、研究與設計該選誰?
17 個來源0若先看公開基準,Claude Opus 4.7 是 coding 與工具型 agent 的較有把握首選:Vellum 報告其 SWE bench Verified 為 87.6%、MCP Atlas 為 77.3% [3]。
Claude Opus 4.7 vs GPT-5.5:企業部署前該看清的 API、成本與證據
26 個來源0Claude Opus 4.7 目前有較完整的企業部署資訊:Claude API、多雲平台、1M context,以及每百萬 input/output tokens 5/25 美元的公開價格。[11][80]
Claude Opus 4.7 vs GPT-5.5 Spud:基準測試還不能判勝負
24 個來源0目前不能可靠判定勝負:Anthropic 文件列出 claude opus 4 7,但 GPT 5.5 Spud 在提供資料中未由 OpenAI 一手文件驗證。
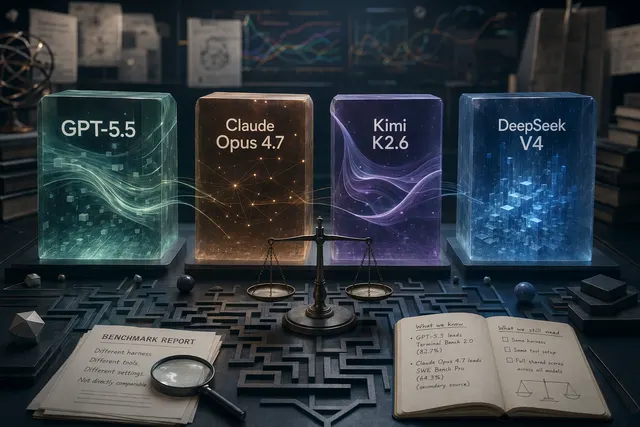
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試與選型指南
23 個來源0目前沒有足夠公開資料可公平排出單一總冠軍;可引用數據顯示 GPT 5.5 在 Terminal Bench 2.0 為 82.7%,Claude Opus 4.7 在 SWE Bench Pro 為 64.3%,但後者來自次級整理引用 AWS,且不同來源與工具設定不能混成絕對榜單。[27][4]
GPT-5.5 現在怎麼試用:ChatGPT、Codex、API 官方狀態一次看
15 個來源0目前想試 GPT 5.5,最直接的入口是 ChatGPT 或 Codex;ChatGPT/Codex 正向 Plus、Pro、Business、Enterprise 使用者逐步推出,API 文件仍標示為即將提供。[20][1]
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6:不同任務有不同贏家
24 個來源0公開基準測試不支持直接排出單一總冠軍。GPT 5.5在Terminal Bench 2.0達82.7%,適合先測終端機代理編碼;Claude Opus 4.7在SWE Bench Pro 64.3%、SWE Bench Verified 87.6%,更像程式修復首選候選 [19][27][5]。
Claude Opus 4.7 基準測試解讀:SWE-bench Verified 87.6% 代表什麼?
12 個來源0Claude Opus 4.7 的焦點數字是 AWS 報告的 SWE bench Verified 87.6%,顯示其在代理式編碼場景具競爭力,但不能視為所有任務的通用表現 [7]。
Claude Opus 4.7 基準測試怎麼看:SWE-bench、GPQA 與可信度
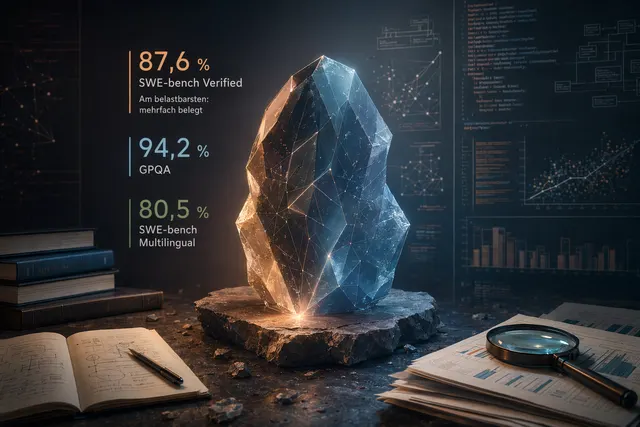
16 個來源0Claude Opus 4.7 目前公開資料中常見的三個數字是 SWE bench Verified 87.6%、GPQA 94.2%、SWE bench Multilingual 80.5%;其中 SWE bench Verified 的來源支撐最穩。
Claude Mythos Preview 的 93.9% SWE-bench:這個基準測試該怎麼看
17 個來源0Claude Mythos Preview 最常被引用的數字是 SWE bench 93.9%;這是軟體工程與程式碼任務的訊號,不是模型的整體總分 [1][2]。