트렌딩 AI 게시물과 핫 리서치 캐치업 - 92페이지
알리바바 ‘전우 V900’ 공개…M890 대비 성능 3배 주장은 검증 전
17 소스0알리바바는 전우 V900이 AI 모델 학습과 추론을 모두 처리하며, 이전 제품 M890보다 성능이 3배 높다고 주장한다. 독립 검증 결과는 공개되지 않았다.
Xing4.0-29B-A4B 살펴보기: 290억 매개변수, 토큰당 40억 활성화
19 소스0Xing4.0 29B A4B는 코딩과 여러 단계를 거치는 에이전트 작업을 겨냥한 공개 가중치 MoE 모델이다. 전체 매개변수는 약 290억 개이며, 토큰마다 약 40억 개가 활성화된다.
리오토의 로봇 AI 3종, 하나의 ‘두뇌’로 검증됐을까
14 소스0리오토는 2026년 9월 22일 체화형 AI 시스템 ME Brain 1.0, 시각·언어 모델 ME VLM, 이해·행동 생성 모델 ME U0를 공개했다.
인스퍼 SD200 Ultra, AI 칩 128개 결합…‘토큰당 5.85ms’는 어떻게 봐야 하나
17 소스0인스퍼는 SD200 Ultra 한 대에서 2조 8000억 매개변수의 Kimi K3를 실행하고, 생성 토큰당 지연시간을 5.85ms 미만으로 낮췄다고 주장한다.
중국의 ‘궤도 데이터센터’, 하나의 거대 시설 대신 위성 여러 대로
25 소스02026년 9월까지 중국은 AI 컴퓨팅 위성 12기를 발사했고, 실험적 궤도 클라우드 서비스를 시작했으며, 위성에서 지상으로 보내는 레이저 통신에서 최고 120Gbps를 보고했다.[11][46][21]
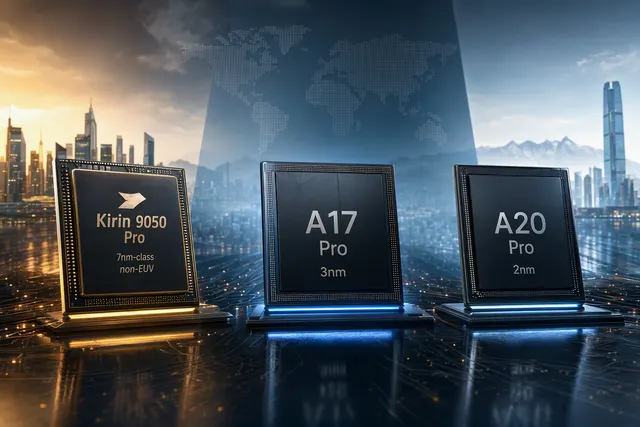
화웨이 칩이 애플을 앞섰다? ‘멀티코어 승리’의 정확한 범위
21 소스0번스타인 평가에 따르면 기린 9050 프로는 긱벤치 6 멀티코어에서 A17 프로를 앞섰지만, 최신 A20 프로에는 종합 성능에서 약 30% 뒤진다.
Qwen 4는 아직 훈련 중…알리바바 발표에서 확인된 것과 아닌 것
23 소스0알리바바는 2026년 9월 22일 Qwen 4가 훈련 중이라고 밝혔다. 5조 10조 매개변수는 후속 Qwen 4.5·Qwen 5 시리즈의 목표치다.
알리바바 클라우드 ‘에이전틱 클라우드’ 전략: AgentCore·CPFS·HPN 8.0 Pro의 역할
17 소스0알리바바 클라우드는 모델·에이전트 실행 환경·맥락 데이터라는 세 가지 요구에 각각 AI Native Cloud, Agent Native Cloud, Context Engine을 대응시켰다.[3][4]
알리바바의 음성 AI, 무엇이 달라졌나: 실시간 통역부터 장면 음향 제작까지
16 소스0Qwen3.8 LiveTranslate는 발화가 진행되는 동안 통역한다. 알리바바가 발표한 평균 번역 지연 지표는 약 2.8초에서 2.3초로 줄었다.
ZCode 코드 업로드 논란: 삭제된 기능과 감사로 확인된 범위
22 소스0연구자가 ZCode의 작업 공간 업로드를 확인한 뒤, 지푸 AI는 사과하고 코드를 공개했다. v3.14.0에서는 Repo Wiki와 저장소 스냅샷 업로드 경로를 제거했다.
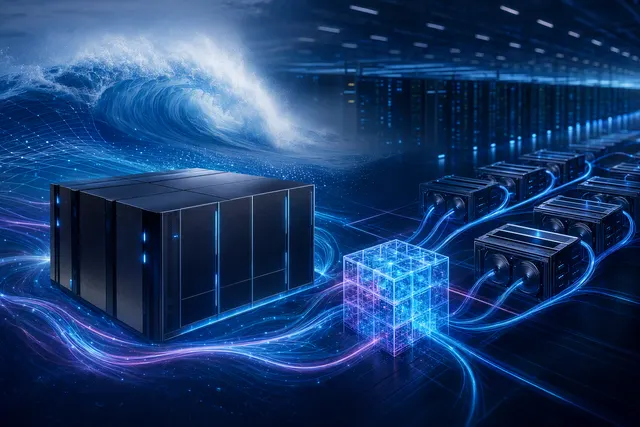
화웨이 OceanStor M900, AI 추론용 ‘공유 KV 캐시’는 어떻게 작동하나
19 소스0OceanStor M900은 SuperPoD의 KV 캐시를 칩 메모리·DRAM에서 공유 SSD 저장 공간까지 확장하며, 화웨이는 클러스터당 64PB 용량을 제시한다.
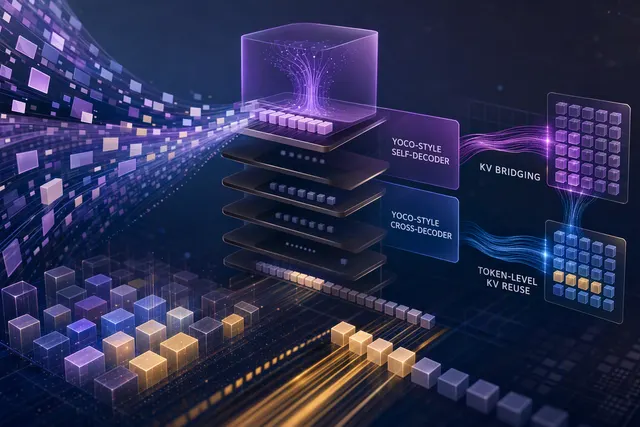
샤오미 HySparse2, 100만 토큰 입력 처리량 줄이면서 긴 문맥을 찾는 방법
14 소스0총 800억 매개변수, 토큰당 약 30억 개를 활성화하는 MoE 구성의 보고된 비교에서 HySparse2는 100만 토큰 기준 Hybrid SWA보다 사전 처리 FLOPs가 5.02배 적고, KV 캐시는 12.09GB에서 2.69GB로 줄었다.