AI 답변, 보고서, 코드 및 워크플로 살펴보기 - 페이지 1520
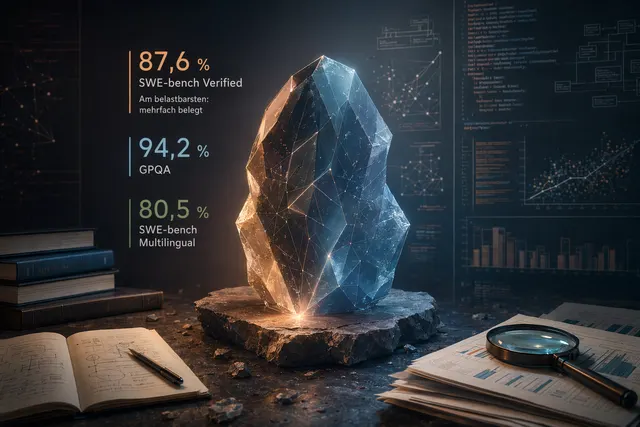
Claude Opus 4.7 벤치마크: SWE-bench 87.6%, GPQA 94.2%는 얼마나 믿을 만한가
16 소스
Claude Mythos Preview의 SWE-bench 93.9%, 어떻게 읽어야 할까
17 소스
Claude Mythos 벤치마크: SWE-bench 93.9%가 말해주는 것과 말해주지 않는 것
17 소스
Kimi K2.6·DeepSeek V4·GPT-5.5·Claude Opus 4.7: 벤치마크와 가격으로 고르는 법
20 소스
GPT-5.5 vs Claude Opus 4.7: 벤치마크보다 중요한 업무 흐름
17 소스
GPT-5.5 vs DeepSeek V4: 코딩·에이전트 벤치마크와 가격 비교
19 소스
GPT-5.5 vs Claude Opus 4.7: 코드 수정은 Claude, 터미널 에이전트는 GPT부터
17 소스
DeepSeek V4 vs Kimi K2.6 벤치마크: 코딩은 DeepSeek, 콘텐츠·번역은 보류
18 소스
DeepSeek V4·Kimi K2.6·Claude Opus 4.7·GPT-5.5 벤치마크 비교: 용도별 승자는 다르다
16 소스
GPT-5.5·Claude Opus 4.7·Kimi K2.6·DeepSeek V4 벤치마크 비교
19 소스
GPT-5.5 vs Claude Opus 4.7: 코딩·디자인·창작, 어디에 써야 할까
19 소스
Kimi K2.6 vs DeepSeek V4: 실무 코딩은 Kimi, 긴 문서는 DeepSeek
23 소스