トレンドAI投稿と注目リサーチのキャッチアップ - ページ1720
Claude Opus 4.7とGPT-5.5、業務AIとしてどう選ぶか
21 ソース0API調達、長文コンテキストのエージェント、企業内ツールチェーンへの組み込みなら、Claude Opus 4.7のほうが現時点で評価材料がそろっています。1M context window、長文追加料金なし、主要クラウド経由の利用、入力5ドル/出力25ドルの価格が公開されています。[38][29]
Claude Opus 4.7 vs GPT-5.5:ベンチマークの読み方と実務での選び方
11 ソース0現時点の公開情報だけでは、Claude Opus 4.7とGPT 5.5のどちらが全面的に上とは言えません。Opus 4.7はGDPval AAで1,753 Eloの新首位、GPT 5.5はIntelligence Indexでhigh 59、low 51、non reasoning 41という別系統の成績が示されています。[5][2][6][3]
Claude Opus 4.7 vs GPT-5.5:コーディング、エージェント、調査、デザインで選ぶなら
17 ソース0コーディングとツール多用型エージェントは、Claude Opus 4.7を先に試す根拠が比較的強い。VellumはSWE bench Verified 87.6%、MCP Atlas 77.3%を報告している。
Claude Opus 4.7 vs GPT-5.5:企業導入前に見るべきAPI、コスト、根拠
26 ソース0今日からAPI PoCを始めるなら、Claude Opus 4.7のほうが見積もりやすい状況です。Claude API、多クラウド、1M context、$5/$25 per million input/output tokensが公式に示される一方、GPT 5.5のAPIはOpenAI Modelsページでcoming soonとされています。[11][80][45]
Claude Opus 4.7対GPT-5.5 Spud:勝者を決めるにはまだ早い
24 ソース0現時点で明確な勝者は出せません。Claude Opus 4.7はAnthropic公式資料で確認できますが、GPT 5.5 SpudはここではOpenAIの一次情報で検証できていません。
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4-Pro:ベンチマークで見る選び方
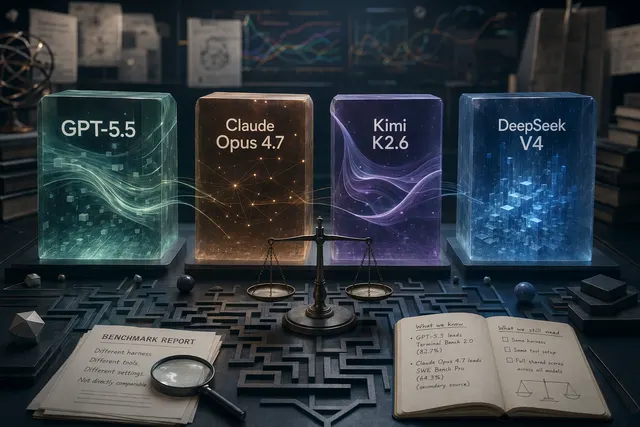
23 ソース0現時点の公開情報だけで、4モデルを公平な単一ランキングにするのは難しい。引用可能な数値ではGPT 5.5がTerminal Bench 2.0で82.7%、Claude Opus 4.7がSWE Bench Proで64.3%だが、後者はAWSを引用した二次整理の数値であり、出所や条件の違いに注意が必要だ。[27][4]
GPT-5.5を今すぐ試す方法:ChatGPT・Codex・APIの対応状況
15 ソース0いまGPT 5.5を試す最短ルートはChatGPTかCodexです。ChatGPTではPlus、Pro、Business、Enterprise向けに段階的提供中で、APIは公式ドキュメント上まだ「coming soon」です。[20][1]
GPT-5.5、Claude Opus 4.7、DeepSeek V4、Kimi K2.6比較:用途別の勝者は違う
24 ソース0公開ベンチマークだけで4モデルの総合1位を断定するのはまだ早い状況です。GPT 5.5はTerminal Bench 2.0で82.7%、Claude Opus 4.7はSWE Bench Proで64.3%、SWE Bench Verifiedで87.6%と強みが分かれますが、4モデルを同じ評価ハーネスでそろえた独立比較は不足しています [19][27][5]。
Claude Opus 4.7のベンチマークを読む:SWE-bench Verified 87.6%の意味
12 ソース0Claude Opus 4.7の目立つ数字は、AWSがAnthropicのデータとして報告したSWE bench Verified 87.6%。エージェント型コーディングでは重要な指標だが、万能な性能保証ではない [7]。
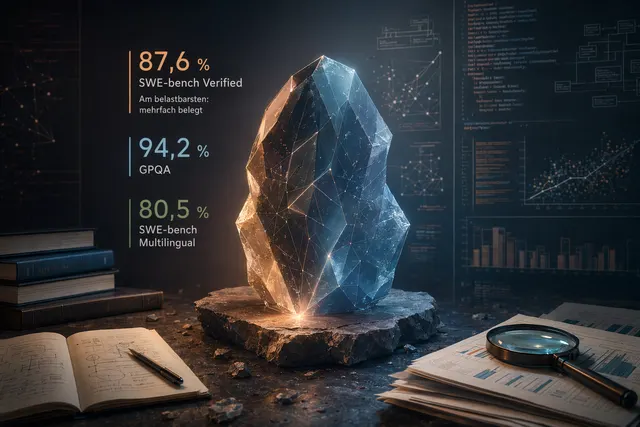
Claude Opus 4.7のベンチマーク:SWE-bench、GPQA、多言語評価をどう読むか
16 ソース0Claude Opus 4.7では、公開情報上、SWE bench Verified 87.6%、GPQA 94.2%、SWE bench Multilingual 80.5%が主要な数値として挙がっている。
Claude Mythos Previewの「SWE-bench 93.9%」をどう読むべきか
17 ソース0Claude Mythos Previewで最もよく引用される数値は、ソフトウェア系タスクを測るSWE benchの93.9%。コード作業や開発エージェントの比較には有用だが、モデル全体の総合点ではない [1][2]。
Claude Mythosベンチマーク:SWE-bench 93.9%、ただし比較には注意
17 ソース0Claude Mythos PreviewはSWE bench Verifiedで93.9%と報じられている一方、AnthropicによればProject Glasswing向けの招待制研究プレビューです。