Postingan AI Trending & Rangkuman Riset Terbaru - Halaman 1721
GPT-5.5: seberapa kuat, siapa yang bisa memakai, dan apa yang masih perlu diuji
12 sumber0OpenAI memperkenalkan GPT 5.5 pada 23 April 2026 sebagai model baru untuk kerja praktis, termasuk coding, data, riset online, dokumen, spreadsheet, dan operasi software [6][7].
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: Panduan Praktis Memilih Model AI 2026
29 sumber0Tidak ada pemenang universal dari bukti publik yang tersedia; keputusan terbaik bergantung pada beban kerja, biaya, konteks, dan kebutuhan deployment.
Benarkah Belajar Pernah Disebut Membuat Rahim Menyusut?
4 sumber0Sumber yang tersedia tidak membuktikan adanya buku ajar kedokteran yang mengajarkan bahwa membaca atau belajar membuat rahim menyusut.
GPT-5.5 vs Claude Opus 4.7: mana yang lebih pas untuk coding?
18 sumber0Tidak ada pemenang mutlak: GPT 5.5 unggul di Terminal Bench 2.0, sementara Claude Opus 4.7 unggul di SWE Bench Pro dan menawarkan context window 1M token.
GPT-5.5 vs Claude Opus 4.7 untuk Coding: Claude Kuat di Patch, GPT Kuat di Terminal
19 sumber0Untuk memperbaiki kode di repo yang sudah ada dan membuat patch yang lolos tes, Claude Opus 4.7 lebih layak diuji dulu.
Cara Menggunakan DeepSeek: Mulai dari Web, Aplikasi, hingga API
23 sumber0Untuk mencoba cepat, gunakan Start Now di situs resmi atau unduh aplikasi melalui kanal resmi; DeepSeek juga menyediakan jalur API.[24][23]
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: Benchmark Berdasarkan Kebutuhan
24 sumber0Jangan membaca empat model ini sebagai satu ranking mutlak. Setelan reasoning, waktu evaluasi, dan metode pelaporan benchmark tidak selalu seragam, sehingga pilihan paling aman adalah berdasarkan use case.[4...
Seberapa Kuat GPT-5.5? Membaca Benchmark Publik dan Titik Lemahnya
16 sumber0GPT 5.5 masuk jajaran model frontier terkuat, dengan skor 82,7 di Terminal Bench 2.0 dan 51,7 di FrontierMath Tier 1–3, tetapi tidak selalu nomor satu: Claude Opus 4.7 unggul di SWE Bench Pro, sementara Gemi...
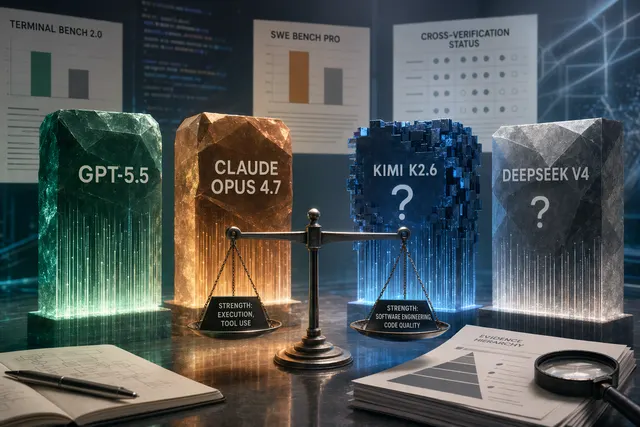
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4: Benchmark dan Tingkat Buktinya
16 sumber0Perbandingan paling bersih saat ini adalah GPT 5.5 vs Claude Opus 4.7 di tabel OpenAI: Claude unggul di SWE Bench Pro 64,3% vs 58,6%, tetapi GPT 5.5 unggul di Terminal Bench 2.0 82,7% vs 69,4%.[21]
Review Kimi K2.6: Jago Coding, tapi Belum Terbukti Serbabisa
12 sumber0Kimi K2.6 terlihat sangat kuat untuk coding: MLQ.ai melaporkan skor 58,6 di SWE Bench Pro dan 65,8% pass@1 di SWE bench Verified, tetapi satu ulasan menekankan bahwa evaluasi independen masih bersifat awal [...
Kimi K2.6 vs GPT-5.5, Gemini 2.5 Pro, Claude: Pilihan Developer?
23 sumber0Kimi K2.6 paling layak diuji dulu untuk agen coding volume tinggi: OpenRouter mencantumkan konteks 262.144 token dan harga $0,75/$3,50 per 1 juta token input/output [26].
GPT-5.5 vs Claude Opus 4.7: Pilih Eksekusi Kerja atau Agen Konteks Panjang?
21 sumber0GPT 5.5 lebih mudah dipilih jika Anda ingin AI mengeksekusi riset, analisis, kode, dan dokumen dari arahan singkat; Claude Opus 4.7 lebih menonjol untuk konteks 1M token, coding besar, dan agen AI.