Perbandingan Benchmark GPT-5.5, Claude Opus 4.7, Kimi K2.6, dan DeepSeek V4
Perbandingan paling bersih saat ini adalah GPT 5.5 vs Claude Opus 4.7 di tabel OpenAI: Claude unggul di SWE Bench Pro 64,3% vs 58,6%, tetapi GPT 5.5 unggul di Terminal Bench 2.0 82,7% vs 69,4%.[21] Kimi K2.6 layak masuk daftar kandidat model terbuka: Hugging Face menyebutnya open source dan multimodal agentic, semen...
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
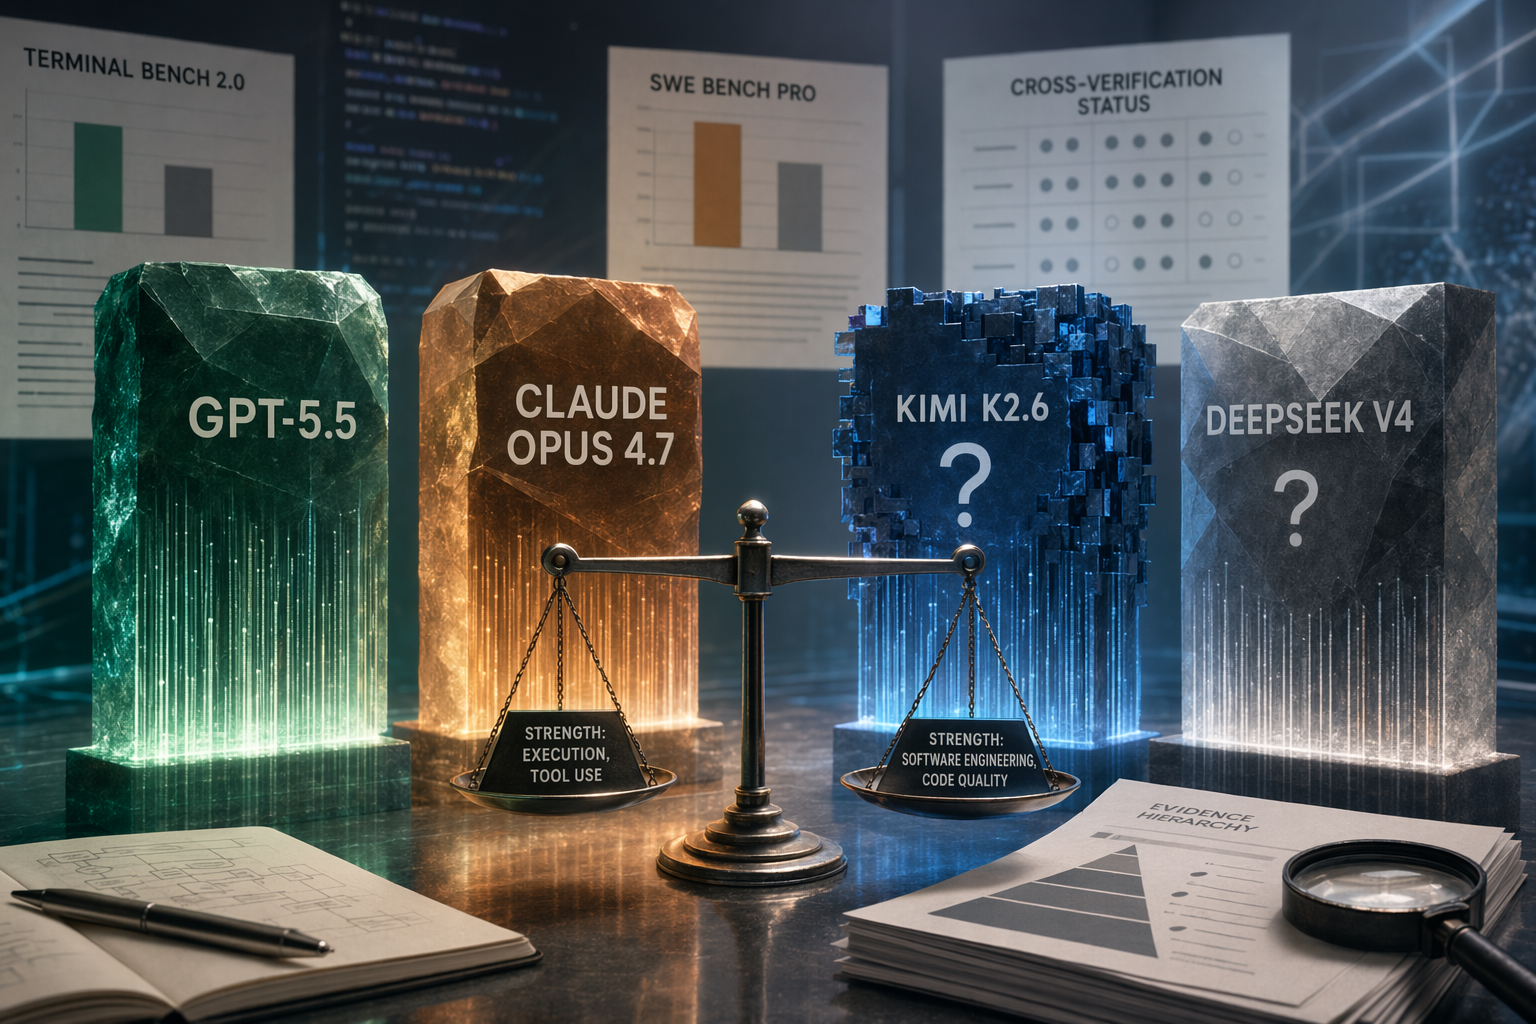
Perbandingan paling bersih saat ini adalah GPT 5.5 vs Claude Opus 4.7 di tabel OpenAI: Claude unggul di SWE Bench Pro 64,3% vs 58,6%, tetapi GPT 5.5 unggul di Terminal Bench 2.0 82,7% vs 69,4%.[21]
Kimi K2.6 layak masuk daftar kandidat model terbuka: Hugging Face menyebutnya open source dan multimodal agentic, sementara Kilo AI mencatat 58,6% di SWE Bench Pro dan 80,2% di SWE Bench Verified, tetapi sumbernya tid...
DeepSeek V4 tidak diberi peringkat numerik karena sumber yang tersedia untuk artikel ini belum menyediakan benchmark yang bisa dikutip; GPT 5.5 Expert SWE 73,1% juga harus dibaca hati hati karena eval internal dengan...
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試比較表與證據等級AI 生成示意圖;本文聚焦可核驗 benchmark 分數與來源等級。
AI Perintah
Create a landscape editorial hero image for this Studio Global article: GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試比較表與證據等級. Article summary: 目前不能公平排出四模型總冠軍:同表可比數據顯示 Claude Opus 4.7 在 SWE Bench Pro 64.3% vs GPT 5.5 58.6% 領先,但 GPT 5.5 在 Terminal Bench 2.0 82.7% vs 69.4% 領先;Kimi K2.6 與 DeepSeek V4 缺少同等級交叉驗證。[21]. Topic tags: ai, llm benchmarks, openai, anthropic, claude. Reference image context from search candidates: Reference image 1: visual subject "OpenAI’s GPT-5.5, Anthropic’s Claude Opus 4.7, and DeepSeek V4 arrived close enough together to look like a clean three-way race. **GPT-5.5 is OpenAI’s bet on execution-heavy profe" source context "GPT-5.5, Claude Opus 4.7, and DeepSeek V4 reveal three different ..." Reference image 2: visual subject "# DeepSeek V4 Pro vs Claude Opus 4.7 vs GPT-5.5: The Frontier in April 2026. DeepSeek V4 Pro undercuts GPT-5.5 by ~9x on outpu
openai.com
Jika Anda membandingkan GPT-5.5, Claude Opus 4.7, Kimi K2.6, dan DeepSeek V4 untuk kebutuhan coding agent atau produk berbasis LLM, pertanyaan pertamanya bukan: siapa juara umum? Pertanyaan yang lebih aman adalah: skor mana yang benar-benar bisa dibandingkan dengan ukuran yang sama?
Dalam sumber yang tersedia untuk artikel ini, perbandingan paling kuat adalah GPT-5.5 vs Claude Opus 4.7 karena keduanya muncul dalam tabel evaluasi OpenAI yang sama untuk SWE-Bench Pro dan Terminal-Bench 2.0. Kimi K2.6 punya angka yang menarik, tetapi berasal dari halaman model dan artikel pihak ketiga. DeepSeek V4 belum memiliki angka benchmark yang cukup dapat dikutip di kumpulan sumber ini, jadi tidak tepat jika dipaksa masuk peringkat numerik.
Tabel perbandingan benchmark
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "Perbandingan Benchmark GPT-5.5, Claude Opus 4.7, Kimi K2.6, dan DeepSeek V4"?
Perbandingan paling bersih saat ini adalah GPT 5.5 vs Claude Opus 4.7 di tabel OpenAI: Claude unggul di SWE Bench Pro 64,3% vs 58,6%, tetapi GPT 5.5 unggul di Terminal Bench 2.0 82,7% vs 69,4%.[21]
Apa poin penting yang harus divalidasi terlebih dahulu?
Perbandingan paling bersih saat ini adalah GPT 5.5 vs Claude Opus 4.7 di tabel OpenAI: Claude unggul di SWE Bench Pro 64,3% vs 58,6%, tetapi GPT 5.5 unggul di Terminal Bench 2.0 82,7% vs 69,4%.[21] Kimi K2.6 layak masuk daftar kandidat model terbuka: Hugging Face menyebutnya open source dan multimodal agentic, sementara Kilo AI mencatat 58,6% di SWE Bench Pro dan 80,2% di SWE Bench Verified, tetapi sumbernya tid...
Apa yang harus saya lakukan selanjutnya dalam latihan?
DeepSeek V4 tidak diberi peringkat numerik karena sumber yang tersedia untuk artikel ini belum menyediakan benchmark yang bisa dikutip; GPT 5.5 Expert SWE 73,1% juga harus dibaca hati hati karena eval internal dengan...
Tanda — berarti sumber yang dipakai artikel ini tidak menyediakan angka yang dapat dikutip, bukan berarti model tersebut tidak mampu mengerjakan tugas tersebut. Skor dari sumber, harness, dan kondisi uji yang berbeda juga sebaiknya tidak dijumlahkan menjadi satu ranking mutlak.
Model
SWE-Bench Pro
SWE-Bench Verified
Terminal-Bench 2.0
Data lain yang terlihat
Tingkat bukti dan cara membaca
GPT-5.5
58,6%
—
82,7%
Expert-SWE Internal 73,1%; OpenAI memberi catatan bahwa lab lain melihat memorization evidence pada eval ini.
A-: SWE-Bench Pro dan Terminal-Bench 2.0 muncul dalam tabel OpenAI yang sama dengan Claude Opus 4.7, sehingga relatif paling bisa dibandingkan langsung. Expert-SWE tetap perlu dibaca konservatif karena merupakan eval internal.
Claude Opus 4.7
64,3%
87,6%
Kimi K2.6
58,6%
80,2%
—
Halaman Hugging Face menggambarkannya sebagai model open-source, native multimodal, dan agentic.
B terbatas: angkanya kompetitif, tetapi berasal dari artikel pihak ketiga dan belum muncul dalam tabel resmi lintas model yang sama dengan GPT-5.5 dan Claude Opus 4.7.
DeepSeek V4
—
—
—
—
C data tidak cukup: dalam sumber yang tersedia untuk artikel ini, belum ada benchmark DeepSeek V4 yang cukup dapat dikutip untuk dibuat peringkat numerik.
Benchmark mana yang paling layak diperhatikan?
SWE-Bench Pro: Claude Opus 4.7 unggul atas GPT-5.5
Di tabel evaluasi OpenAI, Claude Opus 4.7 mencatat 64,3% di SWE-Bench Pro, lebih tinggi daripada GPT-5.5 yang berada di 58,6%. Ini termasuk perbandingan yang paling bersih di artikel ini karena kedua model muncul dalam satu tabel yang sama.
Untuk konteks, Vellum membaca selisih ini dalam skenario penyelesaian issue GitHub dunia nyata, yaitu konteks yang relevan bagi tim yang membangun coding agent untuk memperbaiki bug atau mengerjakan perubahan multi-file.
Kimi K2.6 juga dilaporkan mencetak 58,6% di SWE-Bench Pro dalam artikel Kilo AI. Namun, karena angka itu tidak muncul dalam tabel lintas model yang sama dengan GPT-5.5 dan Claude Opus 4.7, posisinya lebih tepat dibaca sebagai sinyal awal, bukan bukti head-to-head yang sepenuhnya setara.
Terminal-Bench 2.0: GPT-5.5 unggul atas Claude Opus 4.7
Untuk Terminal-Bench 2.0, tabel OpenAI menunjukkan GPT-5.5 berada di 82,7%, sedangkan Claude Opus 4.7 berada di 69,4%. Jika pekerjaan Anda lebih dekat ke workflow terminal, command-line, atau agent yang perlu menjalankan langkah teknis secara berurutan, GPT-5.5 pantas masuk daftar uji lebih awal.
Namun, sumber artikel ini tidak menyediakan skor Terminal-Bench 2.0 yang dapat dikutip untuk Kimi K2.6 atau DeepSeek V4. Artinya, benchmark ini belum bisa dipakai untuk membuat ranking empat model secara lengkap.
SWE-Bench Verified: Claude lebih tinggi dari Kimi, tetapi sumbernya tidak satu meja
Claude Opus 4.7 tercatat 87,6% di SWE-Bench Verified dalam ringkasan pihak ketiga; Verdent menandai angka itu sebagai Anthropic-conducted dan menyebut memorization screens applied. Kimi K2.6 tercatat 80,2% di SWE-Bench Verified dalam artikel Kilo AI.
Secara angka, Claude Opus 4.7 terlihat lebih tinggi. Tetapi karena sumber dan cara pelaporannya berbeda, perbandingan ini tidak sekuat SWE-Bench Pro dan Terminal-Bench 2.0 yang sama-sama muncul di tabel OpenAI untuk GPT-5.5 dan Claude Opus 4.7.
Expert-SWE: berguna sebagai sinyal, bukan dasar ranking utama
GPT-5.5 mencatat 73,1% di Expert-SWE Internal, tetapi OpenAI sendiri menandainya sebagai internal eval dan mencatat bahwa lab lain melihat memorization evidence pada eval tersebut. Karena itu, angka Expert-SWE sebaiknya tidak dijadikan dasar utama untuk menyatakan GPT-5.5 sebagai pemenang umum.
Implikasi untuk memilih model
Jika tugas Anda mirip memperbaiki issue GitHub atau rekayasa perangkat lunak kompleks, Claude Opus 4.7 layak diuji lebih dulu. Dalam data yang paling langsung bisa dibandingkan, Claude Opus 4.7 unggul di SWE-Bench Pro dengan 64,3% dibanding GPT-5.5 di 58,6%. Interpretasi Vellum juga menempatkan benchmark ini dalam konteks real GitHub issue resolution.
Jika workflow Anda lebih banyak bergantung pada terminal atau eksekusi langkah teknis, GPT-5.5 layak diprioritaskan. Skor 82,7% di Terminal-Bench 2.0 memberi GPT-5.5 keunggulan jelas atas Claude Opus 4.7 yang berada di 69,4% pada benchmark yang sama.
Jika Anda membutuhkan kandidat model terbuka, Kimi K2.6 bisa masuk daftar pendek. Halaman Hugging Face menyebut Kimi K2.6 sebagai model open-source, native multimodal, dan agentic. Artikel Kilo AI juga melaporkan 58,6% di SWE-Bench Pro dan 80,2% di SWE-Bench Verified. Tetapi untuk keputusan produksi, angka itu sebaiknya divalidasi ulang dengan repositori, bahasa pemrograman, dan alur kerja Anda sendiri.
Jika Anda sedang mengevaluasi DeepSeek V4, pilihan paling aman adalah menunggu benchmark yang dapat dikutip atau menjalankan pengujian sendiri. Dalam sumber yang tersedia untuk artikel ini, belum ada angka yang cukup kuat untuk memasukkannya ke ranking numerik bersama tiga model lain.
Mengapa artikel ini tidak memberi satu juara umum
Membaca benchmark LLM itu mudah menyesatkan jika angka dari sumber berbeda dicampur begitu saja. Artikel ini memakai tiga tingkat pembacaan:
Benchmark bersama dalam satu tabel: contohnya GPT-5.5 dan Claude Opus 4.7 di SWE-Bench Pro serta Terminal-Bench 2.0 pada tabel OpenAI. Ini adalah data yang paling layak dibandingkan langsung.
Ringkasan pihak ketiga atas eval vendor atau partner: contohnya SWE-Bench Verified dan CursorBench untuk Claude Opus 4.7. Tetap berguna, tetapi perlu memperhatikan siapa yang menjalankan evaluasi dan bagaimana datanya dilaporkan.
Sinyal awal atau data belum cukup: contohnya Kimi K2.6 yang punya angka kompetitif dari artikel pihak ketiga, serta DeepSeek V4 yang belum punya benchmark yang cukup dapat dikutip dalam sumber artikel ini.
Kesimpulan yang paling aman: Claude Opus 4.7 unggul atas GPT-5.5 di SWE-Bench Pro, GPT-5.5 unggul atas Claude Opus 4.7 di Terminal-Bench 2.0, Kimi K2.6 terlihat kompetitif tetapi tingkat buktinya lebih rendah, dan DeepSeek V4 sebaiknya dianggap belum cukup data.
Untuk keputusan nyata, jadikan tabel ini sebagai penyaring awal. Setelah itu, uji ulang dengan tugas Anda sendiri: jenis repositori, bahasa pemrograman, test suite, tool calling, latensi, biaya, dan cara model pulih dari kegagalan. Hasil seperti itu biasanya jauh lebih berguna daripada sekadar mencari satu pemenang di semua benchmark.
A-/B: SWE-Bench Pro dan Terminal-Bench 2.0 dapat dibandingkan langsung dengan GPT-5.5 lewat tabel OpenAI. SWE-Bench Verified dan CursorBench berguna sebagai sinyal tambahan, tetapi dalam sumber ini terutama muncul lewat ringkasan pihak ketiga; Verdent menandai Verified sebagai Anthropic-conducted dan CursorBench sebagai partner eval.
openai.comIntroducing GPT-5.5
huggingface.comoonshotai/Kimi-K2.6 - Hugging Face
blog.kilo.aiKimi K2.6 Has Arrived: An Open-Weight Powerhouse for Agentic Work
buildfastwithai.comClaude Opus 4.7: Full Review, Benchmarks & Features (2026)
verdent.aiClaude Opus 4.7: What Changed for Coding Agents (April 2026)