Postingan AI Trending & Rangkuman Riset Terbaru - Halaman 1722
DeepSeek V4 Setelah Preview: Kuat, tapi Belum Saatnya Disebut Nomor Satu
18 sumber0DeepSeek V4 telah muncul sebagai preview resmi di dokumentasi API DeepSeek pada 24 April 2026, tetapi penilaian paling aman saat ini adalah: sangat menjanjikan, belum terbukti sebagai model terbaik di dunia....
Cara mengecek akses GPT-5.5 di Spanyol
18 sumber0Tidak ada bukti jelas dari sumber yang tersedia bahwa GPT 5.5 diblokir khusus di Spanyol; jika belum muncul, penyebabnya kemungkinan terkait akun, paket, organisasi, atau kanal akses.
Cara Mencoba GPT-5.5 Gratis di ChatGPT: Cek Aksesnya dengan Benar
12 sumber0Cara resmi untuk mencoba GPT 5.5 adalah lewat ChatGPT: masuk atau daftar gratis, buka chat baru, lalu pilih GPT 5.5 jika tersedia.
Claude Opus 4.7 vs GPT-5.5: Pilih Mana untuk Agent Coding, Konteks Panjang, dan API?
21 sumber0Untuk pengadaan API, agent konteks panjang, atau deployment enterprise, Claude Opus 4.7 saat ini lebih mudah dievaluasi karena Anthropic sudah memublikasikan context window 1 juta token, tanpa long context p...
Claude Opus 4.7 vs GPT-5.5: cara membaca benchmark dan memilih untuk kerja nyata
11 sumber0Belum ada data setara yang cukup untuk menyatakan pemenang mutlak: Opus 4.7 memimpin GDPval AA dengan 1.753 Elo, sedangkan GPT 5.5 high, low, dan non reasoning mencatat 59, 51, dan 41 di Intelligence Index—d...
Claude Opus 4.7 vs GPT-5.5: Pilih Mana untuk Coding, Agen, Riset, dan Desain?
17 sumber0Claude Opus 4.7 lebih layak dicoba lebih dulu untuk coding dan agen yang banyak memakai tool: Vellum melaporkan 87,6% di SWE bench Verified dan 77,3% di MCP Atlas [3].
Claude Opus 4.7 vs GPT-5.5: Mana yang Lebih Siap untuk Enterprise?
26 sumber0Untuk PoC enterprise hari ini, Claude Opus 4.7 lebih mudah dihitung dan diuji karena sudah tersedia via Claude API, Amazon Bedrock, Google Cloud Vertex AI, dan Microsoft Foundry, dengan harga $5 per 1 juta i...
Claude Opus 4.7 vs GPT-5.5 Spud: Belum Ada Pemenang Benchmark
24 sumber0Belum ada pemenang yang bisa dinyatakan secara bertanggung jawab: Claude Opus 4.7 terverifikasi, GPT 5.5 Spud belum terverifikasi lewat sumber primer OpenAI dalam kumpulan bukti ini.
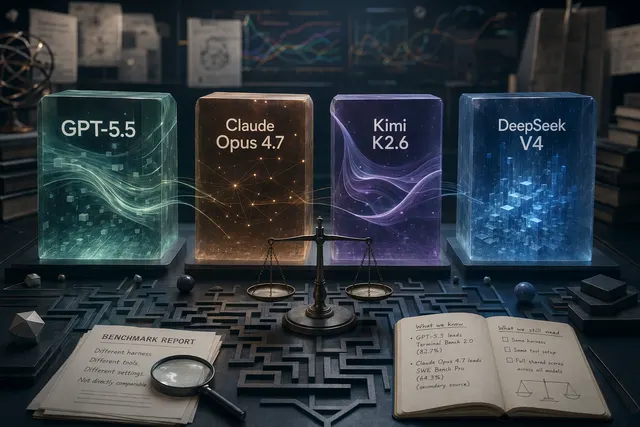
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4: Benchmark dan Cara Memilih
23 sumber0Belum ada dasar yang cukup adil untuk membuat satu peringkat total. Data yang bisa dikutip menunjukkan GPT 5.5 unggul di Terminal Bench 2.0 dengan 82,7%, sementara Claude Opus 4.7 tercatat 64,3% di SWE Bench...
Cara mencoba GPT-5.5 sekarang: status resmi di ChatGPT, Codex, dan API
15 sumber0Cara paling cepat mencoba GPT 5.5 saat ini adalah lewat ChatGPT atau Codex. Di ChatGPT, model ini sedang digulirkan bertahap untuk pengguna Plus, Pro, Business, dan Enterprise; API masih berstatus “coming so...
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: Pemenang Tiap Benchmark
24 sumber0Belum ada dasar kuat untuk menobatkan satu juara umum. GPT 5.5 memimpin Terminal Bench 2.0 dengan 82,7%, sementara Claude Opus 4.7 unggul di SWE Bench Pro 64,3% dan SWE Bench Verified 87,6%; perbandingan emp...
Benchmark Claude Opus 4.7: arti skor 87,6% di SWE-bench Verified
12 sumber0Angka utama Claude Opus 4.7 adalah 87,6% di SWE bench Verified, dilaporkan AWS berdasarkan data Anthropic; ini sinyal kuat untuk agentic coding, bukan jaminan performa universal [7].