Claude Opus 4.7 vs Opus 4.6: Apakah Sekarang Layak Upgrade?
Claude Opus 4.7 lebih tepat dibaca sebagai upgrade terarah di kelas harga Opus yang sama: LLM Stats mencantumkan rilis 16 April 2026, sementara harga yang dirangkum tetap US$5 per 1 juta token input dan US$25 per 1 ju... Peningkatan yang paling layak diuji ada di software engineering, long running agentic work, visi...
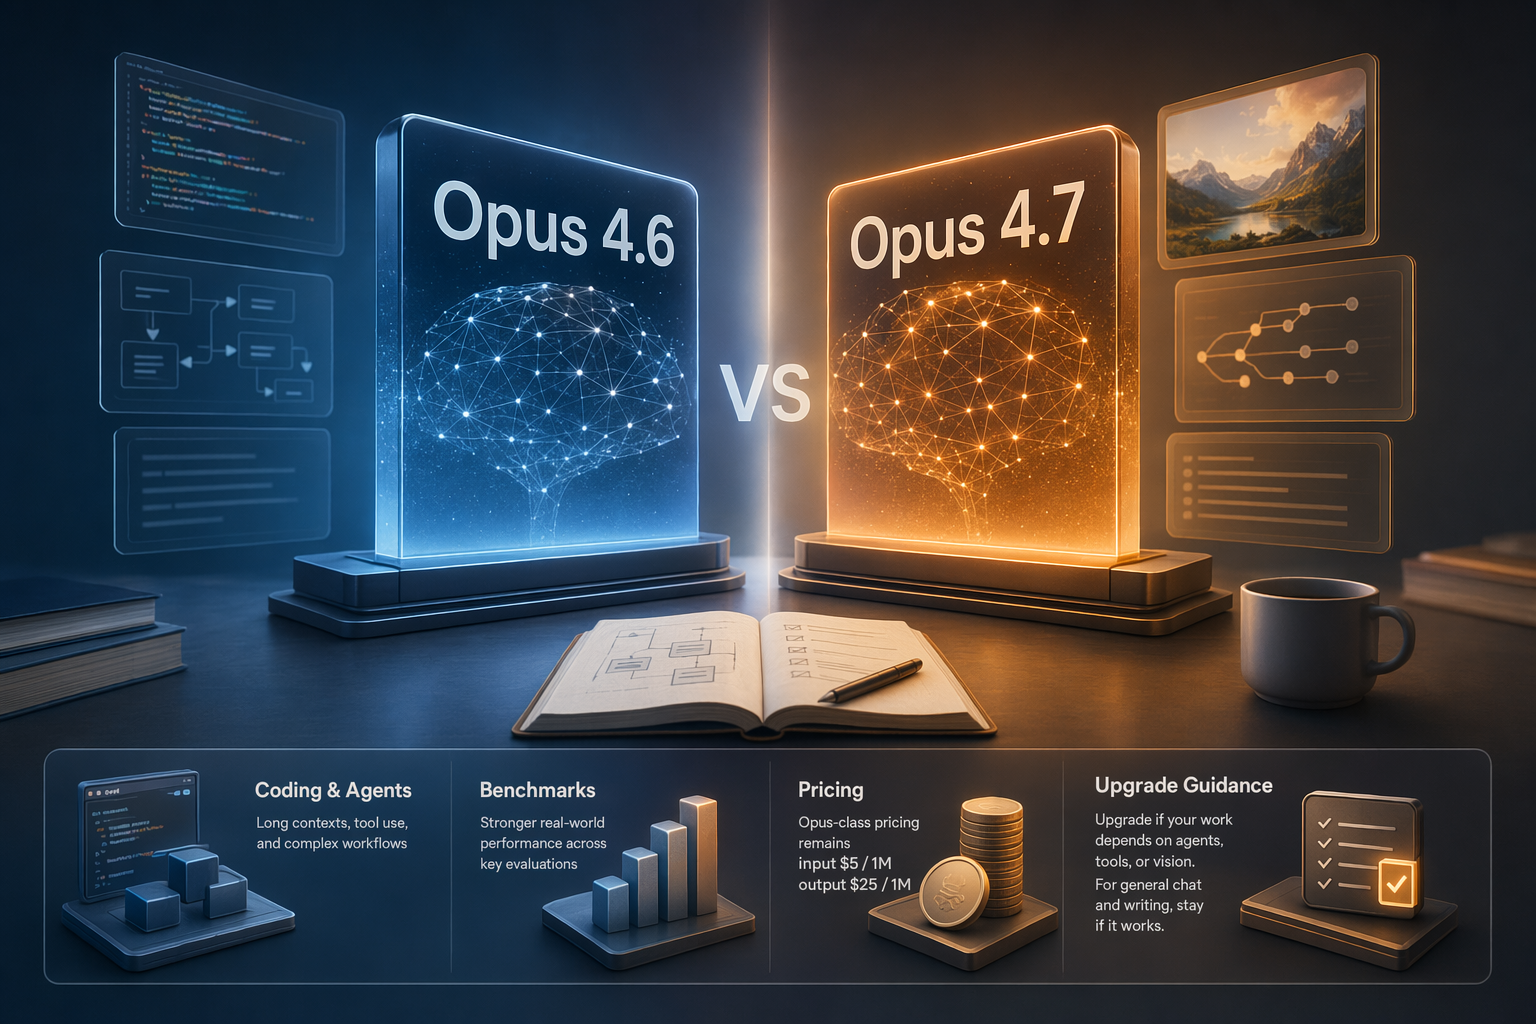
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
Claude Opus 4.7 lebih tepat dibaca sebagai upgrade terarah di kelas harga Opus yang sama: LLM Stats mencantumkan rilis 16 April 2026, sementara harga yang dirangkum tetap US$5 per 1 juta token input dan US$25 per 1 ju...
Peningkatan yang paling layak diuji ada di software engineering, long running agentic work, vision, serta kontrol seperti xhigh effort dan Task Budgets; LLM Stats mencatat skor SWE bench Verified 87,6%, naik 6,8 poin...
Namun, angka benchmark perlu dibaca hati hati karena sebagian besar berasal dari laporan Anthropic sendiri, sementara beberapa contoh mitra seperti Notion dan Rakuten bukan eksperimen publik yang terkontrol.[3][6]
Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議AI 生成的 Claude Opus 4.7 vs Opus 4.6 比較主視覺。
AI Perintah
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議. Article summary: Claude Opus 4.7 在 2026 04 16 上線,公開資料顯示 Opus 級價格仍是每百萬 input $5、output $25;若你做 coding agent、長流程工具調用或視覺理解,值得優先試升,但一般聊天或文案不必只為版本號遷移。[6][8][9]. Topic tags: ai, anthropic, claude, llm, ai agents. Reference image context from search candidates: Reference image 1: visual subject "# Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade Now? A route-first upgrade guide that compares Claude Opus 4.7 and Claude Opus 4.6 through workflow fit, benchmark" source context "Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade ..." Reference image 2: visual subject "# Claude Opus 4.7 vs Opus 4.6. Head-to-head comparison of Claude Opus 4.7 vs Opus 4.6: benchmark deltas, pricing, effort levels, vision, tokenizer, and a migration checklist. Opus" source
openai.com
Jawaban pendeknya: Claude Opus 4.7 layak masuk daftar uji coba, tetapi belum tentu harus langsung menggantikan Opus 4.6 di semua workflow. Nilai utamanya ada pada pekerjaan engineering yang sulit, agent yang menjalankan banyak langkah, dan input visual seperti screenshot UI, diagram teknis, tabel, atau dokumen hasil pindai. Anthropic menempatkan 4.7 sebagai model yang lebih kuat untuk advanced software engineering, long-running tasks, dan vision; LLM Stats juga menyebutnya sebagai direct upgrade dari Opus 4.6 dengan harga token yang sama.
Kalau Anda sudah memakai Opus 4.6 untuk coding agent, analisis repo, bug fixing, refactor multi-file, tool calling bertahap, atau pemahaman gambar, Opus 4.7 sebaiknya diuji dalam waktu dekat. Tetapi kalau pemakaian utama hanya chat umum, ringkasan, terjemahan, atau copywriting ringan, bukti publik yang tersedia belum cukup untuk menyimpulkan bahwa migrasi penuh akan selalu terasa lebih baik.
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "Claude Opus 4.7 vs Opus 4.6: Apakah Sekarang Layak Upgrade?"?
Claude Opus 4.7 lebih tepat dibaca sebagai upgrade terarah di kelas harga Opus yang sama: LLM Stats mencantumkan rilis 16 April 2026, sementara harga yang dirangkum tetap US$5 per 1 juta token input dan US$25 per 1 ju...
Apa poin penting yang harus divalidasi terlebih dahulu?
Claude Opus 4.7 lebih tepat dibaca sebagai upgrade terarah di kelas harga Opus yang sama: LLM Stats mencantumkan rilis 16 April 2026, sementara harga yang dirangkum tetap US$5 per 1 juta token input dan US$25 per 1 ju... Peningkatan yang paling layak diuji ada di software engineering, long running agentic work, vision, serta kontrol seperti xhigh effort dan Task Budgets; LLM Stats mencatat skor SWE bench Verified 87,6%, naik 6,8 poin...
Apa yang harus saya lakukan selanjutnya dalam latihan?
Namun, angka benchmark perlu dibaca hati hati karena sebagian besar berasal dari laporan Anthropic sendiri, sementara beberapa contoh mitra seperti Notion dan Rakuten bukan eksperimen publik yang terkontrol.[3][6]
Ringkasnya: apa yang berubah dari Opus 4.6 ke 4.7?
Aspek
Perubahan yang tercatat di sumber publik
Artinya untuk keputusan upgrade
Rilis dan ketersediaan
LLM Stats mencantumkan tanggal rilis Opus 4.7 pada 16 April 2026; halaman Anthropic menunjukkan developer dapat memakai claude-opus-4-7 melalui Claude API.
Model ini sudah bisa direncanakan untuk pengujian teknis, bukan sekadar pengumuman.
Harga
LLM Stats menyebut Opus 4.7 sebagai direct upgrade dari Opus 4.6 dengan harga tetap US$5 per 1 juta token input dan US$25 per 1 juta token output.
Biaya per token tidak naik, tetapi tagihan akhir tetap bergantung pada panjang output, retry, dan desain workflow.
Coding dan software engineering
Anthropic menyoroti peningkatan untuk advanced software engineering, terutama tugas yang sulit; LLM Stats mencatat SWE-bench Verified 87,6%, naik 6,8 poin persentase dari 4.6.
Paling menarik untuk tim yang memakai Claude sebagai coding agent, reviewer kode, atau asisten perbaikan bug.
Agent jangka panjang
LLM Stats menyebut adanya peningkatan self-verification untuk long-running agentic work; Anthropic juga menyebut long-running tasks sebagai area peningkatan.
Vision
Anthropic menyatakan vision 4.7 lebih baik dan dapat menangani gambar beresolusi lebih tinggi; LLM Stats merangkum dukungan resolusi gambar sekitar 3,3× lebih tinggi.
Kontrol baru
Ringkasan pihak ketiga menyebut xhigh effort dan fitur Task Budgets yang lebih relevan untuk agent serta coding.
Benchmark: arahnya jelas, tetapi jangan ditarik terlalu jauh
Data benchmark publik memberi sinyal yang cukup konsisten: Opus 4.7 diarahkan untuk menangani coding yang lebih sulit, workflow agentic, dan vision. LLM Stats menyebut Opus 4.7 mencapai 87,6% di SWE-bench Verified, naik 6,8 poin persentase dibanding Opus 4.6, dan menang atas 4.6 pada 12 dari 14 benchmark yang dilaporkan.
Namun, angka seperti ini tetap perlu dibaca dengan kacamata kritis. LLM Stats sendiri mengingatkan bahwa benchmark tersebut merupakan self-reported benchmark dari Anthropic. Verdent AI juga mencatat bahwa contoh Notion dan Rakuten yang dikutip dalam peluncuran Anthropic adalah konteks internal mitra atau benchmark proprietary, bukan evaluasi publik terkontrol yang bisa langsung digeneralisasi ke semua penggunaan.
Jadi, benchmark mendukung kesimpulan bahwa Opus 4.7 kemungkinan lebih kuat untuk coding sulit, agent jangka panjang, dan vision resolusi tinggi. Tetapi benchmark belum cukup untuk menyimpulkan bahwa setiap prompt, format output, atau workflow produksi yang berjalan baik di Opus 4.6 pasti otomatis membaik di 4.7.
Harga: token sama, biaya akhir belum tentu sama
Dari rangkuman LLM Stats, Opus 4.7 memakai harga yang sama dengan Opus 4.6 di kelas Opus: US$5 per 1 juta token input dan US$25 per 1 juta token output. Ini membuat uji coba relatif lebih mudah dibenarkan karena Anda tidak perlu langsung menerima kenaikan harga per token.
Tetapi untuk penggunaan produksi, angka token price bukan satu-satunya biaya. Model yang lebih kuat bisa saja menghasilkan jawaban lebih panjang, memakai effort lebih tinggi, atau memicu pola tool calling yang berbeda. Sebaliknya, kalau 4.7 mengurangi retry, human correction, atau error pada tool, biaya per tugas justru bisa turun.
Cara paling sehat adalah menghitung biaya untuk menyelesaikan satu tugas, bukan hanya biaya per 1 juta token. Untuk tim engineering, metrik seperti waktu review manusia, jumlah patch yang benar, keberhasilan test, tool error, retry, dan latency sering kali lebih penting daripada harga token mentah.
Siapa yang sebaiknya menguji Opus 4.7 lebih dulu?
Beberapa kelompok pengguna punya alasan kuat untuk segera memasukkan Opus 4.7 ke eksperimen A/B:
Tim software engineering dan coding agent. Jika Opus 4.6 sudah dipakai untuk analisis repo, bug fixing, test repair, refactor multi-file, atau code review, area peningkatan 4.7 memang paling dekat dengan kebutuhan ini.
Workflow agent dengan banyak langkah. Jika agent Anda harus membuat rencana, memanggil tool, mengecek hasil, memperbaiki kesalahan, lalu melanjutkan proses selama banyak putaran, peningkatan pada long-running agentic work layak diuji.
Produk atau operasi yang mengandalkan gambar. Kalau input Anda sering berupa screenshot UI, tabel, dokumen scan, diagram teknis, atau desain, peningkatan vision dan resolusi gambar bisa lebih terasa daripada pada chat teks biasa.
Tim yang sudah nyaman membayar harga kelas Opus. Karena harga per token 4.7 dan 4.6 dirangkum sama, hambatan awal untuk melakukan pilot test lebih rendah.
Siapa yang bisa menunggu dulu?
Jika penggunaan utama Anda adalah chat umum, ringkasan dokumen sederhana, terjemahan, brainstorming, atau copywriting ringan, tidak ada alasan kuat untuk migrasi penuh hanya karena nomor versi lebih baru. Bukti publik yang tersedia lebih banyak membahas coding, agent, dan vision; untuk tugas konten harian, belum ada dasar yang cukup kuat untuk menjanjikan peningkatan yang sama besar.
Anda juga sebaiknya berhati-hati jika prompt produksi sudah lama disetel khusus untuk Opus 4.6. Model baru bisa mengubah gaya jawaban, kepatuhan format, panjang output, atau jenis kesalahan yang muncul. Dalam kasus seperti ini, upgrade sebaiknya dilakukan bertahap, bukan sekali pindah semua.
Checklist A/B test sebelum migrasi
Daripada langsung mengganti semua pemanggilan Opus 4.6 dengan 4.7, jalankan pengujian dengan data kerja nyata:
Ambil sampel tugas yang representatif. Sertakan kasus yang biasanya berhasil, kasus yang sering gagal di 4.6, tugas panjang, dan tugas bernilai tinggi.
Kunci prompt dan tool environment. Selain versi model, usahakan variabel lain tetap sama agar perubahan hasil tidak keliru dibaca sebagai peningkatan model.
Ukur hasil secara kuantitatif. Catat success rate, waktu koreksi manusia, jumlah tool error, token input/output, retry, dan latency.
Pisahkan pengujian xhigh effort.xhigh disebut sebagai kontrol baru yang terkait Opus 4.7, tetapi belum tentu cocok untuk semua tugas; bandingkan terpisah dari setting normal.
Uji vision dengan gambar asli. Jika vision penting, gunakan screenshot, diagram, tabel, atau dokumen scan dari workflow nyata, bukan hanya contoh gambar sederhana.
Siapkan fallback ke Opus 4.6. Untuk produksi, mulai dari traffic kecil, pantau kualitas dan biaya, lalu naikkan bertahap jika hasilnya stabil.
Rekomendasi akhir
Untuk pengguna engineering, agent, dan vision, Claude Opus 4.7 adalah kandidat upgrade prioritas tinggi. Peningkatan yang dilaporkan memang berada di area tersebut, dan harga per token yang sama membuat uji coba lebih masuk akal.
Untuk pengguna chat umum, ringkasan, dan pembuatan konten ringan, jangan upgrade hanya karena versi baru. Opus 4.7 mungkin tetap lebih baik dalam beberapa kasus, tetapi bukti publik belum cukup untuk menjamin migrasi penuh akan selalu memberi hasil lebih baik daripada Opus 4.6.
Kesimpulan praktisnya: perlakukan Opus 4.7 sebagai upgrade yang perlu diuji serius, bukan pengganti otomatis. Jalankan A/B test dengan tugas nyata, ukur kualitas, format, biaya, dan latency, lalu putuskan apakah layak dipakai penuh.
llm-stats.comClaude Opus 4.7: Benchmarks, Pricing, Context & What's New
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
verdent.aiClaude Opus 4.7 vs 4.6: Agentic Coding Comparison - Verdent AI
help.apiyi.comClaude Opus 4.7 VS 4.6 Comprehensive Comparison