熱門 - 第 1708 頁
GPT-5.5、Claude Opus 4.7、DeepSeek V4、Kimi K2.6:公開基準測試怎麼讀
15 個來源0目前最能四方對齊的公開項目是 Terminal Bench 2.0:GPT 5.5 為 82.7%,Claude Opus 4.7 為 69.4%,DeepSeek V4 Pro Max 為 67.9%,Kimi K2.6 Thinking 為 66.7%;但這只是單項比較,不是總榜。[29][30][6]
GPT-5.5 基準測試怎麼看:84.9% GDPval 代表什麼
10 個來源0最適合作為短答的 GPT 5.5 基準測試數字,是 OpenAI 公布的 84.9% GDPval;GDPval 評估 AI 代理在 44 種職業中完成規格明確知識工作的能力。[1]
GPT-5.5 vs Claude Opus 4.7:寫程式 GPT-5.5 佔優,設計與創作仍難定勝負
19 個來源0公開資料下,程式開發是 GPT 5.5 優勢最明確的項目;Terminal Bench 82.7% 報導與 SWE Bench Verified 的工具使用、檔案瀏覽表現是主要依據。
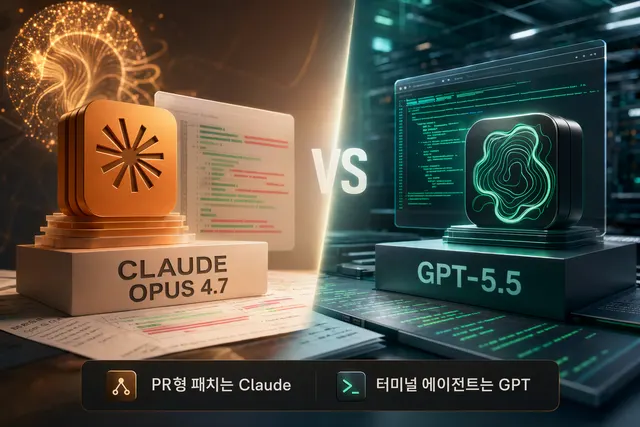
Claude Opus 4.7 vs GPT-5.5 寫程式比較:PR 修補選 Claude,終端機代理選 GPT
12 個來源0沒有絕對勝者。SWE Bench Pro 中 Claude Opus 4.7 以 64.3% 對 58.6% 領先 GPT 5.5;但 Terminal Bench 2.0 中 GPT 5.5 以 82.7% 對 69.4% 領先 Opus 4.7,所以 PR 型修補先測 Claude,終端機代理式工作先測 GPT 較合理 [3][6]。
Leonardo AI 是什麼?功能、價格與商用授權一次看懂
8 個來源0Leonardo AI 是以文字提示生成圖像、材質與概念美術的 AI 設計平台;平台內的 token 不只用於生圖,也可能用在影片生成、去背與放大等後製工作 [7][8]。
Claude Code vs. OpenAI Codex:別追熱度,先看你的開發流程
15 個來源0想在既有程式碼庫裡邊做邊改、開發者隨時接手方向,Claude Code 通常是較自然的起點。
2025 台灣 AI 熱門研究主題:行銷人與工程師該追的 9 個方向
12 個來源02025 年台灣企業 AI 投資年增 39%,平均由 819 萬元升到 1,140 萬元;但公開資料沒有行銷人/工程師官方排行,較可靠的判讀是:焦點正從單次生成轉向 Agent、RAG、多模態、AIOps 與多模型部署。[1][4][6]
OpenAI 2026 模型總整理:ChatGPT、API、Codex 與退役名單
24 個來源02026 年 ChatGPT 可驗證重點包括 GPT 5.4 Thinking/Pro、GPT 5.3 Instant、GPT 5.4 mini,以及方案文件中的 GPT 5.2 相關列。
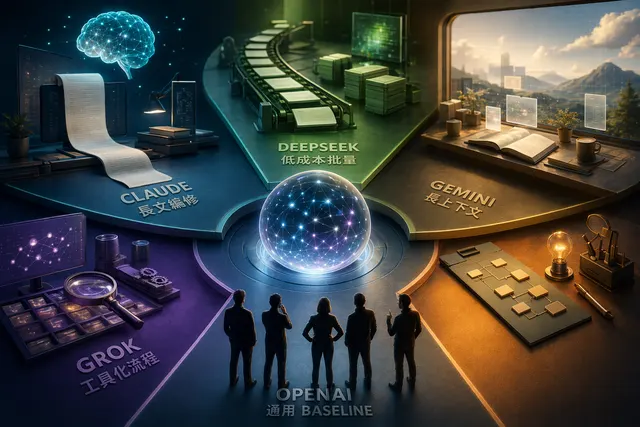
內容行銷 AI 模型比較:OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼分工
18 個來源0以 2026 年公開價格與規格資料來看,沒有足夠證據證明 OpenAI、Claude、DeepSeek、Gemini 或 Grok 是內容行銷的單一冠軍;更務實的分工是 OpenAI 做通用 baseline、Claude 測長文與品牌編修、DeepSeek 跑低成本批量、Gemini 處理長上下文、Grok 評估工具化 pipeline。
香港 AI 搜尋引用來源前十名:目前沒有可驗證榜單
15 個來源0目前沒有公開、可重複驗證的「香港 AI 搜尋引用來源前十名」;現有資料只能確認 Wikipedia、Reddit、LinkedIn、YouTube 等在部分 AI 引用研究中高頻出現,香港榜單仍需按平台、語言、查詢集與日期實測。[1][4]
台灣 AI 工具比較 SEO:2025 優先布局的 10 個產品對比題
12 個來源0目前沒有公開資料直接公布台灣 AI 工具「比較型關鍵字」前 10 名;較可靠的做法,是用 Google 2025 台灣快速竄升 AI 工具與 DailyView 討論度作為 proxy,優先布局 ChatGPT vs Gemini、ChatGPT vs Claude、ChatGPT vs Perplexity 等選型題,但必須標示為推估而非官方排名。[9][5]