トレンドAI投稿と注目リサーチのキャッチアップ - ページ1719
GPT-5.5とClaude Opus 4.7、開発で選ぶなら?用途別に見る実務的な答え
18 ソース0ターミナルでコマンド実行、ログ確認、修正、再テストを回す開発エージェント用途では、GPT 5.5を先に試す価値があります。Terminal Bench 2.0で82.7%と報告され、Claude Opus 4.7の69.4%を上回っています。[6][31]
GPT-5.5 vs Claude Opus 4.7:コード修正はClaude、CLIエージェントはGPTが有力
19 ソース0既存コードのバグ修正やテスト通過、PR向けパッチ作成なら、まずClaude Opus 4.7を試すのが自然です。SWE bench ProではClaude Opus 4.7が64.3%、GPT 5.5が58.6%と整理されています。[16][29]
DeepSeekの使い方:Web・アプリで試し、API連携まで進める手順
23 ソース0DeepSeekは公式サイトの「Start Now」や公式アプリからすぐ試せます。開発者はAPIキーを作成し、Bearer認証でOpenAI互換の/chat/completionsを呼び出すのが基本です。[24][23][1][12][13]
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6:用途別ベンチマーク比較
24 ソース04モデルを完全同一条件で横比較した決定版ランキングとしては読まず、用途別に選ぶのが安全です。総合・経済タスクはGPT 5.5、推論・レビューはClaude Opus 4.7、オープンウェイトの速度はKimi K2.6、長文脈と低API価格はDeepSeek V4 Proが有力です。[4][23][26][27]
GPT-5.5はどれくらい強い?公開ベンチマークで見る実力と弱点
16 ソース0GPT 5.5は総合最強候補の一つです。Terminal Bench 2.0で82.7、FrontierMath Tier 1–3で51.7と強い一方、SWE Bench ProではClaude Opus 4.7、BrowseCompではGemini 3.1 ProやMythos Previewが上回ります。[6][10]
GPT-5.5、Claude Opus 4.7、Kimi K2.6、DeepSeek V4比較:ベンチマークの読み方
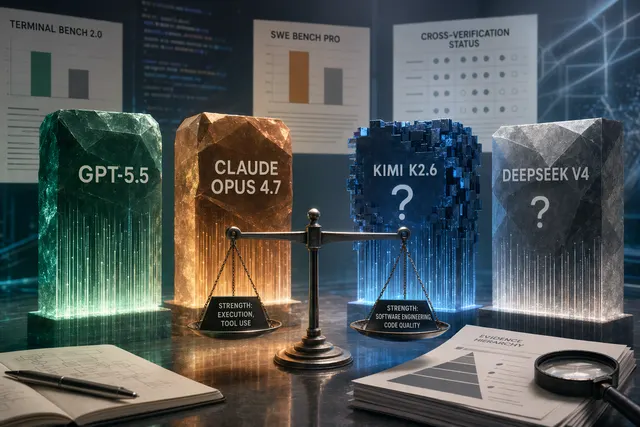
16 ソース0同じOpenAI評価表で直接比較しやすいのはGPT 5.5とClaude Opus 4.7。SWE Bench ProはClaude Opus 4.7が64.3%でGPT 5.5の58.6%を上回り、Terminal Bench 2.0はGPT 5.5が82.7%でClaude Opus 4.7の69.4%を上回ります。[21]
Kimi K2.6レビュー:コーディングは有力、万能AIと見るにはまだ早い
12 ソース0Kimi K2.6はコーディング用途で強いシグナルがある。MLQ.aiはSWE Bench Proで58.6、SWE bench Verifiedで65.8% pass@1と報告しているが、独立評価はまだ暫定的との指摘もある [8][9]。
Kimi K2.6はGPT-5.5、Gemini、Claudeに勝てるのか:開発者視点の結論
23 ソース0Kimi K2.6は低コストなコーディングエージェント候補です。OpenRouterでは262,144トークンのコンテキストと、100万入力トークン0.75ドル、100万出力トークン3.50ドルの単価が掲載されています[26]。
GPT-5.5 vs Claude Opus 4.7:用途別比較と選び方
21 ソース0少ない指示で調査・コード・文書作成まで進めたいならGPT 5.5、1Mコンテキストで長いコード/エージェント作業を回したいならClaude Opus 4.7が有力です。ただし根拠は主に公式資料・報道で、同条件の独立ベンチマークではありません。[1][3][13][26]
DeepSeek V4の暫定評価:フロンティア級に近いが「世界最高」はまだ早い
18 ソース0DeepSeek V4は2026年4月24日に公式APIドキュメントでプレビュー公開が確認された有望モデルですが、現時点の妥当な評価は「かなり優秀そうだが、世界最高とは未確定」です。コーディング、長文処理、価格効率が注目点で、リーク由来のベンチマークは慎重に扱うべきです。[13][1][8]
GPT-5.5はスペインで使える?確認すべき3つの場所
18 ソース0提供された資料の範囲では、スペインだけがGPT 5.5から明確に除外されている根拠は見当たりません。表示されない場合は、アカウント、プラン、組織、利用チャネルごとの差をまず確認しましょう。
GPT-5.5を無料で試すには?ChatGPTで確認する正しい手順
12 ソース0正規の確認ルートはChatGPTです。無料アカウントでサインインし、新しいチャットでGPT 5.5が選べるか確認します [9][3]。