ट्रेंडिंग AI पोस्ट और हॉट रिसर्च कैचअप - पेज 1723
GPT-5.5 कितना ताकतवर है? बेंचमार्क से दिखती ताकत और सीमाएं
16 स्रोत0GPT 5.5 फ्रंटियर AI मॉडलों में शीर्ष दावेदारों में है। Terminal Bench 2.0 में 82.7 और FrontierMath Tier 1–3 में 51.7 जैसे स्कोर इसकी मजबूती दिखाते हैं।[6][10]
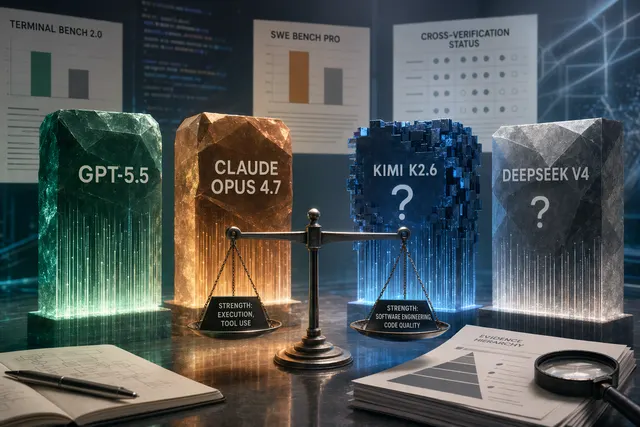
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4: बेंचमार्क की असली तस्वीर
16 स्रोत0OpenAI की एक ही तुलना तालिका में Claude Opus 4.7 का SWE Bench Pro स्कोर 64.3% है, जबकि GPT 5.5 का 58.6%; वहीं Terminal Bench 2.0 में GPT 5.5 82.7% और Claude 69.4% पर है। इसलिए एकल विजेता घोषित करना ठीक नहीं।...
Kimi K2.6 रिव्यू: कोडिंग में तेज, पर हर काम का AI अभी नहीं
12 स्रोत0Kimi K2.6 को Moonshot AI का अप्रैल 2026 रिलीज़ बताया गया है, जिसका फोकस coding, long horizon task execution और multi agent capabilities पर है [1][4][6][7].
Kimi K2.6 बनाम GPT-5.5, Gemini 2.5 Pro और Claude: डेवलपर फैसला
23 स्रोत0Kimi K2.6 को GPT 5.5, Gemini 2.5 Pro या Claude का सीधा universal replacement नहीं, बल्कि कम लागत वाले coding agent model के रूप में परखना ज्यादा सही है [7][26].
GPT-5.5 बनाम Claude Opus 4.7: काम करवाना है या लंबा एजेंट चलाना?
21 स्रोत0कम निर्देशों से शोध, विश्लेषण, कोड और दस्तावेज़ तक काम बढ़वाना है तो GPT 5.5 पहले आज़माने लायक है; लंबे कॉन्टेक्स्ट और एजेंट वर्कफ़्लो के लिए Claude Opus 4.7 मजबूत दावेदार है।[1][3][13][26]
DeepSeek V4 की शुरुआती परीक्षा: ताकतवर संकेत, पर दुनिया का नंबर 1 कहना जल्दबाज़ी
18 स्रोत0DeepSeek API Docs में 24 अप्रैल 2026 को DeepSeek V4 Preview Release दर्ज है, इसलिए V4 के प्रिव्यू चरण में आने की आधिकारिक पुष्टि मिलती है।[13]
स्पेन में GPT-5.5 मिला या नहीं? ChatGPT, Codex और API में ऐसे जांचें
18 स्रोत0उपलब्ध स्रोत GPT 5.5 की System Card और अलग अलग चैनलों में rollout की बात दिखाते हैं [23][10][13][14]; स्पेन के लिए अलग रोक का साफ़ संकेत नहीं मिलता।
ChatGPT में GPT-5.5 मुफ्त कैसे आज़माएँ: सही access check करने का तरीका
12 स्रोत0सही शुरुआत ChatGPT है: sign in करें या free account बनाएँ, new chat खोलें और GPT 5.5 option दिखे तो select करें [9][3].
Claude Opus 4.7 बनाम GPT-5.5: लंबे कॉन्टेक्स्ट, एजेंटिक कोडिंग और API में किसे चुनें
21 स्रोत0API खरीद, लंबे कॉन्टेक्स्ट वाले agent या एंटरप्राइज डिप्लॉयमेंट के लिए Claude Opus 4.7 अभी सीधे मूल्यांकन योग्य दिखता है: 1M context window, standard API pricing में no long context premium, multi cloud avai...
Claude Opus 4.7 बनाम GPT-5.5: बेंचमार्क कैसे पढ़ें, सही मॉडल कैसे चुनें
11 स्रोत0अभी ऐसा समान शर्त benchmark नहीं है जिससे Claude Opus 4.7 या GPT 5.5 को हर मामले में विजेता घोषित किया जा सके: Opus 4.7 GDPval AA में 1,753 Elo पर नया leader है, जबकि GPT 5.5 high, low और non reasoning के Ar...
Claude Opus 4.7 बनाम GPT-5.5: कोडिंग, एजेंट, रिसर्च और डिजाइन के लिए कौन-सा AI मॉडल बेहतर?
17 स्रोत0कोडिंग और tool heavy agents के लिए Claude Opus 4.7 को पहले आजमाने का आधार ज्यादा मजबूत है: Vellum ने SWE bench Verified पर 87.6% और MCP Atlas पर 77.3% रिपोर्ट किया है।
Claude Opus 4.7 बनाम GPT-5.5: enterprise deployment से पहले API, लागत और सबूत
26 स्रोत0आज enterprise API PoC शुरू करना है तो Claude Opus 4.7 की deployment जानकारी ज्यादा पूरी है: Claude API, Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry, 1M context और $5/$25 प्रति 10 लाख input/outp...