ट्रेंडिंग AI पोस्ट और हॉट रिसर्च कैचअप - पेज 1724
Claude Opus 4.7 बनाम GPT-5.5 Spud: विजेता अभी साबित नहीं
24 स्रोत0उपलब्ध प्रमाणों में Claude Opus 4.7 सत्यापित है, लेकिन GPT 5.5 Spud के लिए यहां कोई प्राथमिक OpenAI मॉडल कार्ड, रिलीज़ नोट या API दस्तावेज़ नहीं है।
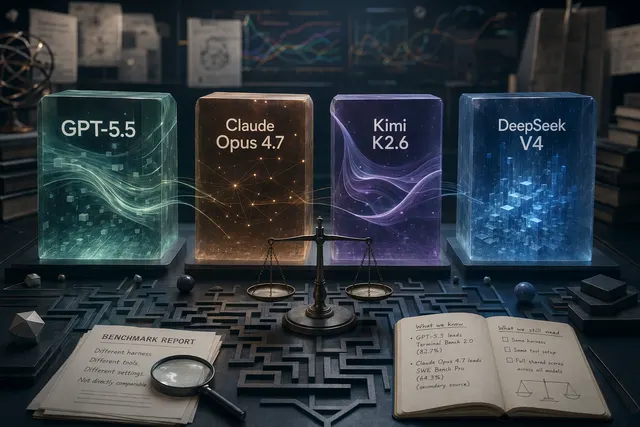
GPT-5.5, Claude Opus 4.7, Kimi K2.6 और DeepSeek V4-Pro: बेंचमार्क से सही मॉडल कैसे चुनें
23 स्रोत0अभी इन चारों मॉडलों का निष्पक्ष overall winner निकालना ठीक नहीं है, क्योंकि उपलब्ध स्कोर अलग अलग स्रोतों, tool settings और effort variants से आते हैं। फिर भी GPT 5.5 का Terminal Bench 2.0 स्कोर 82.7% है, जबक...
GPT-5.5 अभी कैसे आज़माएँ: ChatGPT, Codex और API की स्थिति
15 स्रोत0GPT 5.5 को अभी आज़माने का व्यावहारिक रास्ता ChatGPT या Codex है; OpenAI API दस्तावेज़ों में API उपलब्धता अभी ‘coming soon’ बताई गई है।[1][20]
GPT-5.5 बनाम Claude Opus 4.7 बनाम DeepSeek V4 बनाम Kimi K2.6: हर काम का विजेता अलग
24 स्रोत0सार्वजनिक बेंचमार्क के आधार पर एक समग्र नंबर 1 घोषित करना जल्दबाजी होगी: GPT 5.5 Terminal Bench 2.0 पर 82.7% के साथ टर्मिनल एजेंट कोडिंग में मजबूत दिखता है, जबकि Claude Opus 4.7 SWE Bench Pro 64.3% और SWE Be...
Claude Opus 4.7 बेंचमार्क: SWE-bench Verified में 87.6% का मतलब
12 स्रोत0Claude Opus 4.7 की सबसे चर्चित संख्या SWE bench Verified में 87.6% है, जिसे AWS ने Anthropic के डेटा के आधार पर रिपोर्ट किया है; यह एजेंटिक कोडिंग के लिए मजबूत संकेत है, सार्वभौमिक प्रदर्शन की गारंटी नहीं [7]।
Claude Opus 4.7 बेंचमार्क: 87.6% SWE-bench, 94.2% GPQA — आंकड़े कितने भरोसेमंद हैं?
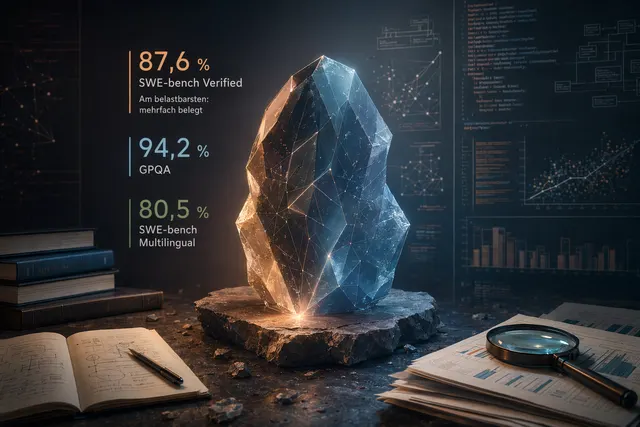
16 स्रोत0Claude Opus 4.7 के लिए सार्वजनिक रूप से सबसे प्रमुख आंकड़े हैं: SWE bench Verified पर 87.6%, GPQA पर 94.2% और SWE bench Multilingual पर 80.5%; इनमें SWE bench Verified सबसे बेहतर तरीके से पुष्ट दिखता है।
Claude Mythos Preview: SWE-bench पर 93.9% स्कोर का असली मतलब
17 स्रोत0Claude Mythos Preview का सबसे चर्चित आंकड़ा SWE bench पर 93.9% है, जो सॉफ्टवेयर इंजीनियरिंग और कोड संबंधी कार्यों के लिए महत्वपूर्ण है [1][2].
Claude Mythos बेंचमार्क: 93.9% SWE-bench, लेकिन तुलना इतनी सीधी नहीं
17 स्रोत0Claude Mythos Preview का सबसे चर्चित reported score SWE bench Verified पर 93.9% है; लेकिन Anthropic इसे Project Glasswing का invitation only research preview बताता है, self serve model नहीं।[6][13]
Kimi K2.6 vs DeepSeek V4 vs GPT-5.5 vs Claude Opus 4.7: बेंचमार्क, कीमत और सही चुनाव
20 स्रोत0एक सार्वभौमिक विजेता नहीं दिखता: कठिन tasks में Claude Opus 4.7 सबसे मजबूत संकेत देता है, GPT 5.5 Terminal Bench 2.0 में आगे है, जबकि Kimi और DeepSeek लागत के हिसाब से फैसले बदल देते हैं [3][4][7][16].
GPT-5.5 बनाम Claude Opus 4.7: बेंचमार्क, कीमत और सही मॉडल चुनने की गाइड
17 स्रोत0LLM Stats के अनुसार 10 साझा benchmarks में Claude Opus 4.7 ने 6 और GPT 5.5 ने 4 में बढ़त दिखाई, लेकिन ये scores अधिकतर providers के self reported high reasoning tier पर आधारित हैं।[3]
GPT-5.5 बनाम DeepSeek V4: बेंचमार्क, कोडिंग, एजेंटिक टास्क और कीमत
19 स्रोत0अभी उपलब्ध सार्वजनिक डेटा किसी एक मॉडल को हर मामले में विजेता नहीं बनाता: BenchLM में DeepSeek V4 Flash High coding average में 72.2 बनाम 58.6 आगे है, जबकि GPT 5.5 agentic tasks में 81.8 बनाम 55.4 आगे है [13]।
GPT-5.5 vs Claude Opus 4.7: कोड फिक्स में Claude, टर्मिनल एजेंट में GPT पहले टेस्ट करें
17 स्रोत0कोई सार्वभौमिक विजेता नहीं: SWE Bench Pro में Claude Opus 4.7 64.3% बनाम GPT 5.5 58.6% पर आगे है, जबकि Terminal Bench 2.0 में GPT 5.5 82.7% बनाम 69.4% से आगे है। ये third party side by side scores शुरुआती sh...