Trendende KI-Beiträge & schnelle Research-Updates - Seite 1732
OpenAI Codex vs. Claude Code: Lokale Entwicklung, PR-Automation und Kosten
24 Quellen0Für lange Debugging , Refactoring und Testläufe im lokalen Repository wirkt Claude Code natürlicher; für PR Review, Slack, mehrere Oberflächen und Cloud Aufgaben ist OpenAI Codex direkter aufgestellt.
Claude Code vs. OpenAI Codex: Welches KI-Coding-Tool passt zu Ihrem Team?
19 Quellen0Claude Code ist in den verfügbaren Quellen der besser dokumentierte Fit für codebase bewusste Repository Arbeit und granulare lokale Berechtigungen.
GPT-5.5 vs. Claude Opus 4.7, DeepSeek V4 und Kimi K2.6: Benchmarks, Preise und beste Einsätze
22 Quellen0GPT 5.5 hat das stärkste Gesamtsignal: Artificial Analysis listet GPT 5.5 xhigh mit 60 und high mit 59; Claude Opus 4.7 folgt mit 57.[2]
Claude Opus 4.7, GPT-5.5, DeepSeek V4 und Kimi K2.6 im Vergleich: Was wirklich belegt ist
29 Quellen0Ein seriöser Gesamtsieger lässt sich aus den verfügbaren öffentlichen Quellen nicht ableiten: Die Benchmark und Spezifikationslage ist zu uneinheitlich.
GPT-5.5, Claude Opus 4.7, DeepSeek V4 und Kimi K2.6 im Benchmark: Welches Modell passt zu welchem Job?
17 Quellen0Kein eindeutiger Gesamtsieger: Claude Opus 4.7 führt GPQA Diamond mit 94,2 % und HLE ohne Tools mit 46,9 % an, GPT 5.5 Pro HLE mit Tools mit 57,2 % und BrowseComp mit 90,1 %, GPT 5.5 Terminal Bench 2.0 mit 8...
Claude Opus 4.7, GPT-5.5, DeepSeek V4, Kimi K2.6: Warum 2026 kein Benchmark-Sieger reicht
26 Quellen0Eine saubere Rangliste von Platz 1 bis 4 lässt sich aus den öffentlichen Daten nicht ableiten: BenchLM, Vals AI, Herstellerangaben und interne Benchmarks messen unterschiedliche Dinge [3][28][31].
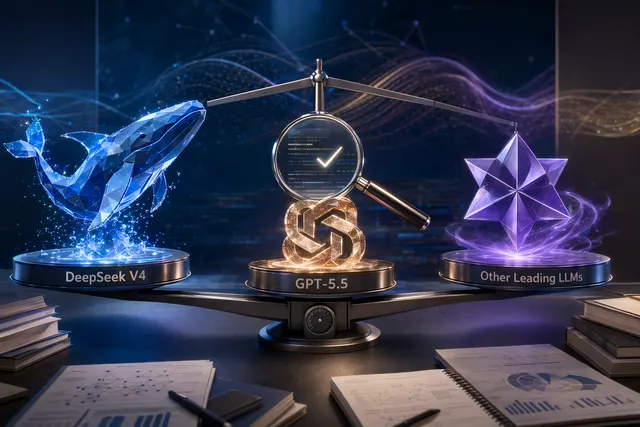
DeepSeek V4 vs. GPT-5.5: Welche Benchmarks zählen wirklich?
21 Quellen0GPT 5.5 ist derzeit leichter für API Production einzuschätzen: OpenAI nennt Modell ID, 1 Mio.
GPT‑5.5 vs. Claude Opus 4.7: Welche Benchmarks zählen wirklich?
20 Quellen0Kein eindeutiger Sieger: GPT‑5.5 liegt bei Terminal Bench 2.0 klar vorn, Claude Opus 4.7 bei SWE Bench Pro.
GPT-5.5, Claude Opus 4.7, DeepSeek V4 und Kimi K2.6 im Vergleich
19 Quellen0Eine seriöse Gesamtkrone lässt sich aus den öffentlichen Daten nicht ableiten: GPT 5.5 liegt im sichtbaren Intelligence Index mit 60/59 sowie bei BrowseComp und Terminal Bench 2.0 vorn, Claude Opus 4.7 führt...
Claude Opus 4.7 vs. GPT-5.5: Welches Modell gewinnt bei Code, Agenten und Reasoning?
23 Quellen0Einen klaren Gesamtsieger gibt es nicht: Claude Opus 4.7 liegt bei SWE bench Pro mit 64,3 % vor GPT 5.5 mit 58,6 %, während GPT 5.5 bei Terminal Bench 2.0 mit 82,7 % vor Claude mit 69,4 % liegt [6][14][34].
DeepSeek V4-Pro vs. Claude Opus 4.7: Claude führt bei SWE-bench, DeepSeek beim Preis
22 Quellen0Claude Opus 4.7 liegt in einer Drittanbieter Auswertung bei SWE bench Verified mit 87,6 % und SWE bench Pro mit 64,3 % vor DeepSeek V4 Pro mit 80,6 % und 55,4 % [28].
Claude Opus 4.7 vs. GPT-5.5 vs. DeepSeek V4 vs. Kimi K2.6: Benchmark-Vergleich und Auswahlhilfe
18 Quellen0Es gibt keinen belastbaren Gesamtsieger: In den gemeinsamen Daten liegt Claude Opus 4.7 bei GPQA Diamond mit 94,2 % und SWE Bench Pro mit 64,3 % vorn, während GPT 5.5 bzw.