Trendende KI-Beiträge & schnelle Research-Updates - Seite 1731
GPT-5.5, Claude Opus 4.7, Kimi K2.6 und DeepSeek V4: Wer führt in welchen Benchmarks?
18 Quellen0Kein Modell gewinnt überall: Claude Opus 4.7 führt bei GPQA Diamond und HLE ohne Tools, GPT 5.5 bei Terminal Bench 2.0, GPT 5.5 Pro bei HLE mit Tools und BrowseComp [6].
Claude Code vs. OpenAI Codex: Welcher Coding-Agent passt 2026?
25 Quellen0Claude Code passt vor allem zu Terminal , Repo und Test getriebenen Workflows; OpenAI Codex eher zu Teams, die mehrere Coding Agenten parallel mit isolierten Worktrees und prüfbaren Diffs einsetzen wollen [1...
Kostenlose GPT-5.5-Apps für Taiwan-Traditionellchinesisch? Warum es derzeit keine seriöse Top 5 gibt
13 Quellen0Derzeit lässt sich keine belastbare Top 5 von KI Apps nennen, die Taiwan Traditionellchinesisch unterstützen und kostenlos echtes GPT 5.5 anbieten; OpenAI nennt für ChatGPT GPT 5.5 keine Free Verfügbarkeit.[3]
DeepSeek V4 in Deutschland: App, Cloud oder lokal – was riskant ist
12 Quellen0Für sensible Daten ist DeepSeek in Deutschland über App, Web oder Cloud nicht empfehlenswert: Die Berliner Datenschutzaufsicht meldete die DeepSeek App am 27.
Claude Opus 4.7 vs. GPT-5.5: Welche Benchmarks 2026 wirklich zählen
22 Quellen0Im echten Head to Head führt GPT 5.5 bei Terminal Bench 2.0 mit 82,7 % zu 69,4 %, Claude Opus 4.7 bei SWE Bench Pro Public mit 64,3 % zu 58,6 % [5].
GPT‑5.5, Claude Opus 4.7, Kimi K2.6 oder DeepSeek V4: Welches Modell passt 2026?
23 Quellen0Es gibt keinen universellen Sieger: GPT‑5.5 liefert die stärksten öffentlichen Signale für Agenten mit Terminal, Browser und Tool Nutzung, während Claude Opus 4.7 bei SWE Bench artiger Codebase Reparatur vor...
GPT-5.5 vs. Claude Opus 4.7: Welches Modell passt zu welchem Einsatz?
23 Quellen0Kein Modell gewinnt überall: GPT 5.5 liegt unter anderem bei Terminal Bench 2.0, FrontierMath und BrowseComp vorn, Claude Opus 4.7 bei SWE Bench Pro und MCP Atlas [21][27][28][32].
Codex vs. Claude Code: Was kostet KI-Coding 2026 weniger?
17 Quellen0Bei reiner API Abrechnung ist gpt 5.1 codex mini in den verglichenen offiziellen Preisen am günstigsten: 2,25 USD für 1 Mio.
Codex vs. Claude Code: Welcher KI-Coding-Agent passt zum Workflow?
18 Quellen0Codex passt besser, wenn ein Team einen breiten KI Coding Workflow über App, IDE, CLI, Web, Reviews und Integrationen sucht.
Codex vs. Claude Code: Welcher KI-Coding-Agent passt zu Ihrem Workflow?
15 Quellen0Wenn Sie nur mit einem Tool starten und vor allem in bestehenden Repositories arbeiten, ist Claude Code der naheliegende Default: terminalnah, codebase orientiert und mit Git Workflow Fokus [17].
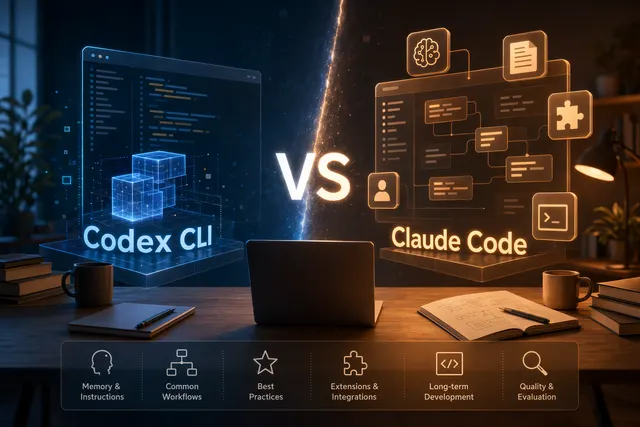
Codex CLI vs. Claude Code: Welcher KI-Coding-Agent taugt als Hauptwerkzeug?
17 Quellen0Wer heute einen Haupt Coding Agent sucht, sollte Claude Code zuerst testen: Die Dokumentation deckt unter anderem Instructions/Memories, Workflows, Best Practices, Erweiterungen und Changelog ab.[1]
Claude Code vs. Codex für UI-Design: Wer ist besser für Figma-to-Code?
15 Quellen0Für designlastige UI Arbeit zuerst Claude Code: Im genannten Figma zu Next.js Test bewahrte Claude mehr Struktur und Assets; Codex war funktional, nutzte aber 4 mal weniger Tokens und traf Theme und Layout w...