Trendende KI-Beiträge & schnelle Research-Updates - Seite 1728
GPT-5.5, Claude Opus 4.7, DeepSeek V4 oder Kimi K2.6: Welches KI-Modell passt 2026?
29 Quellen0Einen belastbaren Gesamtsieger zeigen die vorliegenden öffentlichen Quellen nicht.
Lernen lässt die Gebärmutter schrumpfen? Was Quellen wirklich belegen
4 Quellen0Mit den vorliegenden Quellen lässt sich kein medizinisches Lehrbuch nachweisen, das lehrte, Lesen oder Lernen lasse die Gebärmutter schrumpfen.
GPT-5.5 vs. Claude Opus 4.7: Welches Modell ist besser zum Coden?
18 Quellen0GPT 5.5 ist der naheliegende erste Test für terminal lastige Coding Agenten: VentureBeat nennt 82,7 % auf Terminal Bench 2.0 gegenüber 69,4 % bei Claude Opus 4.7.[6]
GPT-5.5 oder Claude Opus 4.7 fürs Coding? Es kommt auf die Aufgabe an
19 Quellen0Für Bugfixes, Repository Änderungen und testbare Pull Request Patches spricht derzeit mehr für Claude Opus 4.7: Auf SWE bench Pro werden 64,3 % für Claude Opus 4.7 und 58,6 % für GPT 5.5 genannt.[16][29]
DeepSeek nutzen: Web, App und API richtig starten
23 Quellen0Für den schnellen Einstieg bietet die offizielle DeepSeek Website die Wege Start Now, Access API und Get DeepSeek App; die App sollte nur über offizielle Kanäle geladen werden.[24][23]
GPT-5.5, Claude Opus 4.7, DeepSeek V4 und Kimi K2.6 im Vergleich
24 Quellen0Einen belastbaren Gesamtsieger gibt es nicht: Die Benchmarks nutzen unterschiedliche Einstellungen, Zeitpunkte und teils selbst gemeldete Werte.
GPT-5.5 im Benchmark-Check: stark, aber nicht überall vorn
16 Quellen0GPT 5.5 gehört nach den öffentlichen Benchmarks zur Spitzengruppe: 82,7 in Terminal Bench 2.0, 51,7 in FrontierMath Tier 1–3 und 84,9 in GDPval.
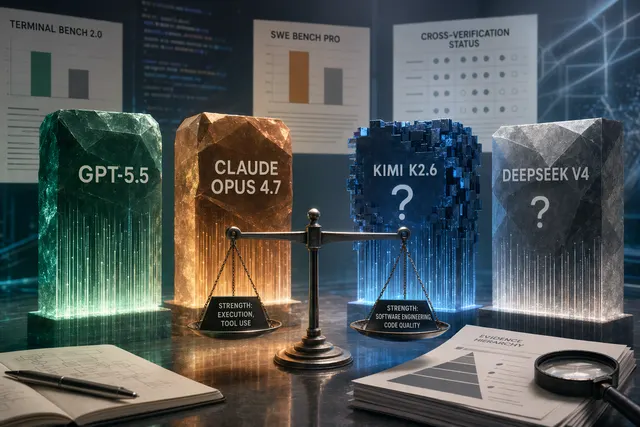
GPT-5.5, Claude Opus 4.7, Kimi K2.6 und DeepSeek V4: Welche Benchmarks wirklich vergleichbar sind
16 Quellen0Ein seriöser Gesamtsieger lässt sich derzeit nicht küren: In OpenAIs gemeinsamer Tabelle liegt Claude Opus 4.7 bei SWE Bench Pro mit 64,3 % vor GPT 5.5 mit 58,6 %, während GPT 5.5 bei Terminal Bench 2.0 mit...
Kimi K2.6: Stark beim Coding, als Allzweck-KI noch nicht bewiesen
12 Quellen0Kimi K2.6 wirkt vor allem im Coding stark: MLQ.ai meldet 58,6 auf SWE Bench Pro und 65,8% pass@1 auf SWE bench Verified; unabhängige Benchmark Daten gelten aber noch als vorläufig [8][9].
Kimi K2.6 gegen GPT-5.5, Gemini und Claude: der Entwickler-Check
23 Quellen0Kimi K2.6 ist in dieser Quellenlage vor allem der Preisführer für Coding Agenten: OpenRouter listet 262.144 Kontext Tokens sowie 0,75/3,50 US Dollar pro 1 Mio.
GPT-5.5 vs. Claude Opus 4.7: Welches KI-Modell passt zu welchem Job?
21 Quellen0Wer aus knappen Vorgaben Recherche, Analyse, Code und Dokumente erzeugen lassen will, sollte GPT 5.5 zuerst testen; wer sehr lange Kontexte und Agentenläufe priorisiert, findet in Claude Opus 4.7 starke Argu...
DeepSeek V4 im Check: nah an der KI-Spitze, aber noch kein belegter Weltmeister
18 Quellen0DeepSeek V4 ist seit dem 24. April 2026 in den offiziellen API Dokumenten als Preview aufgeführt.