Trendende KI-Beiträge & schnelle Research-Updates - Seite 1729
GPT-5.5 in Spanien: So prüfen Sie, ob Ihr Konto schon Zugriff hat
18 Quellen0In den vorliegenden Quellen gibt es keinen klaren Hinweis auf eine spezielle Sperre für Spanien; wenn GPT 5.5 nicht erscheint, liegt es eher an Konto, Plan, Organisation oder Kanal.
GPT-5.5 kostenlos testen: So prüfen Sie den Zugang in ChatGPT
12 Quellen0Der offizielle Weg führt über ChatGPT: anmelden oder kostenlos registrieren, neuen Chat öffnen und GPT 5.5 auswählen, falls es in der Modellauswahl erscheint.
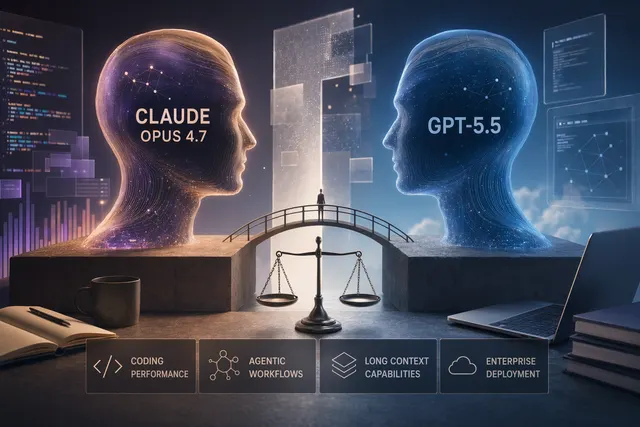
Claude Opus 4.7 oder GPT-5.5? Was bei Agents, Langkontext und API zählt
21 Quellen0Für API Einkauf, Langkontext Agents und Enterprise Betrieb lässt sich Claude Opus 4.7 derzeit direkter bewerten: Anthropic nennt 1M context window, keinen Langkontext Aufschlag im Standard API Preis, 5/25 US...
Claude Opus 4.7 vs. GPT-5.5: Benchmarks richtig lesen
11 Quellen0Ein vollständiger Direktvergleich unter identischen Bedingungen liegt in den verfügbaren Quellen nicht vor: Opus 4.7 führt auf GDPval AA mit 1.753 Elo, GPT 5.5 erreicht im Intelligence Index je nach Variante...
Claude Opus 4.7 vs. GPT-5.5: Welches KI-Modell passt zu Coding, Agenten, Recherche und Design?
17 Quellen0Claude Opus 4.7 ist der besser belegte erste Testkandidat für Coding und Tool Nutzung: Vellum nennt 87,6 % auf SWE bench Verified und 77,3 % auf MCP Atlas [3].
Claude Opus 4.7 vs. GPT-5.5: Welche KI ist reif fürs Unternehmen?
26 Quellen0Claude Opus 4.7 ist laut Anthropic bereits über Claude API, Amazon Bedrock, Google Cloud Vertex AI und Microsoft Foundry nutzbar; Preise und 1 Mio.
Claude Opus 4.7 vs. GPT-5.5 Spud: Noch kein Benchmark-Sieger
24 Quellen0Ein belastbarer Sieger lässt sich nicht nennen: Claude Opus 4.7 ist in Anthropic Material belegt, GPT 5.5 Spud hier nicht durch eine Primärquelle von OpenAI.
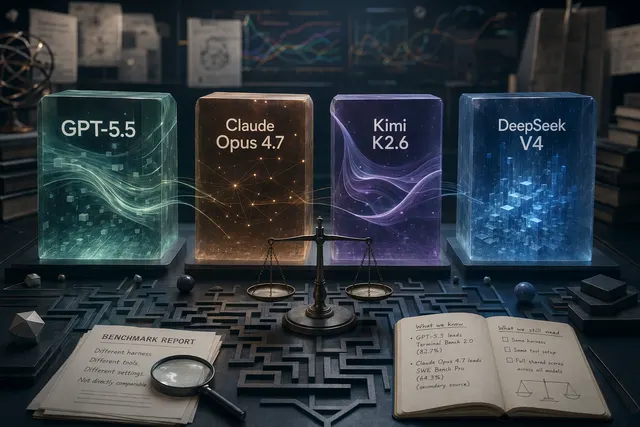
GPT-5.5, Claude Opus 4.7, Kimi K2.6 und DeepSeek V4-Pro: Benchmarks und Auswahlhilfe
23 Quellen0Ein einzelner Gesamtsieger lässt sich aus den veröffentlichten Zahlen nicht sauber ableiten: GPT 5.5 erreicht 82,7 % auf Terminal Bench 2.0, Claude Opus 4.7 wird mit 64,3 % auf SWE Bench Pro genannt, doch di...
GPT-5.5 jetzt testen: Was in ChatGPT, Codex und API offiziell geht
15 Quellen0Der schnellste Check führt über die Modell Auswahl in ChatGPT oder Codex. GPT 5.5 wird für Plus, Pro, Business und Enterprise schrittweise bereitgestellt; die API Verfügbarkeit ist laut OpenAI Dokumentation...
GPT-5.5, Claude Opus 4.7, DeepSeek V4, Kimi K2.6: Benchmark-Sieger nach Aufgabe
24 Quellen0Öffentliche Benchmarks liefern keinen sauberen Gesamtsieger: GPT 5.5 liegt im Terminal Bench 2.0 bei 82,7 %, Claude Opus 4.7 bei SWE Bench Pro und Verified mit 64,3 % bzw.
Claude Opus 4.7 im Benchmark: Was die 87,6 % in SWE-bench Verified bedeuten
12 Quellen0Der wichtigste öffentlich zitierte Wert für Claude Opus 4.7 ist 87,6 % in SWE bench Verified, von AWS auf Basis von Anthropic Daten berichtet [7].
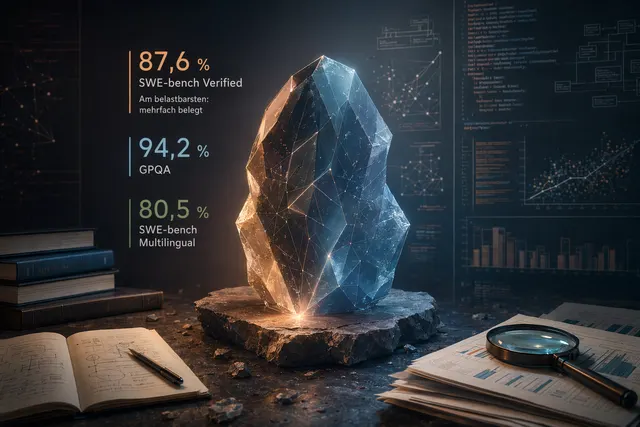
Claude Opus 4.7 Benchmarks: SWE-bench, GPQA und Quellencheck
16 Quellen0Öffentlich werden für Claude Opus 4.7 vor allem 87,6 % auf SWE bench Verified, 94,2 % auf GPQA und 80,5 % auf SWE bench Multilingual genannt; am besten abgesichert ist in dieser Quellenlage der SWE bench Ver...