Entdecke KI-Antworten, Berichte, Code und Workflows – Seite 1522
Claude Opus 4.7 vs. GPT-5.5: Welche KI ist reif fürs Unternehmen?
Claude Opus 4.7 vs. GPT-5.5 Spud: Noch kein Benchmark-Sieger
GPT-5.5, Claude Opus 4.7, Kimi K2.6 und DeepSeek V4-Pro: Benchmarks und Auswahlhilfe
GPT-5.5 jetzt testen: Was in ChatGPT, Codex und API offiziell geht
GPT-5.5, Claude Opus 4.7, DeepSeek V4, Kimi K2.6: Benchmark-Sieger nach Aufgabe
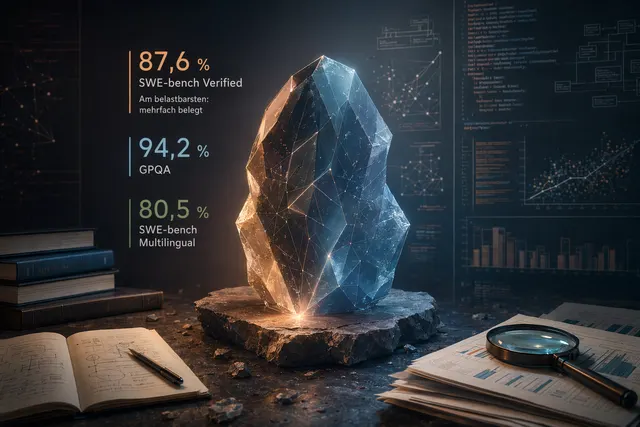
Claude Opus 4.7 im Benchmark: Was die 87,6 % in SWE-bench Verified bedeuten
Claude Opus 4.7 Benchmarks: SWE-bench, GPQA und Quellencheck
Claude Mythos Preview: Was 93,9 % in SWE-bench wirklich bedeuten
Claude Mythos Benchmarks: 93,9 % SWE-bench – und warum die Scores schwer vergleichbar sind
Kimi K2.6, DeepSeek V4, GPT-5.5 und Claude Opus 4.7 im Vergleich
GPT-5.5 vs. Claude Opus 4.7: Benchmarks, Preise und Auswahlhilfe
GPT-5.5 vs. DeepSeek V4: Benchmarks, Coding, Agenten-Tasks und Preise