studioglobal
Discover

探索 AI 答案、報告、程式碼與工作流程 - 第 1728 頁
探索
全部答案報告程式碼工作流程圖片集熱門
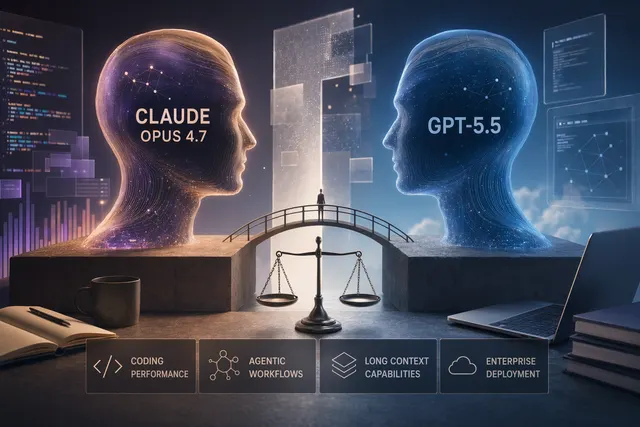
  • Claude Opus 4.7 與 GPT-5.5 在代理工作、編碼和長上下文場景中的比較示意圖

    Claude Opus 4.7 vs GPT-5.5:長上下文、代理編碼與企業部署怎麼選

    7 個月前21 個來源
  • 抽象比較 Claude Opus 4.7 與 GPT-5.5 在 AI 工作流中的選型差異

    Claude Opus 4.7 vs GPT-5.5:基準怎麼看、實務怎麼選

    7 個月前11 個來源
  • Split-screen editorial illustration comparing Claude Opus 4.7 and GPT-5.5 for coding, agents, research and design

    Claude Opus 4.7 vs GPT-5.5:寫程式、Agent、研究與設計該選誰?

    7 個月前17 個來源
  • Claude Opus 4.7 與 GPT-5.5 企業部署比較的抽象 AI 圖像

    Claude Opus 4.7 vs GPT-5.5:企業部署前該看清的 API、成本與證據

    7 個月前26 個來源
  • Editorial illustration of Claude Opus 4.7 and GPT-5.5 Spud benchmark claims being compared on scorecards

    Claude Opus 4.7 vs GPT-5.5 Spud:基準測試還不能判勝負

    7 個月前24 個來源
  • 四款 AI 模型的基準測試比較示意圖,包含 GPT-5.5、Claude Opus 4.7、Kimi K2.6 與 DeepSeek V4

    GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4:基準測試與選型指南

    7 個月前23 個來源
  • GPT-5.5の利用可否をChatGPT、Codex、APIで確認するイメージ

    GPT-5.5 現在怎麼試用:ChatGPT、Codex、API 官方狀態一次看

    7 個月前15 個來源
  • 네 개의 AI 모델 벤치마크 점수를 비교하는 추상적인 대시보드 일러스트

    GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6:不同任務有不同贏家

    7 個月前24 個來源
  • Ilustración editorial de benchmarks de Claude Opus 4.7 con gráficos de rendimiento y código

    Claude Opus 4.7 基準測試解讀:SWE-bench Verified 87.6% 代表什麼?

    7 個月前12 個來源
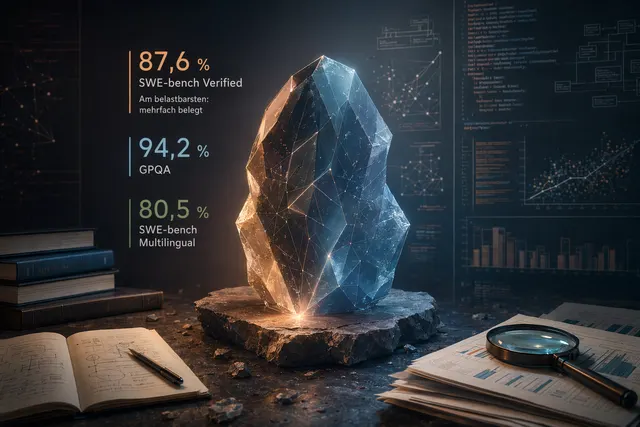
  • Abstrakte Visualisierung von Claude Opus 4.7 Benchmarks mit Diagrammen und Code-Elementen

    Claude Opus 4.7 基準測試怎麼看:SWE-bench、GPQA 與可信度

    7 個月前16 個來源
  • Ilustración de un panel de benchmark de IA con código y métricas para Claude Mythos Preview

    Claude Mythos Preview 的 93.9% SWE-bench:這個基準測試該怎麼看

    7 個月前17 個來源
  • Abstrakte KI-Benchmark-Grafik zu Claude Mythos Preview mit Code- und Score-Elementen

    Claude Mythos 基準測試:SWE-bench 93.9%,但分數不能直接當排行榜看

    7 個月前17 個來源
上一頁下一頁