答案已發布16 個來源
二手 Tesla P40 24GB:把舊伺服器變成本地 AI 推論機的低價選擇
如果你已經有退役機架伺服器或工作站,二手 NVIDIA Tesla P40 24GB 通常是最低成本取得 24GB VRAM 的本地 AI 升級路線;近期指南提到的二手價多落在約 US$150–250 或低於 US$300 的區間。 P40 是 2016 年資料中心推論卡,不是現代桌機顯卡:它需要足夠供電、強制風道散熱,也沒有顯示輸出。
發布者使用 GPT-5.5 編輯圖片由 GPT Image 2 生成
研究答案
重點整理
- 如果你已經有退役機架伺服器或工作站,二手 NVIDIA Tesla P40 24GB 通常是最低成本取得 24GB VRAM 的本地 AI 升級路線;近期指南提到的二手價多落在約 US$150–250 或低於 US$300 的區間。
- P40 是 2016 年資料中心推論卡,不是現代桌機顯卡:它需要足夠供電、強制風道散熱,也沒有顯示輸出。
- 預算較高、想少折騰可看二手 RTX 3090 24GB;若考慮 A100,成本就已進入數千美元等級,不再是便宜救舊機方案。
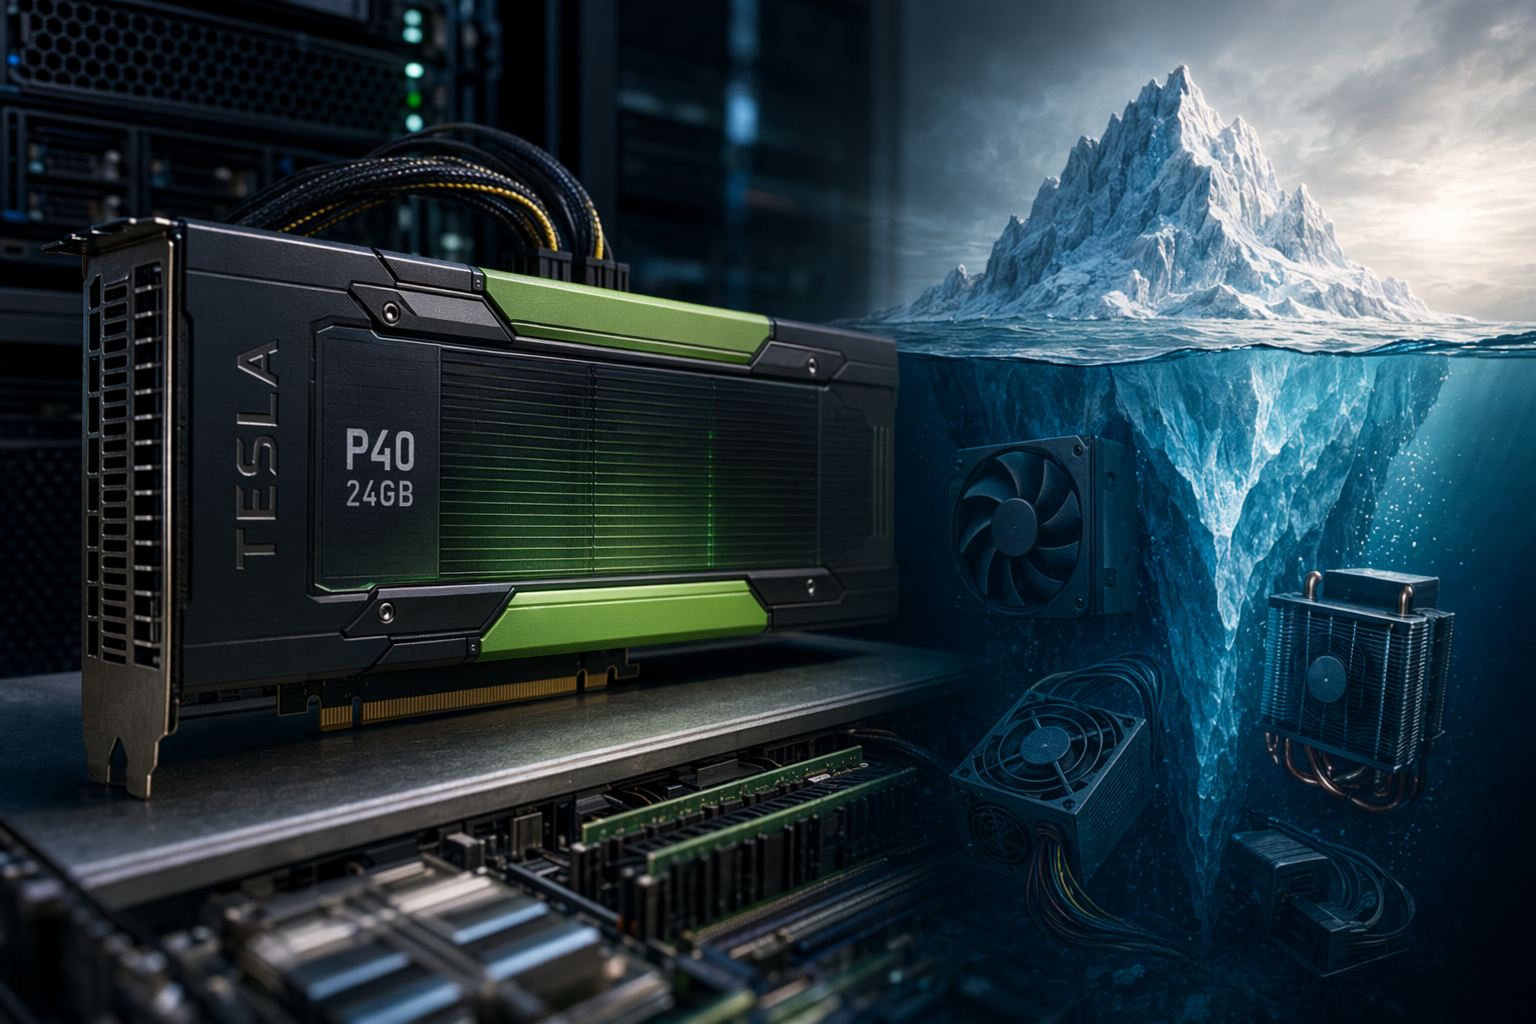
AI 提示詞
openai.comCreate a landscape editorial hero image for this Studio Global article: Cheapest Local AI GPU Upgrade for an Old Server: Used Tesla P40 24GB. Article summary: The cheapest viable upgrade is usually a used NVIDIA Tesla P40 24GB: recent sources place it around $150–$200 or under $200 to sub $300, but it is a 2016 era data center inference card that needs serious directed cool.... Topic tags: local ai, llm, gpu, homelab, nvidia. Reference image context from search candidates: Reference image 1: visual subject "A high-impact cinematic close-up of a Tesla P40 GPU integrated into a modern AI workstation, glowing with neural network energy" source context "Tesla P40 for Local LLMs (2026): 24GB VRAM for $200?" Reference image 2: visual subject "A minimalist iceberg sketch illustrating the hidden costs of running a Tesla P40, including power consumption and DIY cooling" source context "Tesla P40
如果你手上已經有一台退役機架伺服器或工作站,想讓它重新派上用場跑本地 AI,最省錢的思路通常不是整台平台重買,而是先買足 VRAM。多份近期本地 LLM 採購指南都把二手 NVIDIA Tesla P40 24GB 列為低價 24GB 選項;依來源與刊登條件不同,常見區間被描述為約 US$150–200、US$200–250、低於 US$200,或低於 US$300 。
Studio Global AI
繼續深入研究
這個頁面包含附來源佐證的答案,你可以在 Studio Global 內繼續追問。
大家也會問
「二手 Tesla P40 24GB:把舊伺服器變成本地 AI 推論機的低價選擇」的簡短答案是什麼?
如果你已經有退役機架伺服器或工作站,二手 NVIDIA Tesla P40 24GB 通常是最低成本取得 24GB VRAM 的本地 AI 升級路線;近期指南提到的二手價多落在約 US$150–250 或低於 US$300 的區間。
最值得優先驗證的重點是什麼?
如果你已經有退役機架伺服器或工作站,二手 NVIDIA Tesla P40 24GB 通常是最低成本取得 24GB VRAM 的本地 AI 升級路線;近期指南提到的二手價多落在約 US$150–250 或低於 US$300 的區間。 P40 是 2016 年資料中心推論卡,不是現代桌機顯卡:它需要足夠供電、強制風道散熱,也沒有顯示輸出。
接下來在實務上該怎麼做?
預算較高、想少折騰可看二手 RTX 3090 24GB;若考慮 A100,成本就已進入數千美元等級,不再是便宜救舊機方案。
來源
accio.comNvidia P40: Best Budget 24GB GPU in 2026?
craftrigs.comUsed Server GPUs for Local LLMs: A100, H100, P40 [2026] | CraftRigs
insiderllm.comUsed Tesla P40 for Local AI: The $200 Budget Beast | InsiderLLM
jarvislabs.aiNVIDIA A100 GPU Price in 2026: Cost Per Hour, Cloud ...