Claude Opus 4.7 против GPT-5.4, Gemini 3.1 Pro и Grok 4: как выбирать ИИ-модель по задаче
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош... GPT 5.4 лучше включать в сравнение для структурированного рассуждения и computer use, Gemini 3.1...
ОпубликовалОтредактировано с помощью GPT-5.5Изображения созданы с помощью GPT Image 2
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош...
GPT 5.4 лучше включать в сравнение для структурированного рассуждения и computer use, Gemini 3.1 Pro — для мультимодальных и научных задач, Grok 4 — для HLE и сложного reasoning.[5]
Не выбирайте модель только по лидербордам: источники и даты бенчмарков могут различаться, а ежедневный опыт зависит также от надежности, интерфейса и стоимости итераций.[2][6]
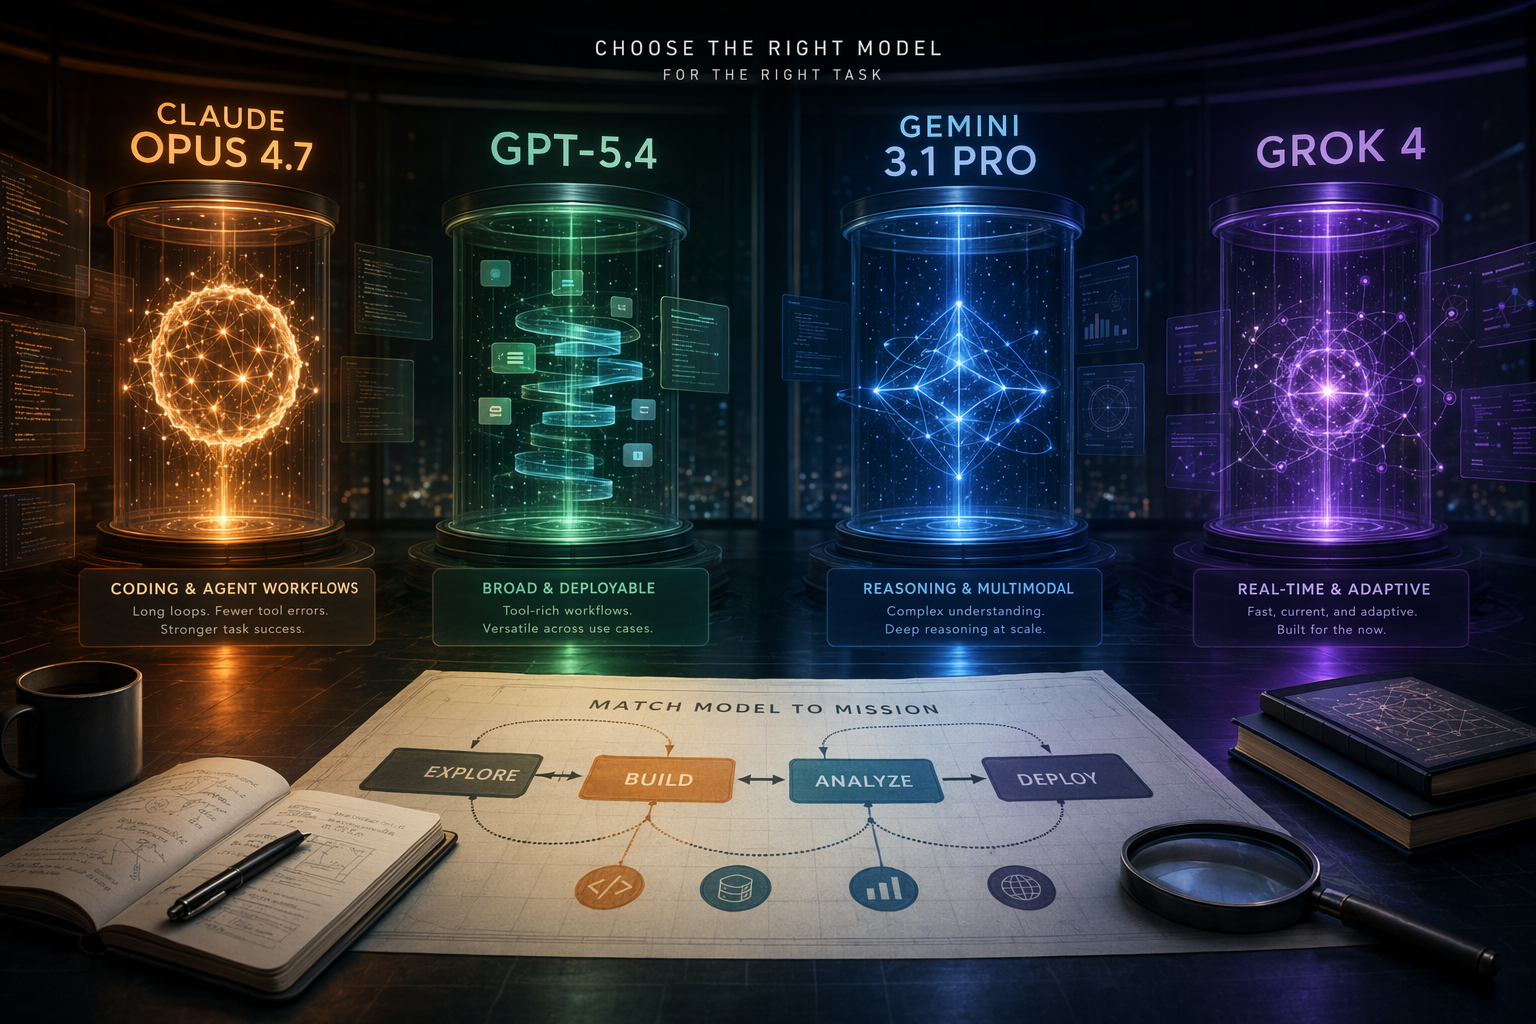
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
Промпт ИИ
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
Сводить Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro и Grok 4 к вопросу «кто лучший?» удобно, но не очень полезно. В реальной работе важнее другое: где ваша задача обычно ломается — в коде, в длинной цепочке действий, в работе с изображениями, в строгом следовании правилам или в сложном рассуждении.
Стороннее руководство по выбору LLM формулирует общий принцип так: нет модели, которая доминирует во всех задачах; сильные стороны распределены между кодингом, структурированным рассуждением, мультимодальностью, научными бенчмарками и задачами высокой сложности.
Anthropic заявляет, что Opus 4.7 по сравнению с Opus 4.6 дает прирост успешности в Factory Droids на 10–15%, а также меньше ошибок инструментов и более надежную работу; Axios описывает релиз как заметное обновление флагманской модели с улучшениями в кодинге и зрительном понимании.
Studio Global AI
Продолжайте свое исследование
На этой странице есть ответ, подтвержденный источником, который вы можете продолжить внутри Studio Global.
Каков краткий ответ на вопрос «Claude Opus 4.7 против GPT-5.4, Gemini 3.1 Pro и Grok 4: как выбирать ИИ-модель по задаче»?
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош...
Какие ключевые моменты необходимо проверить в первую очередь?
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош... GPT 5.4 лучше включать в сравнение для структурированного рассуждения и computer use, Gemini 3.1 Pro — для мультимодальных и научных задач, Grok 4 — для HLE и сложного reasoning.[5]
Что мне делать дальше на практике?
Не выбирайте модель только по лидербордам: источники и даты бенчмарков могут различаться, а ежедневный опыт зависит также от надежности, интерфейса и стоимости итераций.[2][6]
Claude Opus 4.7 против GPT-5.4, Gemini 3.1 Pro и Grok 4: как выбирать ИИ-модель по задаче
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош... GPT 5.4 лучше включать в сравнение для структурированного рассуждения и computer use, Gemini 3.1...
ОпубликовалОтредактировано с помощью GPT-5.5Изображения созданы с помощью GPT Image 2
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош...
GPT 5.4 лучше включать в сравнение для структурированного рассуждения и computer use, Gemini 3.1 Pro — для мультимодальных и научных задач, Grok 4 — для HLE и сложного reasoning.[5]
Не выбирайте модель только по лидербордам: источники и даты бенчмарков могут различаться, а ежедневный опыт зависит также от надежности, интерфейса и стоимости итераций.[2][6]
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
Промпт ИИ
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
Сводить Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro и Grok 4 к вопросу «кто лучший?» удобно, но не очень полезно. В реальной работе важнее другое: где ваша задача обычно ломается — в коде, в длинной цепочке действий, в работе с изображениями, в строгом следовании правилам или в сложном рассуждении.
Стороннее руководство по выбору LLM формулирует общий принцип так: нет модели, которая доминирует во всех задачах; сильные стороны распределены между кодингом, структурированным рассуждением, мультимодальностью, научными бенчмарками и задачами высокой сложности.
Anthropic заявляет, что Opus 4.7 по сравнению с Opus 4.6 дает прирост успешности в Factory Droids на 10–15%, а также меньше ошибок инструментов и более надежную работу; Axios описывает релиз как заметное обновление флагманской модели с улучшениями в кодинге и зрительном понимании.
Studio Global AI
Продолжайте свое исследование
На этой странице есть ответ, подтвержденный источником, который вы можете продолжить внутри Studio Global.
Каков краткий ответ на вопрос «Claude Opus 4.7 против GPT-5.4, Gemini 3.1 Pro и Grok 4: как выбирать ИИ-модель по задаче»?
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош...
Какие ключевые моменты необходимо проверить в первую очередь?
Claude Opus 4.7 стоит первым тестировать для разработки, агентных процессов и стабильных вызовов инструментов: Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ош... GPT 5.4 лучше включать в сравнение для структурированного рассуждения и computer use, Gemini 3.1 Pro — для мультимодальных и научных задач, Grok 4 — для HLE и сложного reasoning.[5]
Что мне делать дальше на практике?
Не выбирайте модель только по лидербордам: источники и даты бенчмарков могут различаться, а ежедневный опыт зависит также от надежности, интерфейса и стоимости итераций.[2][6]
Это прежде всего доказательство прогресса Opus 4.7 относительно Opus 4.6, а не нейтральный head-to-head всех четырех моделей.
Жесткие регламенты, структурированное рассуждение, computer use
GPT-5.4
Стороннее руководство называет GPT-5.4 сильной моделью для structured reasoning и computer use и приводит показатель OSWorld 75%.
Все равно нужна проверка на ваших правилах, инструментах и критериях ошибок.
Изображения, графики, скриншоты документов, научные вопросы, исследовательские справки
Gemini 3.1 Pro
То же руководство ставит Gemini 3.1 Pro в лидеры по abstract reasoning, multimodal input и scientific benchmarks, включая GPQA 94,3%.
Сильные мультимодальные и научные бенчмарки не означают автоматическое лидерство в coding agent или долгих цепочках инструментов.
Сверхсложные задачи на рассуждение
Grok 4
Стороннее руководство пишет, что Grok 4 лидирует по HLE с результатом 50,7%.
Один показатель HLE нельзя прямо переносить на обычные бизнес-процессы, качество контента или работу с инструментами.
Диверсификация поставщиков, проверка открытых или альтернативных моделей
MiniMax, GLM, Kimi и другие
В том же руководстве указано, что MiniMax M2.5/M2.7, GLM-5/5.1 и Kimi K2.5 по задачам класса SWE-bench уже сопоставимы с передовыми проприетарными моделями.
Близость в SWE-bench не доказывает такую же зрелость API, мультимодальности, безопасности, письма или продуктовых интеграций.
Claude Opus 4.7: главный сигнал — код и надежные инструменты
Opus 4.7 наиболее интересен не просто как новый флагман, а потому что Anthropic отдельно подчеркивает успешность задач и ошибки инструментов. На странице модели сказано, что Claude Opus 4.7 превосходит Opus 4.6 на Factory Droids: успешность выше на 10–15%, ошибок инструментов меньше, а работа надежнее.
Для команд разработки это важный тип улучшения. В реальном агентном процессе модель часто проваливается не на одном ответе, а на десятом шаге: теряет контекст, вызывает не тот инструмент, меняет не тот файл или требует лишней ручной правки. Поэтому Opus 4.7 выглядит сильным кандидатом для первого раунда тестов в программной инженерии и агентных сценариях. Axios также описывает Opus 4.7 как заметное обновление флагманской модели Anthropic с улучшениями в coding и vision.
Но аккуратная интерпретация такая: источники уверенно говорят об апгрейде относительно Opus 4.6; они не дают достаточного основания заявить, что Opus 4.7 при одинаковых условиях побеждает GPT-5.4, Gemini 3.1 Pro и Grok 4 во всех сценариях.
GPT-5.4: когда важны регламент и последовательность
Если задача похожа на проверку по правилам, табличный процесс, работу с интерфейсом, цепочку инструментов или многошаговое решение, GPT-5.4 нужно включать в первый раунд сравнения. Стороннее руководство выделяет GPT-5.4 именно в structured reasoning и computer use и приводит OSWorld 75%.
Это не означает, что GPT-5.4 лучше Opus 4.7 во всем. Более практичный вывод: если цена ошибки у вас связана с нарушением порядка действий, неверным применением правил или операционными задачами, сравнивайте GPT-5.4 и Opus 4.7 на одних и тех же сценариях.
Gemini 3.1 Pro: мультимодальность и научный контекст
Gemini 3.1 Pro стоит тестировать рано, если входные данные не ограничиваются текстом: изображения, диаграммы, скриншоты, графики, фрагменты документов, научные вопросы или исследовательские ответы. Стороннее руководство ставит Gemini 3.1 Pro в сильную позицию по abstract reasoning, multimodal input и scientific benchmarks, включая GPQA 94,3%.
Здесь важно не название бренда, а форма задачи. Если ваш реальный workflow содержит много визуальных данных или научного материала, выбор модели только по coding-бенчмарку может увести в сторону от сильных сторон Gemini 3.1 Pro.
Grok 4: сильный HLE-сигнал, но не универсальный ответ
Grok 4 заслуживает внимания в задачах высокой сложности. Стороннее руководство называет Grok 4 лидером по HLE с результатом 50,7%.
Но HLE не стоит превращать в единственный критерий. Высокий результат на одном сложном бенчмарке не доказывает автоматическое превосходство в бизнес-процессах, генерации контента, coding agent или надежной работе с инструментами. Другая статья о рейтингах моделей прямо напоминает: бенчмарки полезны, но ежедневный опыт разработки часто определяется надежностью, возможностями интерфейса и стоимостью итераций.
Почему нельзя просто открыть лидерборд
Во-первых, таблицы часто смешивают разные бенчмарки и разные даты обновления. Например, сравнение AI coding model comparison от Failing Fast использует источники SWE-bench за февраль 2026 года, Aider за октябрь 2025 года и Arena Code за февраль 2026 года. Такая таблица может дать направление, но не является абсолютным рейтингом всех моделей в один и тот же день и в одинаковых условиях.
Во-вторых, официальное сравнение с прежней версией и сторонняя межмодельная подборка — разные типы доказательств. Данные Anthropic сильнее всего подтверждают, что Opus 4.7 улучшилась относительно Opus 4.6; стороннее руководство дает полезные ориентиры по GPT-5.4, Gemini 3.1 Pro, Grok 4 и другим моделям, но это не совместный официальный head-to-head OpenAI, Google, xAI и Anthropic.
В-третьих, реальное качество внедрения зависит не только от баллов. Надежность, интерфейсные возможности и стоимость итераций могут влиять на ежедневный опыт сильнее, чем разница в одном benchmark-показателе.
Практический тест перед запуском
Для закупки, внедрения или выбора стандартной модели в команде лучше сравнивать не лозунги, а реальные рабочие задачи. Минимальный тест может выглядеть так:
Возьмите 5–10 задач, которые действительно выполняются каждый день: исправление бага, добавление функции, рефакторинг, чтение длинного документа, анализ скриншота, подготовка спецификации или вызов инструментов.
Для всех моделей используйте одинаковый prompt, одинаковый контекст и одинаковые критерии готовности.
Считайте не только лучший ответ, но и метрики процесса: прохождение с первой попытки, число возвратов на доработку, ошибки инструментов, галлюцинации, задержку, стоимость и время ручной правки.
Обязательно смотрите на худшие ответы. После запуска в продукте именно режимы отказа обычно важнее красивых демонстраций.
Если в задачах есть персональные данные, коммерческая тайна, регуляторные требования или внутренний код, отдельно проверьте хранение данных, варианты развертывания и корпоративные настройки контроля.
Осторожный итог
Claude Opus 4.7 — первоочередной кандидат для разработки, агентных процессов и сценариев, где критичны надежные вызовы инструментов. Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ошибок инструментов; Axios также описывает Opus 4.7 как значимое обновление флагманской модели с улучшениями в кодинге и зрительном понимании.
Но на вопрос «кто абсолютный победитель?» доступные источники не дают надежного ответа. Более практичный вывод из стороннего руководства такой: единой модели, которая доминирует во всех задачах, нет; GPT-5.4, Gemini 3.1 Pro, Grok 4 и новые альтернативные модели имеют разные зоны силы.
Самый безопасный подход: взять Claude Opus 4.7 как одного из первых кандидатов для кода и агентных сценариев, но прогнать его на ваших реальных задачах рядом с GPT-5.4, Gemini 3.1 Pro и Grok 4.
Это прежде всего доказательство прогресса Opus 4.7 относительно Opus 4.6, а не нейтральный head-to-head всех четырех моделей.
Жесткие регламенты, структурированное рассуждение, computer use
GPT-5.4
Стороннее руководство называет GPT-5.4 сильной моделью для structured reasoning и computer use и приводит показатель OSWorld 75%.
Все равно нужна проверка на ваших правилах, инструментах и критериях ошибок.
Изображения, графики, скриншоты документов, научные вопросы, исследовательские справки
Gemini 3.1 Pro
То же руководство ставит Gemini 3.1 Pro в лидеры по abstract reasoning, multimodal input и scientific benchmarks, включая GPQA 94,3%.
Сильные мультимодальные и научные бенчмарки не означают автоматическое лидерство в coding agent или долгих цепочках инструментов.
Сверхсложные задачи на рассуждение
Grok 4
Стороннее руководство пишет, что Grok 4 лидирует по HLE с результатом 50,7%.
Один показатель HLE нельзя прямо переносить на обычные бизнес-процессы, качество контента или работу с инструментами.
Диверсификация поставщиков, проверка открытых или альтернативных моделей
MiniMax, GLM, Kimi и другие
В том же руководстве указано, что MiniMax M2.5/M2.7, GLM-5/5.1 и Kimi K2.5 по задачам класса SWE-bench уже сопоставимы с передовыми проприетарными моделями.
Близость в SWE-bench не доказывает такую же зрелость API, мультимодальности, безопасности, письма или продуктовых интеграций.
Claude Opus 4.7: главный сигнал — код и надежные инструменты
Opus 4.7 наиболее интересен не просто как новый флагман, а потому что Anthropic отдельно подчеркивает успешность задач и ошибки инструментов. На странице модели сказано, что Claude Opus 4.7 превосходит Opus 4.6 на Factory Droids: успешность выше на 10–15%, ошибок инструментов меньше, а работа надежнее.
Для команд разработки это важный тип улучшения. В реальном агентном процессе модель часто проваливается не на одном ответе, а на десятом шаге: теряет контекст, вызывает не тот инструмент, меняет не тот файл или требует лишней ручной правки. Поэтому Opus 4.7 выглядит сильным кандидатом для первого раунда тестов в программной инженерии и агентных сценариях. Axios также описывает Opus 4.7 как заметное обновление флагманской модели Anthropic с улучшениями в coding и vision.
Но аккуратная интерпретация такая: источники уверенно говорят об апгрейде относительно Opus 4.6; они не дают достаточного основания заявить, что Opus 4.7 при одинаковых условиях побеждает GPT-5.4, Gemini 3.1 Pro и Grok 4 во всех сценариях.
GPT-5.4: когда важны регламент и последовательность
Если задача похожа на проверку по правилам, табличный процесс, работу с интерфейсом, цепочку инструментов или многошаговое решение, GPT-5.4 нужно включать в первый раунд сравнения. Стороннее руководство выделяет GPT-5.4 именно в structured reasoning и computer use и приводит OSWorld 75%.
Это не означает, что GPT-5.4 лучше Opus 4.7 во всем. Более практичный вывод: если цена ошибки у вас связана с нарушением порядка действий, неверным применением правил или операционными задачами, сравнивайте GPT-5.4 и Opus 4.7 на одних и тех же сценариях.
Gemini 3.1 Pro: мультимодальность и научный контекст
Gemini 3.1 Pro стоит тестировать рано, если входные данные не ограничиваются текстом: изображения, диаграммы, скриншоты, графики, фрагменты документов, научные вопросы или исследовательские ответы. Стороннее руководство ставит Gemini 3.1 Pro в сильную позицию по abstract reasoning, multimodal input и scientific benchmarks, включая GPQA 94,3%.
Здесь важно не название бренда, а форма задачи. Если ваш реальный workflow содержит много визуальных данных или научного материала, выбор модели только по coding-бенчмарку может увести в сторону от сильных сторон Gemini 3.1 Pro.
Grok 4: сильный HLE-сигнал, но не универсальный ответ
Grok 4 заслуживает внимания в задачах высокой сложности. Стороннее руководство называет Grok 4 лидером по HLE с результатом 50,7%.
Но HLE не стоит превращать в единственный критерий. Высокий результат на одном сложном бенчмарке не доказывает автоматическое превосходство в бизнес-процессах, генерации контента, coding agent или надежной работе с инструментами. Другая статья о рейтингах моделей прямо напоминает: бенчмарки полезны, но ежедневный опыт разработки часто определяется надежностью, возможностями интерфейса и стоимостью итераций.
Почему нельзя просто открыть лидерборд
Во-первых, таблицы часто смешивают разные бенчмарки и разные даты обновления. Например, сравнение AI coding model comparison от Failing Fast использует источники SWE-bench за февраль 2026 года, Aider за октябрь 2025 года и Arena Code за февраль 2026 года. Такая таблица может дать направление, но не является абсолютным рейтингом всех моделей в один и тот же день и в одинаковых условиях.
Во-вторых, официальное сравнение с прежней версией и сторонняя межмодельная подборка — разные типы доказательств. Данные Anthropic сильнее всего подтверждают, что Opus 4.7 улучшилась относительно Opus 4.6; стороннее руководство дает полезные ориентиры по GPT-5.4, Gemini 3.1 Pro, Grok 4 и другим моделям, но это не совместный официальный head-to-head OpenAI, Google, xAI и Anthropic.
В-третьих, реальное качество внедрения зависит не только от баллов. Надежность, интерфейсные возможности и стоимость итераций могут влиять на ежедневный опыт сильнее, чем разница в одном benchmark-показателе.
Практический тест перед запуском
Для закупки, внедрения или выбора стандартной модели в команде лучше сравнивать не лозунги, а реальные рабочие задачи. Минимальный тест может выглядеть так:
Возьмите 5–10 задач, которые действительно выполняются каждый день: исправление бага, добавление функции, рефакторинг, чтение длинного документа, анализ скриншота, подготовка спецификации или вызов инструментов.
Для всех моделей используйте одинаковый prompt, одинаковый контекст и одинаковые критерии готовности.
Считайте не только лучший ответ, но и метрики процесса: прохождение с первой попытки, число возвратов на доработку, ошибки инструментов, галлюцинации, задержку, стоимость и время ручной правки.
Обязательно смотрите на худшие ответы. После запуска в продукте именно режимы отказа обычно важнее красивых демонстраций.
Если в задачах есть персональные данные, коммерческая тайна, регуляторные требования или внутренний код, отдельно проверьте хранение данных, варианты развертывания и корпоративные настройки контроля.
Осторожный итог
Claude Opus 4.7 — первоочередной кандидат для разработки, агентных процессов и сценариев, где критичны надежные вызовы инструментов. Anthropic заявляет о приросте успешности Factory Droids на 10–15% относительно Opus 4.6 и меньшем числе ошибок инструментов; Axios также описывает Opus 4.7 как значимое обновление флагманской модели с улучшениями в кодинге и зрительном понимании.
Но на вопрос «кто абсолютный победитель?» доступные источники не дают надежного ответа. Более практичный вывод из стороннего руководства такой: единой модели, которая доминирует во всех задачах, нет; GPT-5.4, Gemini 3.1 Pro, Grok 4 и новые альтернативные модели имеют разные зоны силы.
Самый безопасный подход: взять Claude Opus 4.7 как одного из первых кандидатов для кода и агентных сценариев, но прогнать его на ваших реальных задачах рядом с GPT-5.4, Gemini 3.1 Pro и Grok 4.
iternal.aiThe Definitive LLM Selection & Benchmarks Guide
anthropic.comClaude Opus 4.7 - Anthropic
axios.comAnthropic releases Claude Opus 4.7, concedes it trails ... - Axios
adam.holter.comAI Labs LLM Rankings 2026: Claude vs GPT-5 vs Gemini 3 vs Grok
failingfast.ioAI coding model comparison - Failing Fast