Descubra respostas, relatórios, códigos e fluxos de trabalho com IA - Página 1523
Claude Opus 4.7 vs GPT-5.5: qual IA usar para código, agentes, pesquisa e design
Claude Opus 4.7 vs GPT-5.5: o que avaliar antes de levar para a empresa
Claude Opus 4.7 vs GPT-5.5 Spud: ainda não há vencedor confiável
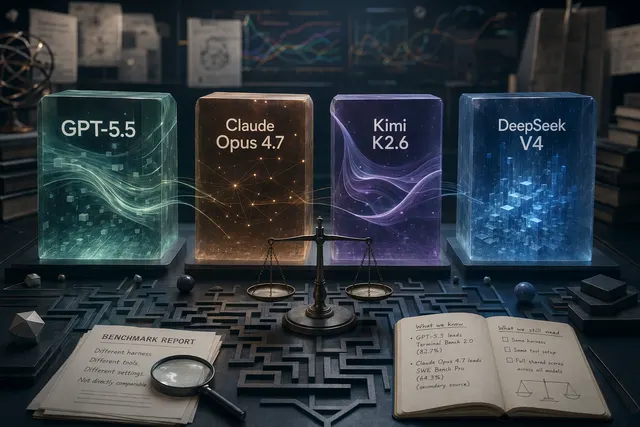
GPT-5.5, Claude Opus 4.7, Kimi K2.6 e DeepSeek V4-Pro: benchmarks e como escolher
Como testar o GPT-5.5 agora: o que funciona no ChatGPT, no Codex e na API
GPT-5.5, Claude Opus 4.7, DeepSeek V4 e Kimi K2.6: quem vence em cada benchmark
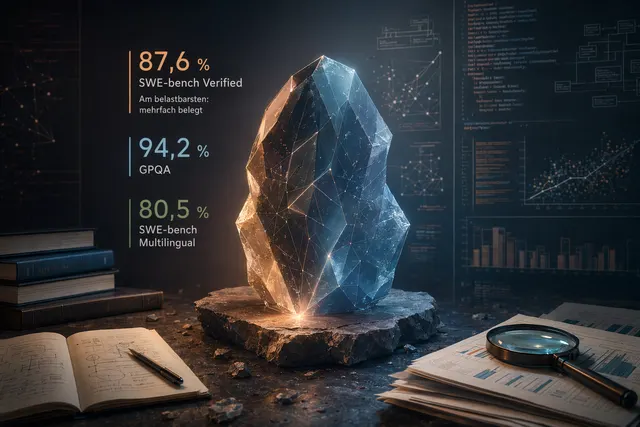
Benchmarks do Claude Opus 4.7: o que significa 87,6% no SWE-bench Verified
Claude Opus 4.7: benchmarks e grau de confiança dos números públicos
Claude Mythos Preview: como ler os 93,9% no SWE-bench
Claude Mythos: 93,9% no SWE-bench, mas o placar exige contexto
Kimi K2.6, DeepSeek V4, GPT-5.5 ou Claude Opus 4.7: qual LLM escolher?
GPT-5.5 vs Claude Opus 4.7: benchmarks, preço e quando usar cada modelo