トレンドAI投稿と注目リサーチのキャッチアップ - ページ1703
GPT Image 2プロンプトの書き方:ポスター、バナー、スライド、商品画像を狙い通りに作る6要素
9 ソース0GPT Image 2で使える画像プロンプトは、目的、主役、構図、スタイル、画像内テキスト、制約の6要素でデザインブリーフ化すると安定しやすい。
Claude Opus 4.7のベンチマーク:強い領域と過信できない領域
12 ソース0AnthropicとAWSはClaude Opus 4.7を、一般提供されているClaudeモデルの中で最も高性能なモデルと位置づけています。100万トークンのコンテキストウィンドウと最大128kトークン出力が大きな特徴です。[5][2]
Claude Opus 4.7の使いどころ:コーディング、エージェント、企業実務で強い場面
12 ソース0Claude Opus 4.7は、日常的な短い依頼よりも、高度な開発、長い工程のエージェント、企業の知識業務、ビジョン、100万トークン文脈のような複雑な仕事で検討したいモデルです。[5][8][2]
AIはあなたの仕事を奪うのか?WEF・ILO・IMFで見る本当のリスク
12 ソース0WEF・ILO・IMFは、AIを雇用市場・業務タスク・スキルを変える大きな要因としているが、個人の仕事が必ず消えるとは断定していません。
英語・ベトナム語翻訳で最強のAIは?現時点で王者は決めにくい
5 ソース0今回確認できる資料だけでは、英語↔ベトナム語翻訳で単独トップのAIを独立に断定するには根拠が足りません。[1][2][3][4]
Claude Opus 4.7の1Mコンテキストで、リポジトリを丸ごと読めるのか
11 ソース0Claude Opus 4.7は公式に1M token context windowと最大128k output tokensをサポートしています。ただし、repo本体だけでなく、指示文、会話履歴、ツール結果、出力余地まで含めて上限内に収まる必要があります。[2]
AIは心のコーチになれる?チャットボットに任せてよいこと・いけないこと
11 ソース0AIは悩みを箇条書きにしたり、会話の下書きを作ったりする補助には使える。ただし心理療法、診断、危機対応の代わりにはならない [1][2][11]。
IFTA契約の「Korea」は韓国だけを指す? Territory条項で曖昧にしない書き方
5 ソース0韓国のみを対象にするIFTA参照の権利許諾では、「Territory: Republic of Korea (South Korea)」と明記するのが最も安全です[5]。
Claude Opus 4.7のVisionは何が変わる?3.75MP対応がスクショと文書に効く理由
12 ソース0Claude Opus 4.7は、画像入力の上限を1568px / 1.15MPから2576px / 3.75MPへ引き上げた。小さな文字や密なUIを含む画像で差が出やすい。[4]
Claude Opus 4.7 API料金の見積もり:長文書・長い会話・バッチ処理の予算感
12 ソース0Claude Opus 4.7のClaude API公開価格は、inputが$5/MTok、outputが$25/MTok。単発の長文書分析はこの式で見積もれるが、長文書Q&Aや長い会話ではprompt cachingとキャッシュ命中率が重要になる。[2]
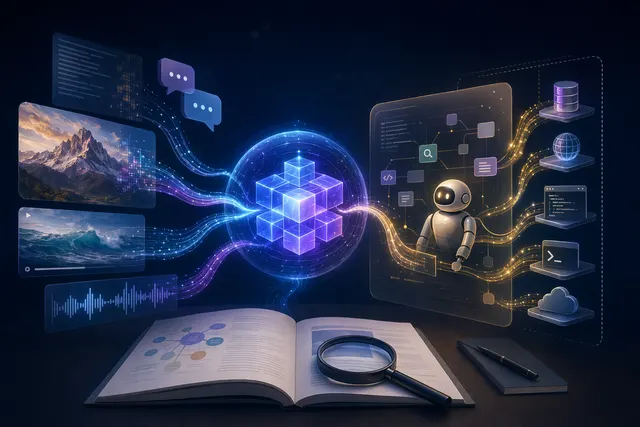
Kimi K2.6はネイティブ・マルチモーダルなのか 公式文書で読む本当の範囲
12 ソース0Kimi API文書はK2.6を native multimodal architecture と説明し、text・image・video input と Agent tasks をサポートするとしている。[1]