Memilih AI untuk Konten dan Marketing: OpenAI, Claude, DeepSeek, Gemini, atau Grok?
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4... Cara paling aman adalah membagi peran: OpenAI sebagai baseline umum, Claude untuk long form edit...
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4...
Cara paling aman adalah membagi peran: OpenAI sebagai baseline umum, Claude untuk long form editing dan brand voice, DeepSeek untuk produksi volume besar, Gemini untuk konteks panjang, dan Grok untuk pipeline berbasis...
Hitung biaya input tokens dan output tokens secara terpisah; brief panjang, transkrip, dan data kompetitor biasanya input heavy, sementara variasi iklan, deskripsi produk, dan repurposing konten cenderung output heavy...
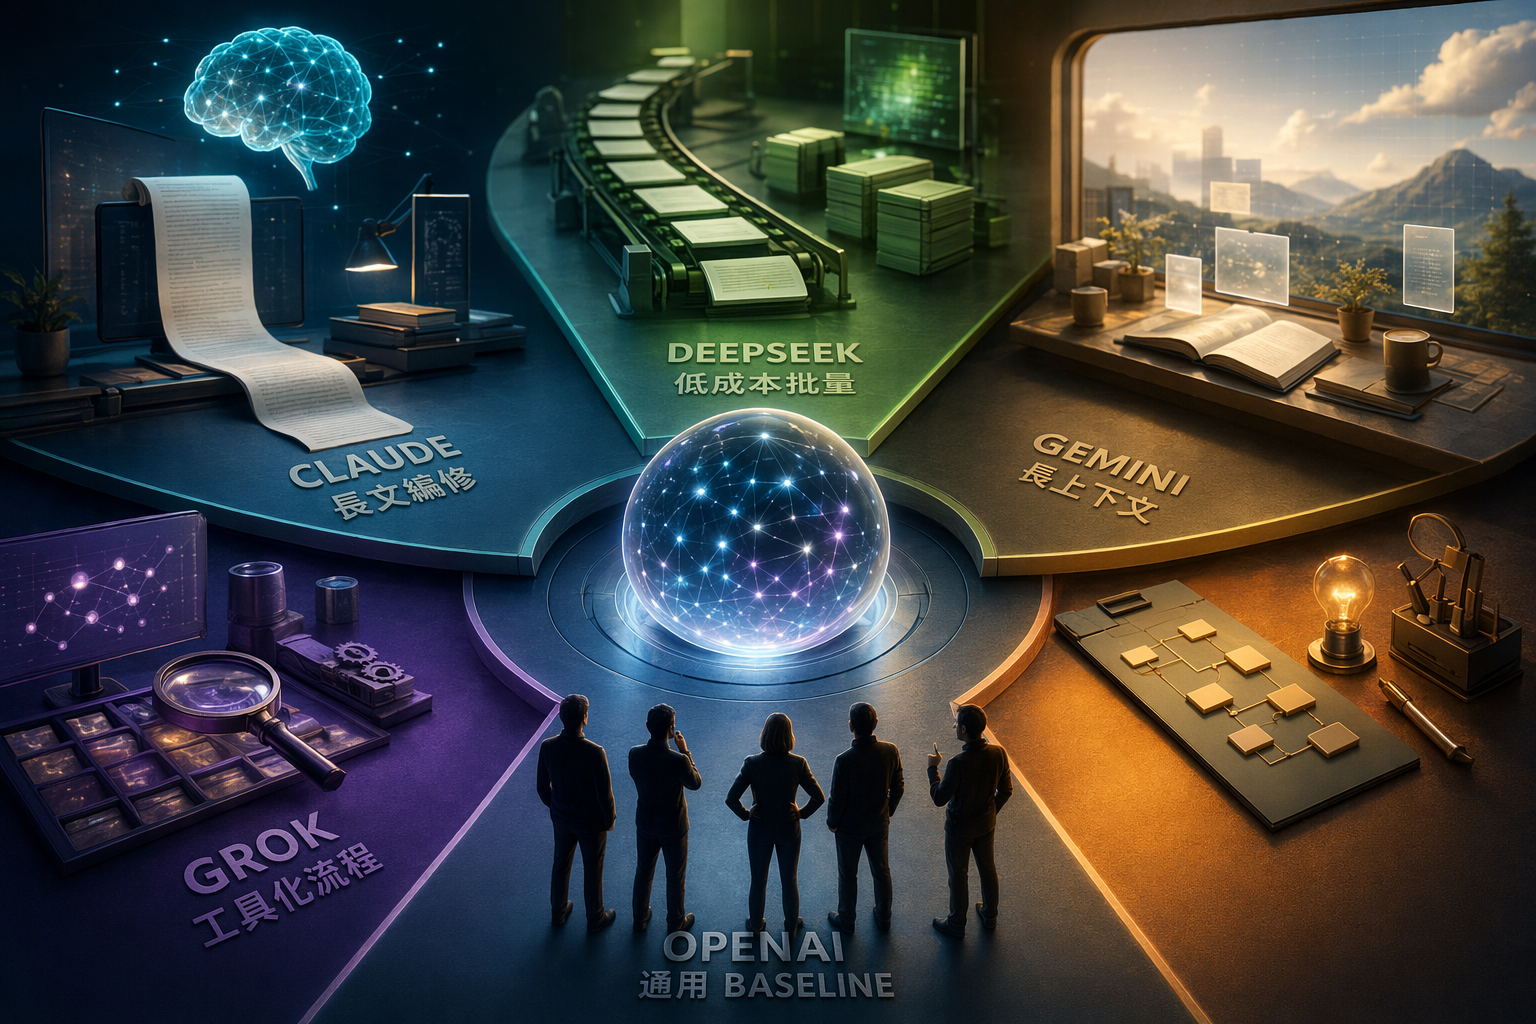
OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南AI 生成示意圖:內容團隊在研究、SEO、長文編修與自動化流程中比較不同 AI 模型。
AI Perintah
Create a landscape editorial hero image for this Studio Global article: OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南. Article summary: 截至 2026 年可引用的公開資料,沒有證據支持五者中有單一內容行銷冠軍;更務實的分工是 OpenAI 當通用 baseline、Claude 測長文編修、DeepSeek 跑低成本批量、Gemini 處理長上下文、Grok 評估工具化流程。最後仍要用自家 KPI 實測。. Topic tags: ai, content marketing, seo, openai, claude. Reference image context from search candidates: Reference image 1: visual subject "# 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂. 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 全解析,付費、應用與安全性一次看懂"). 近幾年有多款大型語言模型 (LLM) 接連問世,對一般用戶來說,到底哪一款最適合日常需求。本次整理 5 款主流 LLM,分別為 GPT‑" source context "2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 | 鏈新聞 ABMedia" Reference image 2: visual subject "## Loading. ## Loading. # 生命不息,折腾不止. ## 要有最朴素的生活,与最遥远的梦想。即使明日天寒地冻、路远马亡。. # 【译】Grok 3 vs ChatGPT vs DeepSeek vs Claude vs Gemini:2025年2月哪款AI最好?. 人工智能(AI)的进步速度前所未有,几乎每周都有新的模型和技术问世。20" source c
openai.com
Memilih model AI untuk tim konten sering kali terlihat seperti mencari pemenang liga: siapa yang paling pintar, paling murah, atau paling viral di benchmark. Masalahnya, kebutuhan content marketing jarang sesederhana itu. Data publik memang bisa membantu membandingkan harga API, context window, prompt caching, dan server-side tools, tetapi data itu belum cukup untuk membuktikan bahwa satu model pasti menghasilkan ranking SEO lebih tinggi, konversi iklan lebih baik, atau brand voice yang selalu konsisten.
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "Memilih AI untuk Konten dan Marketing: OpenAI, Claude, DeepSeek, Gemini, atau Grok?"?
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4...
Apa poin penting yang harus divalidasi terlebih dahulu?
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4... Cara paling aman adalah membagi peran: OpenAI sebagai baseline umum, Claude untuk long form editing dan brand voice, DeepSeek untuk produksi volume besar, Gemini untuk konteks panjang, dan Grok untuk pipeline berbasis...
Apa yang harus saya lakukan selanjutnya dalam latihan?
Hitung biaya input tokens dan output tokens secara terpisah; brief panjang, transkrip, dan data kompetitor biasanya input heavy, sementara variasi iklan, deskripsi produk, dan repurposing konten cenderung output heavy...
Memilih AI untuk Konten dan Marketing: OpenAI, Claude, DeepSeek, Gemini, atau Grok?
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4... Cara paling aman adalah membagi peran: OpenAI sebagai baseline umum, Claude untuk long form edit...
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4...
Cara paling aman adalah membagi peran: OpenAI sebagai baseline umum, Claude untuk long form editing dan brand voice, DeepSeek untuk produksi volume besar, Gemini untuk konteks panjang, dan Grok untuk pipeline berbasis...
Hitung biaya input tokens dan output tokens secara terpisah; brief panjang, transkrip, dan data kompetitor biasanya input heavy, sementara variasi iklan, deskripsi produk, dan repurposing konten cenderung output heavy...
OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南AI 生成示意圖:內容團隊在研究、SEO、長文編修與自動化流程中比較不同 AI 模型。
AI Perintah
Create a landscape editorial hero image for this Studio Global article: OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南. Article summary: 截至 2026 年可引用的公開資料,沒有證據支持五者中有單一內容行銷冠軍;更務實的分工是 OpenAI 當通用 baseline、Claude 測長文編修、DeepSeek 跑低成本批量、Gemini 處理長上下文、Grok 評估工具化流程。最後仍要用自家 KPI 實測。. Topic tags: ai, content marketing, seo, openai, claude. Reference image context from search candidates: Reference image 1: visual subject "# 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂. 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 全解析,付費、應用與安全性一次看懂"). 近幾年有多款大型語言模型 (LLM) 接連問世,對一般用戶來說,到底哪一款最適合日常需求。本次整理 5 款主流 LLM,分別為 GPT‑" source context "2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 | 鏈新聞 ABMedia" Reference image 2: visual subject "## Loading. ## Loading. # 生命不息,折腾不止. ## 要有最朴素的生活,与最遥远的梦想。即使明日天寒地冻、路远马亡。. # 【译】Grok 3 vs ChatGPT vs DeepSeek vs Claude vs Gemini:2025年2月哪款AI最好?. 人工智能(AI)的进步速度前所未有,几乎每周都有新的模型和技术问世。20" source c
openai.com
Memilih model AI untuk tim konten sering kali terlihat seperti mencari pemenang liga: siapa yang paling pintar, paling murah, atau paling viral di benchmark. Masalahnya, kebutuhan content marketing jarang sesederhana itu. Data publik memang bisa membantu membandingkan harga API, context window, prompt caching, dan server-side tools, tetapi data itu belum cukup untuk membuktikan bahwa satu model pasti menghasilkan ranking SEO lebih tinggi, konversi iklan lebih baik, atau brand voice yang selalu konsisten.
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "Memilih AI untuk Konten dan Marketing: OpenAI, Claude, DeepSeek, Gemini, atau Grok?"?
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4...
Apa poin penting yang harus divalidasi terlebih dahulu?
Data publik dapat membandingkan harga API, context window, prompt caching, dan tools, tetapi belum cukup untuk membuktikan satu model pasti paling unggul untuk ranking SEO, konversi iklan, atau konsistensi brand.[1][4... Cara paling aman adalah membagi peran: OpenAI sebagai baseline umum, Claude untuk long form editing dan brand voice, DeepSeek untuk produksi volume besar, Gemini untuk konteks panjang, dan Grok untuk pipeline berbasis...
Apa yang harus saya lakukan selanjutnya dalam latihan?
Hitung biaya input tokens dan output tokens secara terpisah; brief panjang, transkrip, dan data kompetitor biasanya input heavy, sementara variasi iklan, deskripsi produk, dan repurposing konten cenderung output heavy...
Pertanyaan yang lebih berguna bukan: model mana yang terbaik? Pertanyaan yang lebih tepat: model mana yang paling pas untuk bagian tertentu dalam workflow tim Anda?
Ringkasnya: jangan cari juara tunggal, bagi tugasnya
Tabel harga pihak ketiga mencantumkan beberapa lapisan model OpenAI dengan variasi harga input/output dan pilihan context; TLDL juga mendeskripsikan keluarga GPT-4.1 dengan context 1 juta token dan harga kelas menengah.
Bagus sebagai baseline, bukan bukti bahwa OpenAI selalu nomor satu di semua tugas konten.
Dokumen resmi Anthropic untuk Claude API memisahkan Base Input Tokens, Cache Writes, Cache Hits, dan Output Tokens, sehingga cocok untuk workflow yang sering memakai pedoman brand, template, atau aturan review yang sama.
Nilai dari rasio siap tayang, waktu editing manusia, dan konsistensi brand; jangan hanya menilai enak tidaknya draft pertama.
Draft SEO massal, deskripsi produk, FAQ, variasi iklan
DeepSeek
DeepSeek memiliki dokumen resmi Models & Pricing; panduan pihak ketiga menyebut unified pricing chat/reasoning sekitar US$0,28 per juta input tokens dan US$0,42 per juta output tokens, serta mengklaim penurunan biaya 94–96% dibanding OpenAI o3 atau GPT-4.1.
Biaya rendah cocok untuk volume besar, tetapi tetap perlu fact-checking dan review brand.
Brief sangat panjang, data kompetitor, transkrip, keyword pack, dokumen produk
Gemini
MorphLLM mencantumkan Gemini 2.5 Flash dengan context 1 juta token, harga US$2,50 per juta output tokens, dan free tier; TLDL menempatkan Gemini 2.5 Pro di kelompok context 2 juta token.
Spesifikasi Gemini di artikel ini terutama berasal dari komparasi pihak ketiga; cek ulang dokumen vendor sebelum membeli.
Tool calling, automasi konten, workflow dengan server-side tools
Grok
Dokumen resmi xAI menyediakan Models and Pricing dan memisahkan Tools Pricing untuk server-side tools; TLDL juga menyebut xAI memiliki dua model dengan context 2 juta token.
Layak diuji untuk pipeline berbasis tools, tetapi data di sini belum cukup untuk menyatakan Grok unggul stabil dalam copywriting marketing umum.
Mulai dari biaya: input-heavy dan output-heavy itu berbeda
API generasi teks umumnya dihitung berdasarkan token usage. Sederhananya, input tokens adalah teks yang Anda kirim ke model, seperti prompt, brief, data produk, transkrip, atau dokumen referensi. Output tokens adalah teks yang dihasilkan model. Tiap penyedia menetapkan harga berbeda per 1.000.000 token.
Dari sini, pekerjaan konten biasanya terbagi menjadi dua pola biaya:
Input-heavy: merangkum halaman kompetitor, menganalisis transkrip wawancara, membaca dokumen produk, mengolah keyword pack SEO, atau membuat brief panjang. Beban biayanya muncul karena banyak bahan dimasukkan ke model.
Output-heavy: membuat banyak headline iklan, deskripsi produk, FAQ, caption media sosial, variasi A/B copy, atau adaptasi multibahasa. Beban biayanya datang dari banyaknya teks yang dihasilkan.
Untuk tim yang selalu memasukkan brand voice guide, batasan legal, template SEO, atau format editorial yang sama, prompt caching perlu masuk perhitungan. Dokumen harga Claude secara resmi memisahkan cache writes dan cache hits, yang berarti konteks berulang bukan cuma urusan desain prompt, tetapi juga bagian dari perencanaan biaya dan workflow.
OpenAI: baseline umum yang mudah dijadikan pembanding
OpenAI layak dijadikan titik awal pengujian. Alasannya bukan karena data publik membuktikan OpenAI selalu paling bagus untuk semua pekerjaan marketing, melainkan karena tabel harga pihak ketiga menunjukkan beberapa lapisan model OpenAI. Ini memudahkan tim membuat pembagian: model yang lebih kuat untuk strategi, riset, dan finalisasi; model yang lebih murah untuk ringkasan, rewriting, dan variasi massal.
TLDL mendeskripsikan keluarga GPT-4.1 dengan context 1 juta token dan harga kelas menengah, sehingga masuk akal untuk diuji pada brief panjang, rangkuman riset, dan penyusunan rencana konten. Namun, ada catatan penting: data harga dan context OpenAI yang digunakan di artikel ini terutama berasal dari agregator atau komparasi pihak ketiga, bukan kutipan langsung dari dokumen resmi OpenAI.
Tugas yang cocok diuji lebih dulu: outline halaman pilar SEO, campaign messaging, ringkasan riset, draft artikel panjang, variasi judul, email marketing, dan repurposing konten sosial. Saat menguji, pisahkan catatan kualitas dan biaya, karena model dalam satu penyedia pun bisa punya context window dan harga per juta token yang berbeda.
Claude: kuat untuk long-form editing dan konsistensi brand
Claude menarik untuk tim yang banyak mengerjakan naskah panjang dan proses editorial berulang. Dokumen resmi Claude API dari Anthropic mencantumkan Base Input Tokens, Cache Writes, Cache Hits, dan Output Tokens. Bagi tim yang sering memakai pedoman brand voice, aturan editorial, batasan legal, atau template artikel yang sama, struktur ini membuat prompt caching bisa dimasukkan ke desain biaya sejak awal.
Jadi, Claude sebaiknya tidak disederhanakan menjadi model yang paling jago menulis. Posisi yang lebih tepat: kandidat kuat untuk A/B test pada rewriting artikel panjang, penyusunan ulang white paper, penyamaan tone of voice, pemeriksaan pedoman editorial, dan perbaikan struktur naskah.
Ukuran keberhasilannya juga harus praktis: berapa persen draft yang siap tayang, berapa lama editor manusia memperbaikinya, seberapa konsisten dengan brand, dan berapa banyak kesalahan faktual yang masih lolos. Draft yang terasa halus saat dibaca belum tentu paling efisien untuk workflow produksi.
DeepSeek: masuk akal untuk draft dan variasi volume besar
Daya tarik utama DeepSeek adalah biaya. DeepSeek menyediakan dokumen resmi Models & Pricing; sementara itu, panduan harga DecodesFuture 2026 mendeskripsikan unified pricing untuk chat dan reasoning sekitar US$0,28 per juta input tokens dan US$0,42 per juta output tokens, serta menyebut biaya itu 94–96% lebih rendah dibanding OpenAI o3 atau GPT-4.1.
Karena itu, DeepSeek cocok ditempatkan di tahap awal produksi: draft long-tail SEO, deskripsi produk, FAQ, variasi iklan, draft lokalisasi multibahasa, dan ide posting media sosial. Untuk pekerjaan seperti ini, biaya per output menjadi penting karena tim bisa menghasilkan ratusan atau ribuan variasi.
Namun, biaya rendah bukan berarti teks langsung layak tayang. Justru saat volume produksi naik, risiko kesalahan faktual, inkonsistensi tone, dan format yang melenceng ikut membesar. DeepSeek paling aman dipakai bersama checklist fact-checking, review brand, dan validasi format yang jelas.
Gemini: kandidat kuat untuk pekerjaan dengan konteks sangat panjang
Alasan utama memasukkan Gemini ke daftar uji adalah long context. MorphLLM mencantumkan Gemini 2.5 Flash dengan context 1 juta token, harga US$2,50 per juta output tokens, dan free tier. TLDL juga memasukkan Gemini 2.5 Pro ke kelompok model dengan context 2 juta token.
Untuk tim marketing, long context sangat berguna ketika kualitas output bergantung pada banyak bahan: halaman kompetitor, transkrip sales call, keyword pack, dokumentasi produk, wawancara pelanggan, dan arsip konten brand. Dalam banyak proyek, masalahnya bukan model tidak bisa menulis, melainkan model tidak diberi cukup konteks untuk memahami produk, audiens, dan posisi brand.
Gemini layak diuji untuk tugas seperti menyusun brief besar, meringkas kumpulan dokumen, membuat peta pesan dari banyak sumber, atau mengubah materi riset menjadi struktur konten. Tetapi, spesifikasi Gemini yang dikutip di sini terutama berasal dari komparasi pihak ketiga. Untuk keputusan anggaran, batas penggunaan, dan integrasi produksi, tetap cek dokumen vendor yang Anda pakai.
Grok: uji untuk pipeline, bukan hanya satu kali copywriting
Grok sebaiknya tidak dinilai hanya dari satu prompt untuk membuat caption atau iklan. Dokumen resmi xAI menyediakan Models and Pricing dan memisahkan Tools Pricing untuk server-side tools. Ini relevan untuk tim yang ingin menyambungkan model ke tools, sumber data, atau pipeline konten otomatis.
TLDL juga menyebut xAI memiliki dua model dengan context 2 juta token, serta membedakan posisi Grok 4 dan Grok 4.1 Fast. Artinya, Grok layak masuk daftar uji jika workflow Anda menekankan tool calling, koneksi data, automasi, atau orkestrasi proses.
Namun, berdasarkan data yang tersedia di artikel ini, belum ada dasar kuat untuk menyatakan Grok secara konsisten mengalahkan OpenAI atau Claude dalam kualitas copywriting marketing umum. Penempatan yang lebih aman: Grok sebagai kandidat untuk workflow yang lebih teknis dan terotomasi, bukan otomatis sebagai penulis utama.
Cara membuat uji model yang adil
Harga dan spesifikasi publik hanya membantu mempersempit pilihan. Keputusan akhir tetap harus dibuat dari pengujian kecil dengan bahan, batasan, dan KPI yang sama. Satu set uji sederhana bisa mencakup:
SEO brief: berikan keyword, search intent, ringkasan kompetitor, dan data produk. Minta model membuat outline, poin tiap bagian, serta daftar klaim yang perlu diverifikasi.
Editing artikel panjang: berikan draft dan brand voice guide. Minta model menulis ulang tanpa mengubah fakta, lalu jelaskan perubahan utama.
Variasi iklan: minta beberapa versi headline, primary text, dan CTA. Cek apakah sesuai dengan brand dan batasan platform.
Repurposing konten: ubah artikel panjang menjadi format LinkedIn, X, Threads, newsletter, dan naskah video pendek.
Penandaan ketidakpastian: minta model menandai kalimat yang perlu dicek, bukan mengisi kekosongan dengan jawaban yang terdengar yakin.
Jangan hanya menilai mana yang paling enak dibaca. Catat rasio siap tayang, waktu editing manusia, konsistensi brand, tingkat kesalahan faktual, stabilitas format, biaya per tugas, dan total biaya saat dijalankan massal. Karena biaya API dipengaruhi input tokens dan output tokens secara terpisah, tugas input-heavy dan output-heavy sebaiknya dihitung dengan skenario yang berbeda.
Formula awal yang paling praktis
Jika ingin mulai cepat, gunakan pembagian ini: OpenAI sebagai baseline umum, Claude untuk long-form editing dan brand voice, DeepSeek untuk produksi murah berskala besar, Gemini untuk konteks panjang, dan Grok untuk pipeline berbasis tools.
Anggap ini sebagai matriks uji, bukan ranking mutlak. Model terbaik untuk tim Anda akan ditentukan oleh bahasa yang dipakai, pasar yang dituju, pedoman brand, proses review, dan KPI konten. Dalam content marketing, model yang paling mahal belum tentu paling efisien; model yang paling murah pun belum tentu paling siap tayang.
Pertanyaan yang lebih berguna bukan: model mana yang terbaik? Pertanyaan yang lebih tepat: model mana yang paling pas untuk bagian tertentu dalam workflow tim Anda?
Ringkasnya: jangan cari juara tunggal, bagi tugasnya
Tabel harga pihak ketiga mencantumkan beberapa lapisan model OpenAI dengan variasi harga input/output dan pilihan context; TLDL juga mendeskripsikan keluarga GPT-4.1 dengan context 1 juta token dan harga kelas menengah.
Bagus sebagai baseline, bukan bukti bahwa OpenAI selalu nomor satu di semua tugas konten.
Dokumen resmi Anthropic untuk Claude API memisahkan Base Input Tokens, Cache Writes, Cache Hits, dan Output Tokens, sehingga cocok untuk workflow yang sering memakai pedoman brand, template, atau aturan review yang sama.
Nilai dari rasio siap tayang, waktu editing manusia, dan konsistensi brand; jangan hanya menilai enak tidaknya draft pertama.
Draft SEO massal, deskripsi produk, FAQ, variasi iklan
DeepSeek
DeepSeek memiliki dokumen resmi Models & Pricing; panduan pihak ketiga menyebut unified pricing chat/reasoning sekitar US$0,28 per juta input tokens dan US$0,42 per juta output tokens, serta mengklaim penurunan biaya 94–96% dibanding OpenAI o3 atau GPT-4.1.
Biaya rendah cocok untuk volume besar, tetapi tetap perlu fact-checking dan review brand.
Brief sangat panjang, data kompetitor, transkrip, keyword pack, dokumen produk
Gemini
MorphLLM mencantumkan Gemini 2.5 Flash dengan context 1 juta token, harga US$2,50 per juta output tokens, dan free tier; TLDL menempatkan Gemini 2.5 Pro di kelompok context 2 juta token.
Spesifikasi Gemini di artikel ini terutama berasal dari komparasi pihak ketiga; cek ulang dokumen vendor sebelum membeli.
Tool calling, automasi konten, workflow dengan server-side tools
Grok
Dokumen resmi xAI menyediakan Models and Pricing dan memisahkan Tools Pricing untuk server-side tools; TLDL juga menyebut xAI memiliki dua model dengan context 2 juta token.
Layak diuji untuk pipeline berbasis tools, tetapi data di sini belum cukup untuk menyatakan Grok unggul stabil dalam copywriting marketing umum.
Mulai dari biaya: input-heavy dan output-heavy itu berbeda
API generasi teks umumnya dihitung berdasarkan token usage. Sederhananya, input tokens adalah teks yang Anda kirim ke model, seperti prompt, brief, data produk, transkrip, atau dokumen referensi. Output tokens adalah teks yang dihasilkan model. Tiap penyedia menetapkan harga berbeda per 1.000.000 token.
Dari sini, pekerjaan konten biasanya terbagi menjadi dua pola biaya:
Input-heavy: merangkum halaman kompetitor, menganalisis transkrip wawancara, membaca dokumen produk, mengolah keyword pack SEO, atau membuat brief panjang. Beban biayanya muncul karena banyak bahan dimasukkan ke model.
Output-heavy: membuat banyak headline iklan, deskripsi produk, FAQ, caption media sosial, variasi A/B copy, atau adaptasi multibahasa. Beban biayanya datang dari banyaknya teks yang dihasilkan.
Untuk tim yang selalu memasukkan brand voice guide, batasan legal, template SEO, atau format editorial yang sama, prompt caching perlu masuk perhitungan. Dokumen harga Claude secara resmi memisahkan cache writes dan cache hits, yang berarti konteks berulang bukan cuma urusan desain prompt, tetapi juga bagian dari perencanaan biaya dan workflow.
OpenAI: baseline umum yang mudah dijadikan pembanding
OpenAI layak dijadikan titik awal pengujian. Alasannya bukan karena data publik membuktikan OpenAI selalu paling bagus untuk semua pekerjaan marketing, melainkan karena tabel harga pihak ketiga menunjukkan beberapa lapisan model OpenAI. Ini memudahkan tim membuat pembagian: model yang lebih kuat untuk strategi, riset, dan finalisasi; model yang lebih murah untuk ringkasan, rewriting, dan variasi massal.
TLDL mendeskripsikan keluarga GPT-4.1 dengan context 1 juta token dan harga kelas menengah, sehingga masuk akal untuk diuji pada brief panjang, rangkuman riset, dan penyusunan rencana konten. Namun, ada catatan penting: data harga dan context OpenAI yang digunakan di artikel ini terutama berasal dari agregator atau komparasi pihak ketiga, bukan kutipan langsung dari dokumen resmi OpenAI.
Tugas yang cocok diuji lebih dulu: outline halaman pilar SEO, campaign messaging, ringkasan riset, draft artikel panjang, variasi judul, email marketing, dan repurposing konten sosial. Saat menguji, pisahkan catatan kualitas dan biaya, karena model dalam satu penyedia pun bisa punya context window dan harga per juta token yang berbeda.
Claude: kuat untuk long-form editing dan konsistensi brand
Claude menarik untuk tim yang banyak mengerjakan naskah panjang dan proses editorial berulang. Dokumen resmi Claude API dari Anthropic mencantumkan Base Input Tokens, Cache Writes, Cache Hits, dan Output Tokens. Bagi tim yang sering memakai pedoman brand voice, aturan editorial, batasan legal, atau template artikel yang sama, struktur ini membuat prompt caching bisa dimasukkan ke desain biaya sejak awal.
Jadi, Claude sebaiknya tidak disederhanakan menjadi model yang paling jago menulis. Posisi yang lebih tepat: kandidat kuat untuk A/B test pada rewriting artikel panjang, penyusunan ulang white paper, penyamaan tone of voice, pemeriksaan pedoman editorial, dan perbaikan struktur naskah.
Ukuran keberhasilannya juga harus praktis: berapa persen draft yang siap tayang, berapa lama editor manusia memperbaikinya, seberapa konsisten dengan brand, dan berapa banyak kesalahan faktual yang masih lolos. Draft yang terasa halus saat dibaca belum tentu paling efisien untuk workflow produksi.
DeepSeek: masuk akal untuk draft dan variasi volume besar
Daya tarik utama DeepSeek adalah biaya. DeepSeek menyediakan dokumen resmi Models & Pricing; sementara itu, panduan harga DecodesFuture 2026 mendeskripsikan unified pricing untuk chat dan reasoning sekitar US$0,28 per juta input tokens dan US$0,42 per juta output tokens, serta menyebut biaya itu 94–96% lebih rendah dibanding OpenAI o3 atau GPT-4.1.
Karena itu, DeepSeek cocok ditempatkan di tahap awal produksi: draft long-tail SEO, deskripsi produk, FAQ, variasi iklan, draft lokalisasi multibahasa, dan ide posting media sosial. Untuk pekerjaan seperti ini, biaya per output menjadi penting karena tim bisa menghasilkan ratusan atau ribuan variasi.
Namun, biaya rendah bukan berarti teks langsung layak tayang. Justru saat volume produksi naik, risiko kesalahan faktual, inkonsistensi tone, dan format yang melenceng ikut membesar. DeepSeek paling aman dipakai bersama checklist fact-checking, review brand, dan validasi format yang jelas.
Gemini: kandidat kuat untuk pekerjaan dengan konteks sangat panjang
Alasan utama memasukkan Gemini ke daftar uji adalah long context. MorphLLM mencantumkan Gemini 2.5 Flash dengan context 1 juta token, harga US$2,50 per juta output tokens, dan free tier. TLDL juga memasukkan Gemini 2.5 Pro ke kelompok model dengan context 2 juta token.
Untuk tim marketing, long context sangat berguna ketika kualitas output bergantung pada banyak bahan: halaman kompetitor, transkrip sales call, keyword pack, dokumentasi produk, wawancara pelanggan, dan arsip konten brand. Dalam banyak proyek, masalahnya bukan model tidak bisa menulis, melainkan model tidak diberi cukup konteks untuk memahami produk, audiens, dan posisi brand.
Gemini layak diuji untuk tugas seperti menyusun brief besar, meringkas kumpulan dokumen, membuat peta pesan dari banyak sumber, atau mengubah materi riset menjadi struktur konten. Tetapi, spesifikasi Gemini yang dikutip di sini terutama berasal dari komparasi pihak ketiga. Untuk keputusan anggaran, batas penggunaan, dan integrasi produksi, tetap cek dokumen vendor yang Anda pakai.
Grok: uji untuk pipeline, bukan hanya satu kali copywriting
Grok sebaiknya tidak dinilai hanya dari satu prompt untuk membuat caption atau iklan. Dokumen resmi xAI menyediakan Models and Pricing dan memisahkan Tools Pricing untuk server-side tools. Ini relevan untuk tim yang ingin menyambungkan model ke tools, sumber data, atau pipeline konten otomatis.
TLDL juga menyebut xAI memiliki dua model dengan context 2 juta token, serta membedakan posisi Grok 4 dan Grok 4.1 Fast. Artinya, Grok layak masuk daftar uji jika workflow Anda menekankan tool calling, koneksi data, automasi, atau orkestrasi proses.
Namun, berdasarkan data yang tersedia di artikel ini, belum ada dasar kuat untuk menyatakan Grok secara konsisten mengalahkan OpenAI atau Claude dalam kualitas copywriting marketing umum. Penempatan yang lebih aman: Grok sebagai kandidat untuk workflow yang lebih teknis dan terotomasi, bukan otomatis sebagai penulis utama.
Cara membuat uji model yang adil
Harga dan spesifikasi publik hanya membantu mempersempit pilihan. Keputusan akhir tetap harus dibuat dari pengujian kecil dengan bahan, batasan, dan KPI yang sama. Satu set uji sederhana bisa mencakup:
SEO brief: berikan keyword, search intent, ringkasan kompetitor, dan data produk. Minta model membuat outline, poin tiap bagian, serta daftar klaim yang perlu diverifikasi.
Editing artikel panjang: berikan draft dan brand voice guide. Minta model menulis ulang tanpa mengubah fakta, lalu jelaskan perubahan utama.
Variasi iklan: minta beberapa versi headline, primary text, dan CTA. Cek apakah sesuai dengan brand dan batasan platform.
Repurposing konten: ubah artikel panjang menjadi format LinkedIn, X, Threads, newsletter, dan naskah video pendek.
Penandaan ketidakpastian: minta model menandai kalimat yang perlu dicek, bukan mengisi kekosongan dengan jawaban yang terdengar yakin.
Jangan hanya menilai mana yang paling enak dibaca. Catat rasio siap tayang, waktu editing manusia, konsistensi brand, tingkat kesalahan faktual, stabilitas format, biaya per tugas, dan total biaya saat dijalankan massal. Karena biaya API dipengaruhi input tokens dan output tokens secara terpisah, tugas input-heavy dan output-heavy sebaiknya dihitung dengan skenario yang berbeda.
Formula awal yang paling praktis
Jika ingin mulai cepat, gunakan pembagian ini: OpenAI sebagai baseline umum, Claude untuk long-form editing dan brand voice, DeepSeek untuk produksi murah berskala besar, Gemini untuk konteks panjang, dan Grok untuk pipeline berbasis tools.
Anggap ini sebagai matriks uji, bukan ranking mutlak. Model terbaik untuk tim Anda akan ditentukan oleh bahasa yang dipakai, pasar yang dituju, pedoman brand, proses review, dan KPI konten. Dalam content marketing, model yang paling mahal belum tentu paling efisien; model yang paling murah pun belum tentu paling siap tayang.
platform.claude.comPricing - Claude API Docs
pecollective.comCross-Provider LLM API Pricing Comparison (April 2026)
tldl.ioLLM API Pricing 2026 — Compare GPT-5, Claude 4, Gemini 2.5 ...
docs.x.aiModels and Pricing - xAI Docs
aipricingcomparison.comCompare OpenAI & Top LLM API Pricing Instantly - AI Pricing Comparison