Claude Opus 4.7 vs GPT-5.4, Gemini 3.1 Pro, Grok 4: Pilih yang Mana?
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih... GPT 5.4 lebih menarik untuk structured reasoning dan computer use; Gemini 3.1 Pro kuat untuk inpu...
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih...
GPT 5.4 lebih menarik untuk structured reasoning dan computer use; Gemini 3.1 Pro kuat untuk input multimodal, penalaran abstrak, dan benchmark ilmiah; Grok 4 menonjol pada indikator HLE untuk penalaran sulit.[5]
Sebelum dipakai tim atau dibeli untuk produksi, bandingkan 3 sampai 5 model dengan 5 sampai 10 tugas nyata.
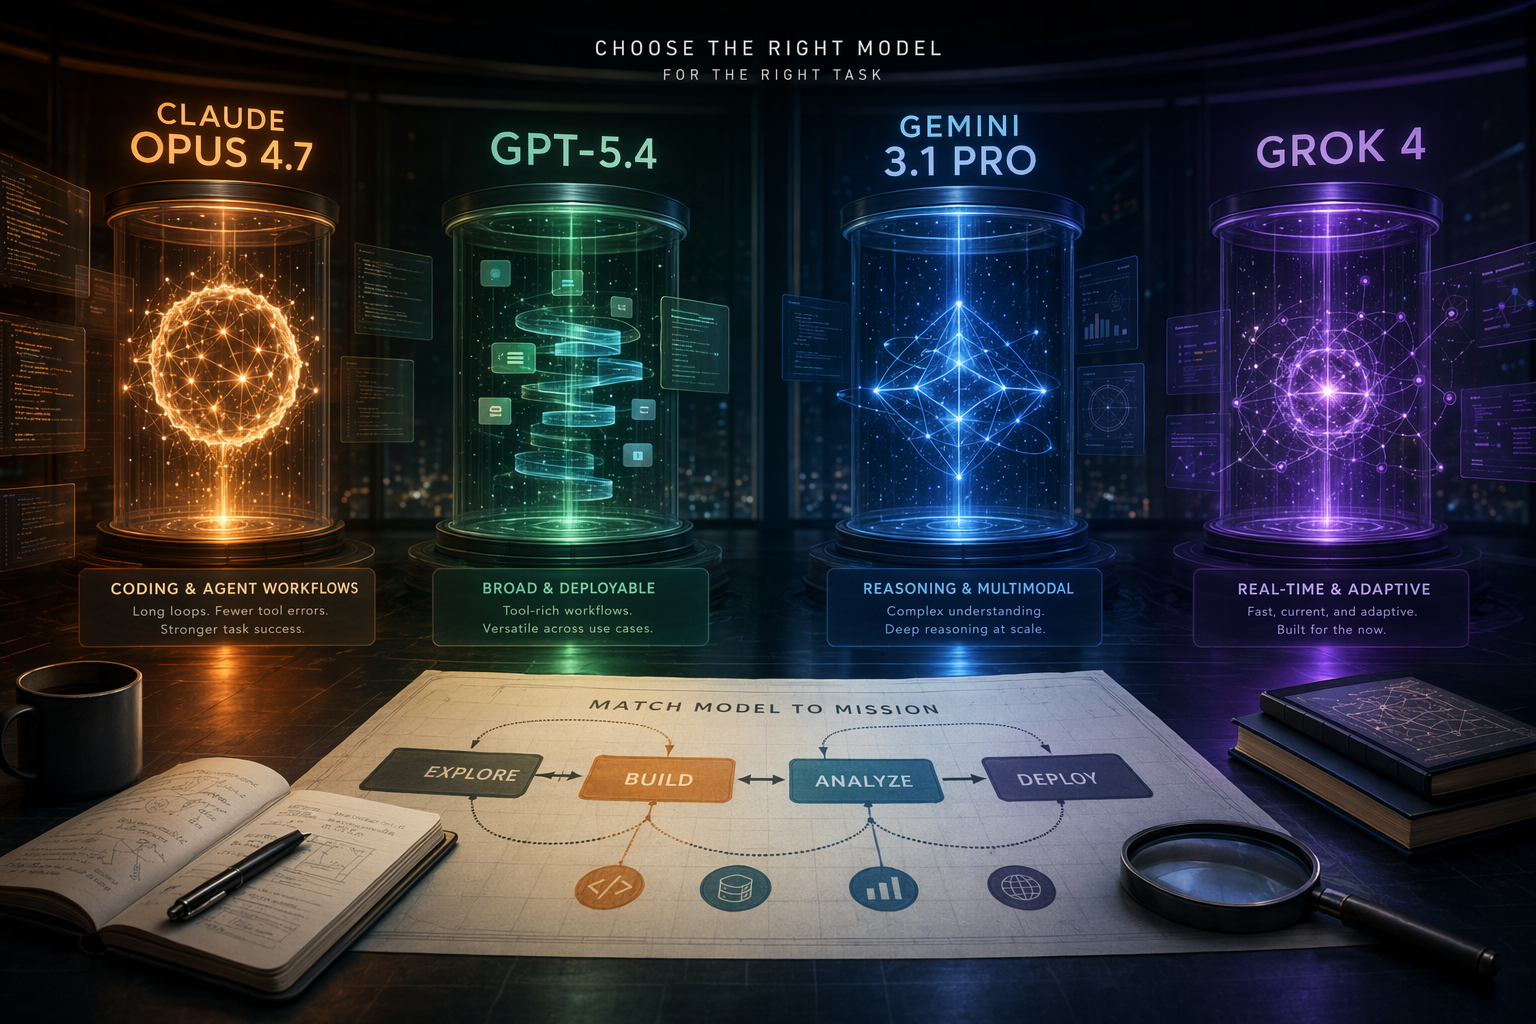
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
AI Perintah
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
Pertanyaan paling praktis saat membandingkan Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, dan Grok 4 bukanlah siapa juara mutlak. Pertanyaan yang lebih berguna: pekerjaan Anda biasanya gagal di bagian mana?
Panduan pemilihan LLM pihak ketiga menyimpulkan bahwa tidak ada satu model yang mendominasi semua jenis tugas. Masing-masing punya medan kuat: coding, penalaran terstruktur, multimodal, soal ilmiah, atau benchmark penalaran tingkat tinggi.
Ringkasan cepat: pilih berdasarkan pekerjaan
Kebutuhan utama Anda
Model yang paling layak dites dulu
Dasar bukti saat ini
Catatan penting
Coding kompleks, agent workflow, dan pemanggilan tool yang stabil
Claude Opus 4.7
Anthropic menyebut Opus 4.7 unggul atas Opus 4.6 dengan kenaikan 10% hingga 15% pada tingkat keberhasilan tugas Factory Droids, lebih sedikit tool error, dan performa lebih andal. Axios juga menggambarkannya sebagai peningkatan flagship dengan coding dan vision yang lebih baik.
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "Claude Opus 4.7 vs GPT-5.4, Gemini 3.1 Pro, Grok 4: Pilih yang Mana?"?
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih...
Apa poin penting yang harus divalidasi terlebih dahulu?
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih... GPT 5.4 lebih menarik untuk structured reasoning dan computer use; Gemini 3.1 Pro kuat untuk input multimodal, penalaran abstrak, dan benchmark ilmiah; Grok 4 menonjol pada indikator HLE untuk penalaran sulit.[5]
Apa yang harus saya lakukan selanjutnya dalam latihan?
Sebelum dipakai tim atau dibeli untuk produksi, bandingkan 3 sampai 5 model dengan 5 sampai 10 tugas nyata.
Claude Opus 4.7 vs GPT-5.4, Gemini 3.1 Pro, Grok 4: Pilih yang Mana?
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih... GPT 5.4 lebih menarik untuk structured reasoning dan computer use; Gemini 3.1 Pro kuat untuk inpu...
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih...
GPT 5.4 lebih menarik untuk structured reasoning dan computer use; Gemini 3.1 Pro kuat untuk input multimodal, penalaran abstrak, dan benchmark ilmiah; Grok 4 menonjol pada indikator HLE untuk penalaran sulit.[5]
Sebelum dipakai tim atau dibeli untuk produksi, bandingkan 3 sampai 5 model dengan 5 sampai 10 tugas nyata.
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
AI Perintah
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
Pertanyaan paling praktis saat membandingkan Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, dan Grok 4 bukanlah siapa juara mutlak. Pertanyaan yang lebih berguna: pekerjaan Anda biasanya gagal di bagian mana?
Panduan pemilihan LLM pihak ketiga menyimpulkan bahwa tidak ada satu model yang mendominasi semua jenis tugas. Masing-masing punya medan kuat: coding, penalaran terstruktur, multimodal, soal ilmiah, atau benchmark penalaran tingkat tinggi.
Ringkasan cepat: pilih berdasarkan pekerjaan
Kebutuhan utama Anda
Model yang paling layak dites dulu
Dasar bukti saat ini
Catatan penting
Coding kompleks, agent workflow, dan pemanggilan tool yang stabil
Claude Opus 4.7
Anthropic menyebut Opus 4.7 unggul atas Opus 4.6 dengan kenaikan 10% hingga 15% pada tingkat keberhasilan tugas Factory Droids, lebih sedikit tool error, dan performa lebih andal. Axios juga menggambarkannya sebagai peningkatan flagship dengan coding dan vision yang lebih baik.
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "Claude Opus 4.7 vs GPT-5.4, Gemini 3.1 Pro, Grok 4: Pilih yang Mana?"?
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih...
Apa poin penting yang harus divalidasi terlebih dahulu?
Untuk coding kompleks dan agent workflow, Claude Opus 4.7 layak masuk daftar uji pertama: Anthropic menyebutnya 10% hingga 15% lebih baik daripada Opus 4.6 pada tingkat keberhasilan tugas Factory Droids, dengan lebih... GPT 5.4 lebih menarik untuk structured reasoning dan computer use; Gemini 3.1 Pro kuat untuk input multimodal, penalaran abstrak, dan benchmark ilmiah; Grok 4 menonjol pada indikator HLE untuk penalaran sulit.[5]
Apa yang harus saya lakukan selanjutnya dalam latihan?
Sebelum dipakai tim atau dibeli untuk produksi, bandingkan 3 sampai 5 model dengan 5 sampai 10 tugas nyata.
Bukti ini terutama menunjukkan peningkatan Opus 4.7 dibanding Opus 4.6, bukan kemenangan langsung atas semua model lain.
Proses ketat, structured reasoning, dan computer use
GPT-5.4
Panduan pihak ketiga menyebut GPT-5.4 kuat pada structured reasoning dan computer use, serta mencantumkan OSWorld 75%.
Tetap perlu diuji memakai alur kerja, tool, dan standar kesalahan Anda sendiri.
Input multimodal, penalaran abstrak, soal ilmiah, dan bantuan riset
Gemini 3.1 Pro
Panduan pihak ketiga menyebut Gemini 3.1 Pro unggul pada abstract reasoning, multimodal input, dan scientific benchmarks, termasuk GPQA 94,3%.
Kuat di multimodal dan benchmark ilmiah tidak otomatis berarti paling kuat untuk coding agent atau workflow panjang.
Benchmark penalaran sulit
Grok 4
Panduan pihak ketiga menyebut Grok 4 memimpin pada indikator HLE dengan angka 50,7%.
Satu skor penalaran sulit tidak bisa langsung disamaratakan sebagai kemenangan di semua pekerjaan bisnis.
Diversifikasi vendor, biaya, atau eksplorasi model alternatif
MiniMax, GLM, Kimi, dan model baru lain
Panduan yang sama menyebut MiniMax M2.5/M2.7, GLM-5/5.1, dan Kimi K2.5 mulai menyaingi model proprietary frontier pada tugas sejenis SWE-bench.
Mendekati di SWE-bench tidak berarti sama kuat pada stabilitas API, multimodal, penulisan, keamanan, atau integrasi produk.
Claude Opus 4.7: kuat untuk coding dan keandalan tool
Sinyal paling penting dari Claude Opus 4.7 adalah penekanan Anthropic pada tingkat keberhasilan tugas dan pengurangan kesalahan saat memakai tool. Di halaman resminya, Anthropic menyebut Claude Opus 4.7 mengungguli Opus 4.6 dengan kenaikan 10% hingga 15% pada task success Factory Droids, disertai lebih sedikit tool error dan performa yang lebih andal.
Ini membuat Opus 4.7 menarik untuk diuji lebih awal oleh tim software, tim data, atau siapa pun yang membangun workflow berbasis agent. Dalam pekerjaan seperti ini, kegagalan sering bukan sekadar jawaban salah. Masalahnya bisa berupa tool call yang tidak stabil, konteks yang hilang di tengah jalan, file yang salah diedit, atau model yang perlu dikoreksi manusia berkali-kali.
Axios juga melaporkan Opus 4.7 sebagai peningkatan bermakna untuk model flagship Anthropic, dengan sorotan pada coding yang lebih baik dan vision yang lebih tajam.
Namun batasnya jelas: data tersebut paling aman dibaca sebagai bukti bahwa Opus 4.7 meningkat dari Opus 4.6. Sumber yang tersedia belum cukup untuk menyimpulkan bahwa Opus 4.7 pasti mengalahkan GPT-5.4, Gemini 3.1 Pro, dan Grok 4 di semua kondisi.
GPT-5.4: perhatikan jika pekerjaan Anda sangat prosedural
Jika pekerjaan Anda banyak berisi aturan ketat, tabel keputusan, alur operasional, desktop automation, atau koordinasi beberapa tool, GPT-5.4 perlu masuk daftar uji awal. Panduan LLM pihak ketiga menyebut GPT-5.4 menonjol pada structured reasoning dan computer use, dengan OSWorld 75%.
Istilah computer use di sini merujuk pada kemampuan model menjalankan atau mengarahkan tindakan di lingkungan komputer, bukan hanya menjawab pertanyaan teks. Untuk tim yang membangun otomasi internal, ini bisa lebih penting daripada skor menulis esai atau benchmark coding murni.
Tetapi ini tidak berarti GPT-5.4 otomatis lebih baik daripada Opus 4.7 untuk semua hal. Kesimpulan praktisnya: bila biaya kegagalan terbesar Anda berasal dari salah langkah, salah urutan proses, atau salah memakai tool, uji GPT-5.4 berdampingan dengan Claude Opus 4.7.
Gemini 3.1 Pro: prioritaskan untuk multimodal dan pekerjaan ilmiah
Jika data Anda sering berupa gambar, grafik, tangkapan layar dokumen, diagram, atau pertanyaan ilmiah, Gemini 3.1 Pro layak diprioritaskan. Panduan pihak ketiga menyebut Gemini 3.1 Pro berada di depan untuk abstract reasoning, multimodal input, dan scientific benchmarks, termasuk GPQA 94,3%.
Ini penting karena tidak semua workflow AI dimulai dari teks. Banyak pekerjaan riset, analisis dokumen, audit visual, atau pembacaan grafik bergantung pada kemampuan model memahami berbagai jenis input sekaligus. Jika Anda hanya memilih model berdasarkan benchmark coding, Anda bisa melewatkan kekuatan utama Gemini 3.1 Pro.
Grok 4: menarik untuk penalaran sulit, tetapi jangan terlalu digeneralisasi
Grok 4 layak diperhatikan pada sebagian benchmark penalaran tingkat tinggi. Panduan pihak ketiga menyebut Grok 4 memimpin pada HLE dengan angka 50,7%.
Namun skor seperti HLE tidak boleh langsung diartikan sebagai kemenangan menyeluruh untuk workflow bisnis, kualitas konten, coding agent, atau penggunaan tool. Artikel pemeringkatan model lain juga mengingatkan bahwa benchmark memang berguna, tetapi pengalaman membangun produk sehari-hari sering lebih dipengaruhi oleh reliabilitas, kemampuan UI, dan biaya.
Mengapa leaderboard saja tidak cukup?
Pertama, leaderboard sering menggabungkan benchmark dengan tanggal pembaruan yang berbeda. Perbandingan model coding dari Failing Fast, misalnya, mencantumkan sumber data dari SWE-bench Februari 2026, Aider Oktober 2025, dan Arena Code Februari 2026. Tabel seperti ini berguna sebagai peta awal, tetapi bukan bukti bahwa semua model diuji pada hari yang sama dengan kondisi yang identik.
Kedua, klaim resmi vendor dan rangkuman lintas model dari pihak ketiga adalah dua jenis bukti yang berbeda. Data Anthropic tentang Opus 4.7 paling kuat untuk menyatakan peningkatan dibanding Opus 4.6. Sementara itu, panduan pihak ketiga membantu memberi arah lintas model, tetapi bukan evaluasi resmi bersama dari OpenAI, Google, xAI, dan Anthropic.
Ketiga, performa nyata di produk Anda bisa ditentukan oleh hal-hal yang tidak selalu tampak di benchmark: stabilitas jawaban, kualitas integrasi, kontrol perusahaan, latensi, UI, dan biaya iterasi. Artikel pemeringkatan model menekankan bahwa benchmark berguna, tetapi pengalaman harian membangun sistem sering ditentukan oleh reliabilitas, kemampuan UI, dan apakah biaya memungkinkan Anda mencoba ulang tanpa terlalu banyak pertimbangan.
Checklist uji coba sebelum dipakai di tim
Untuk pembelian, standardisasi tim, atau implementasi produksi, jangan berhenti pada pertanyaan model mana yang paling kuat. Gunakan tugas nyata dan ukur dengan cara yang sama.
Pilih 5 sampai 10 tugas yang benar-benar sering dilakukan: memperbaiki bug, menambah fitur, refactor, membaca dokumen panjang, menganalisis screenshot, membuat spesifikasi, atau memanggil tool.
Berikan prompt, konteks, file, dan standar keberhasilan yang sama ke semua model.
Catat first-pass success, jumlah revisi, tool error, halusinasi, latensi, biaya, dan waktu koreksi manusia.
Jangan hanya melihat jawaban terbaik. Perhatikan juga jawaban terburuk, karena pola gagal biasanya lebih menentukan saat model sudah dipakai banyak orang.
Jika ada data sensitif, cek juga kebijakan retensi data, opsi deployment, kontrol admin, dan persyaratan compliance.
Kesimpulan
Claude Opus 4.7 adalah kandidat kuat untuk coding, agent workflow, dan penggunaan tool yang perlu stabil. Anthropic menyebutnya lebih berhasil daripada Opus 4.6 pada Factory Droids, dengan tool error lebih sedikit; Axios juga menggambarkannya sebagai upgrade flagship dengan coding dan vision yang lebih baik.
Tetapi jika pertanyaannya adalah model mana yang paling hebat untuk semua hal, bukti yang tersedia belum cukup. Kesimpulan yang lebih masuk akal mengikuti panduan pihak ketiga: tidak ada satu model yang menang mutlak di semua tugas. GPT-5.4, Gemini 3.1 Pro, Grok 4, dan sejumlah model baru masing-masing punya area kuat.
Cara paling aman: jadikan Claude Opus 4.7 kandidat utama untuk coding dan agent task, lalu uji berdampingan dengan GPT-5.4, Gemini 3.1 Pro, dan Grok 4 memakai workflow nyata Anda sendiri.
Bukti ini terutama menunjukkan peningkatan Opus 4.7 dibanding Opus 4.6, bukan kemenangan langsung atas semua model lain.
Proses ketat, structured reasoning, dan computer use
GPT-5.4
Panduan pihak ketiga menyebut GPT-5.4 kuat pada structured reasoning dan computer use, serta mencantumkan OSWorld 75%.
Tetap perlu diuji memakai alur kerja, tool, dan standar kesalahan Anda sendiri.
Input multimodal, penalaran abstrak, soal ilmiah, dan bantuan riset
Gemini 3.1 Pro
Panduan pihak ketiga menyebut Gemini 3.1 Pro unggul pada abstract reasoning, multimodal input, dan scientific benchmarks, termasuk GPQA 94,3%.
Kuat di multimodal dan benchmark ilmiah tidak otomatis berarti paling kuat untuk coding agent atau workflow panjang.
Benchmark penalaran sulit
Grok 4
Panduan pihak ketiga menyebut Grok 4 memimpin pada indikator HLE dengan angka 50,7%.
Satu skor penalaran sulit tidak bisa langsung disamaratakan sebagai kemenangan di semua pekerjaan bisnis.
Diversifikasi vendor, biaya, atau eksplorasi model alternatif
MiniMax, GLM, Kimi, dan model baru lain
Panduan yang sama menyebut MiniMax M2.5/M2.7, GLM-5/5.1, dan Kimi K2.5 mulai menyaingi model proprietary frontier pada tugas sejenis SWE-bench.
Mendekati di SWE-bench tidak berarti sama kuat pada stabilitas API, multimodal, penulisan, keamanan, atau integrasi produk.
Claude Opus 4.7: kuat untuk coding dan keandalan tool
Sinyal paling penting dari Claude Opus 4.7 adalah penekanan Anthropic pada tingkat keberhasilan tugas dan pengurangan kesalahan saat memakai tool. Di halaman resminya, Anthropic menyebut Claude Opus 4.7 mengungguli Opus 4.6 dengan kenaikan 10% hingga 15% pada task success Factory Droids, disertai lebih sedikit tool error dan performa yang lebih andal.
Ini membuat Opus 4.7 menarik untuk diuji lebih awal oleh tim software, tim data, atau siapa pun yang membangun workflow berbasis agent. Dalam pekerjaan seperti ini, kegagalan sering bukan sekadar jawaban salah. Masalahnya bisa berupa tool call yang tidak stabil, konteks yang hilang di tengah jalan, file yang salah diedit, atau model yang perlu dikoreksi manusia berkali-kali.
Axios juga melaporkan Opus 4.7 sebagai peningkatan bermakna untuk model flagship Anthropic, dengan sorotan pada coding yang lebih baik dan vision yang lebih tajam.
Namun batasnya jelas: data tersebut paling aman dibaca sebagai bukti bahwa Opus 4.7 meningkat dari Opus 4.6. Sumber yang tersedia belum cukup untuk menyimpulkan bahwa Opus 4.7 pasti mengalahkan GPT-5.4, Gemini 3.1 Pro, dan Grok 4 di semua kondisi.
GPT-5.4: perhatikan jika pekerjaan Anda sangat prosedural
Jika pekerjaan Anda banyak berisi aturan ketat, tabel keputusan, alur operasional, desktop automation, atau koordinasi beberapa tool, GPT-5.4 perlu masuk daftar uji awal. Panduan LLM pihak ketiga menyebut GPT-5.4 menonjol pada structured reasoning dan computer use, dengan OSWorld 75%.
Istilah computer use di sini merujuk pada kemampuan model menjalankan atau mengarahkan tindakan di lingkungan komputer, bukan hanya menjawab pertanyaan teks. Untuk tim yang membangun otomasi internal, ini bisa lebih penting daripada skor menulis esai atau benchmark coding murni.
Tetapi ini tidak berarti GPT-5.4 otomatis lebih baik daripada Opus 4.7 untuk semua hal. Kesimpulan praktisnya: bila biaya kegagalan terbesar Anda berasal dari salah langkah, salah urutan proses, atau salah memakai tool, uji GPT-5.4 berdampingan dengan Claude Opus 4.7.
Gemini 3.1 Pro: prioritaskan untuk multimodal dan pekerjaan ilmiah
Jika data Anda sering berupa gambar, grafik, tangkapan layar dokumen, diagram, atau pertanyaan ilmiah, Gemini 3.1 Pro layak diprioritaskan. Panduan pihak ketiga menyebut Gemini 3.1 Pro berada di depan untuk abstract reasoning, multimodal input, dan scientific benchmarks, termasuk GPQA 94,3%.
Ini penting karena tidak semua workflow AI dimulai dari teks. Banyak pekerjaan riset, analisis dokumen, audit visual, atau pembacaan grafik bergantung pada kemampuan model memahami berbagai jenis input sekaligus. Jika Anda hanya memilih model berdasarkan benchmark coding, Anda bisa melewatkan kekuatan utama Gemini 3.1 Pro.
Grok 4: menarik untuk penalaran sulit, tetapi jangan terlalu digeneralisasi
Grok 4 layak diperhatikan pada sebagian benchmark penalaran tingkat tinggi. Panduan pihak ketiga menyebut Grok 4 memimpin pada HLE dengan angka 50,7%.
Namun skor seperti HLE tidak boleh langsung diartikan sebagai kemenangan menyeluruh untuk workflow bisnis, kualitas konten, coding agent, atau penggunaan tool. Artikel pemeringkatan model lain juga mengingatkan bahwa benchmark memang berguna, tetapi pengalaman membangun produk sehari-hari sering lebih dipengaruhi oleh reliabilitas, kemampuan UI, dan biaya.
Mengapa leaderboard saja tidak cukup?
Pertama, leaderboard sering menggabungkan benchmark dengan tanggal pembaruan yang berbeda. Perbandingan model coding dari Failing Fast, misalnya, mencantumkan sumber data dari SWE-bench Februari 2026, Aider Oktober 2025, dan Arena Code Februari 2026. Tabel seperti ini berguna sebagai peta awal, tetapi bukan bukti bahwa semua model diuji pada hari yang sama dengan kondisi yang identik.
Kedua, klaim resmi vendor dan rangkuman lintas model dari pihak ketiga adalah dua jenis bukti yang berbeda. Data Anthropic tentang Opus 4.7 paling kuat untuk menyatakan peningkatan dibanding Opus 4.6. Sementara itu, panduan pihak ketiga membantu memberi arah lintas model, tetapi bukan evaluasi resmi bersama dari OpenAI, Google, xAI, dan Anthropic.
Ketiga, performa nyata di produk Anda bisa ditentukan oleh hal-hal yang tidak selalu tampak di benchmark: stabilitas jawaban, kualitas integrasi, kontrol perusahaan, latensi, UI, dan biaya iterasi. Artikel pemeringkatan model menekankan bahwa benchmark berguna, tetapi pengalaman harian membangun sistem sering ditentukan oleh reliabilitas, kemampuan UI, dan apakah biaya memungkinkan Anda mencoba ulang tanpa terlalu banyak pertimbangan.
Checklist uji coba sebelum dipakai di tim
Untuk pembelian, standardisasi tim, atau implementasi produksi, jangan berhenti pada pertanyaan model mana yang paling kuat. Gunakan tugas nyata dan ukur dengan cara yang sama.
Pilih 5 sampai 10 tugas yang benar-benar sering dilakukan: memperbaiki bug, menambah fitur, refactor, membaca dokumen panjang, menganalisis screenshot, membuat spesifikasi, atau memanggil tool.
Berikan prompt, konteks, file, dan standar keberhasilan yang sama ke semua model.
Catat first-pass success, jumlah revisi, tool error, halusinasi, latensi, biaya, dan waktu koreksi manusia.
Jangan hanya melihat jawaban terbaik. Perhatikan juga jawaban terburuk, karena pola gagal biasanya lebih menentukan saat model sudah dipakai banyak orang.
Jika ada data sensitif, cek juga kebijakan retensi data, opsi deployment, kontrol admin, dan persyaratan compliance.
Kesimpulan
Claude Opus 4.7 adalah kandidat kuat untuk coding, agent workflow, dan penggunaan tool yang perlu stabil. Anthropic menyebutnya lebih berhasil daripada Opus 4.6 pada Factory Droids, dengan tool error lebih sedikit; Axios juga menggambarkannya sebagai upgrade flagship dengan coding dan vision yang lebih baik.
Tetapi jika pertanyaannya adalah model mana yang paling hebat untuk semua hal, bukti yang tersedia belum cukup. Kesimpulan yang lebih masuk akal mengikuti panduan pihak ketiga: tidak ada satu model yang menang mutlak di semua tugas. GPT-5.4, Gemini 3.1 Pro, Grok 4, dan sejumlah model baru masing-masing punya area kuat.
Cara paling aman: jadikan Claude Opus 4.7 kandidat utama untuk coding dan agent task, lalu uji berdampingan dengan GPT-5.4, Gemini 3.1 Pro, dan Grok 4 memakai workflow nyata Anda sendiri.
iternal.aiThe Definitive LLM Selection & Benchmarks Guide
anthropic.comClaude Opus 4.7 - Anthropic
axios.comAnthropic releases Claude Opus 4.7, concedes it trails ... - Axios
adam.holter.comAI Labs LLM Rankings 2026: Claude vs GPT-5 vs Gemini 3 vs Grok
failingfast.ioAI coding model comparison - Failing Fast