Posts IA tendance & veille recherche rapide - Page 90
DeepSeek veut entraîner ses prochains modèles sur des puces Huawei : ce que l’on sait
17 sources0Liang Wenfeng aurait dit aux investisseurs que l’entraînement sur des puces Huawei et d’autres puces chinoises est l’un des plus grands paris de DeepSeek et qu’il « doit réussir ».
Peerium de Huawei : comment UnifiedBus veut relier jusqu’à un million de processeurs
20 sources0Peerium est une architecture de système, pas une nouvelle puce Ascend. Le million de processeurs est un objectif annoncé par Huawei, non un déploiement démontré.
Zhenwu V900 : ce qu’Alibaba annonce, et ce qu’il reste à vérifier
17 sources0T Head destine le Zhenwu V900 à l’entraînement des modèles d’IA et à l’inférence ; Alibaba revendique des performances trois fois supérieures à celles du M890, sans test indépendant publié.
Xing4.0-29B-A4B : ce que promet le modèle d’IA de China Telecom
19 sources0Xing4.0 29B A4B compte environ 29 milliards de paramètres au total, dont quelque 4 milliards activés par token ; sa fenêtre de contexte native est de 256 000 tokens.
Li Auto et ses trois briques d’IA robotique : ce que prouvent vraiment les chiffres
14 sources0Le 22 septembre 2026, Li Auto a présenté ME Brain 1.0, ME VLM et ME U0 comme trois éléments complémentaires de son approche de l’IA robotique.
Inspur MetaBrain SD200 Ultra : 128 puces, une promesse de rapidité et des chiffres à vérifier
17 sources0Inspur annonce un supernœud de 128 accélérateurs capable, selon l’entreprise, d’exécuter Kimi K3, un modèle de 2 800 milliards de paramètres, à moins de 5,85 ms par jeton généré.
La Chine assemble les pièces d’un centre de données en orbite
25 sources0En septembre 2026, la Chine avait placé en orbite un premier groupe de 12 satellites de calcul, lancé des services expérimentaux de calcul orbital et annoncé une liaison laser vers le sol atteignant 120 Gbit...
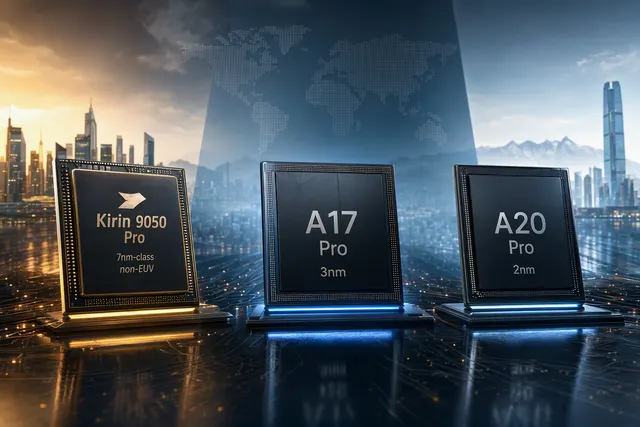
Kirin 9050 Pro face à Apple : ce que montrent vraiment les tests cités par Bernstein
21 sources0Selon Bernstein, le Kirin 9050 Pro dépasse l’A17 Pro sur Geekbench 6 multicœur, mais reste environ 30 % derrière l’A20 Pro en performance globale.
Qwen 4 est à l’entraînement : ce qu’Alibaba a annoncé à Apsara 2026
23 sources0Le 22 septembre 2026, Alibaba a confirmé que Qwen 4 était en cours d’entraînement, sans annoncer sa sortie.
Agentic Cloud d’Alibaba : à quoi servent AgentCore, CPFS et HPN 8.0 Pro ?
17 sources0Alibaba Cloud distingue trois besoins — modèle, cadre d’exécution et contexte — auxquels répondent AI Native Cloud, Agent Native Cloud et Context Engine.[3][4]
Alibaba à Apsara 2026 : comprendre LiveTranslate et les cinq modèles Qwen-Audio 3.1
16 sources0Qwen3.8 LiveTranslate vise l’interprétation simultanée. Alibaba annonce un décalage moyen ramené d’environ 2,8 à 2,3 secondes, sans validation indépendante citée.
ZCode et les dépôts Git envoyés dans le cloud : ce qui a été corrigé, ce que les audits établissent
22 sources0Une enquête publiée en septembre 2026 a révélé que ZCode pouvait chiffrer et envoyer vers Alibaba Cloud une copie de l’espace de travail local, y compris son historique Git.