Publicaciones de AI en tendencia e investigación al día - Página 1731
Cómo probar GPT-5.5 hoy: ChatGPT, Codex y API
15 fuentes0La vía más directa para probar GPT 5.5 ahora es ChatGPT o Codex: en ChatGPT se está desplegando para Plus, Pro, Business y Enterprise; la API aún aparece como “coming soon”.[20][1]
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: ganadores por benchmark
24 fuentes0No conviene declarar un ganador global: GPT 5.5 y Claude Opus 4.7 tienen más resultados comparables entre sí, mientras que Kimi K2.6 mezcla cifras de ficha de modelo y entornos de evaluación distintos, y Dee...
Benchmarks de Claude Opus 4.7: 87.6% en SWE-bench Verified y cómo interpretarlo
12 fuentes0Claude Opus 4.7 tiene como cifra titular 87.6% en SWE bench Verified, reportada por AWS a partir de datos de Anthropic; es una señal fuerte para coding agéntico, no una garantía de rendimiento universal.
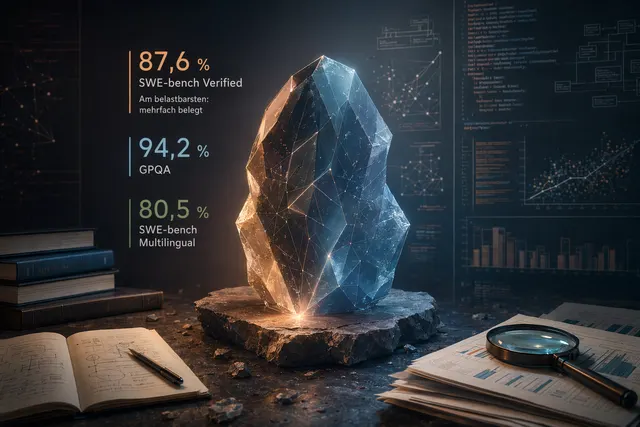
Benchmarks de Claude Opus 4.7: cifras clave y fiabilidad
16 fuentes0Las cifras públicas clave son 87,6 % en SWE bench Verified, 94,2 % en GPQA y 80,5 % en SWE bench Multilingual; la primera es la más respaldada por las fuentes disponibles.
Claude Mythos Preview: qué significa el 93,9% en SWE-bench
17 fuentes0La cifra más citada para Claude Mythos Preview es 93,9% en SWE bench, una evaluación de tareas de software; es relevante para código y agentes, pero no funciona como nota general del modelo [1][2].
Claude Mythos: 93,9 % en SWE-bench y por qué sus benchmarks requieren contexto
17 fuentes0Claude Mythos Preview destaca por el 93,9 % reportado en SWE bench Verified, aunque Anthropic lo presenta como un modelo de investigación con acceso por invitación.
Kimi K2.6 vs DeepSeek V4 vs GPT-5.5 vs Claude Opus 4.7: benchmarks y precio
20 fuentes0No hay ganador universal: Claude Opus 4.7 es la primera opción si prima la calidad —46,9%/54,7% en HLE y 64,3% en SWE Bench Pro—, pero GPT 5.5 domina Terminal Bench 2.0 y Kimi/DeepSeek cambian la decisión cu...
GPT-5.5 vs Claude Opus 4.7: benchmarks, precio y guía de elección
17 fuentes0No hay un vencedor absoluto: LLM Stats ve a Claude Opus 4.7 por delante en 6 de 10 benchmarks compartidos y a GPT 5.5 en 4, pero los datos no son un test neutral único.
GPT-5.5 vs DeepSeek V4: benchmarks, código, agentes y precio
19 fuentes0No hay evidencia suficiente para declarar un ganador total: BenchLM da ventaja a DeepSeek V4 Flash High en coding, 72,2 frente a 58,6, pero favorece a GPT 5.5 en agentic tasks, 81,8 frente a 55,4 [13].
GPT-5.5 vs Claude Opus 4.7: código para Claude, terminal para GPT
17 fuentes0No hay ganador absoluto: Claude Opus 4.7 lidera SWE Bench Pro con 64,3 % frente a 58,6 %, mientras GPT 5.5 domina Terminal Bench 2.0 con 82,7 % frente a 69,4 %.[14]
DeepSeek V4 vs Kimi K2.6: DeepSeek toma ventaja en código, pero contenido y traducción siguen abiertos
18 fuentes0En programación, la comparación pública más directa favorece a DS V4 Pro Max: 93,5 en LiveCodeBench frente a 89,6 de K2.6 Thinking, según una tabla publicada por DeepSeek [18][35].
DeepSeek V4, Kimi K2.6, Claude Opus 4.7 y GPT-5.5: qué modelo gana cada benchmark
16 fuentes0No hay un ganador global bien documentado: GPT 5.5 tiene cifras oficiales de 82,7 % en Terminal Bench 2.0 y 58,6 % en SWE Bench Pro, mientras que DeepSeek V4 cuenta sobre todo con confirmación oficial de dis...