Publicaciones de AI en tendencia e investigación al día - Página 1729
Legitimidad policial en Hong Kong: confianza, protesta y rendición de cuentas
7 fuentes0En Hong Kong, la legitimidad policial se entiende mejor como una relación social y condicional, no como un atributo fijo de la institución [3][4].
GPT-5.5 vs Claude Opus 4.7: código, UI, precio y cuál probar primero
20 fuentes0No conviene elegir un campeón único: GPT 5.5 aparece por delante en Terminal Bench 2.0 con 82,7 % frente al 69,4 % de Claude Opus 4.7, pero Claude lidera en SWE Bench Pro con 64,3 % frente al 58,6 % de GPT 5...
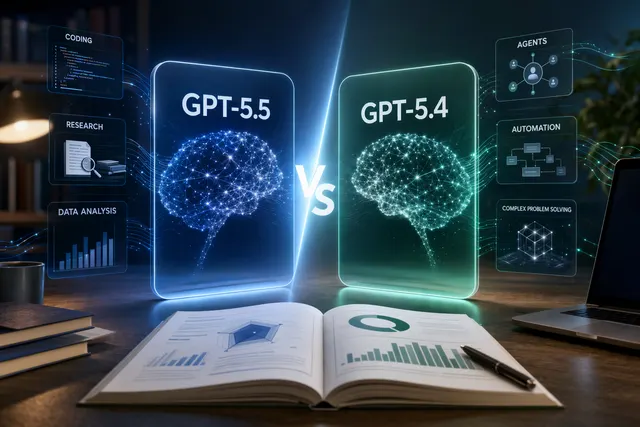
GPT-5.5 frente a GPT-5.4: qué modelo conviene para trabajo real
19 fuentes0GPT 5.5 es la opción más potente para cargas exigentes: OpenAI informa 84,9 % en GDPval, 78,7 % en OSWorld Verified y 98,0 % en Tau2 bench Telecom [22].
GPT-5.5 explicado: capacidades, disponibilidad y límites reales
12 fuentes0OpenAI presentó GPT 5.5 el 23 de abril de 2026 como su nuevo modelo insignia para trabajo práctico: código, datos, investigación y documentos.
GPT-5.5, Claude Opus 4.7, DeepSeek V4 o Kimi K2.6: qué modelo de IA usar en 2026
29 fuentes0No hay un ganador universal con la evidencia pública disponible: conviene elegir por carga de trabajo, presupuesto, contexto y tolerancia al riesgo.
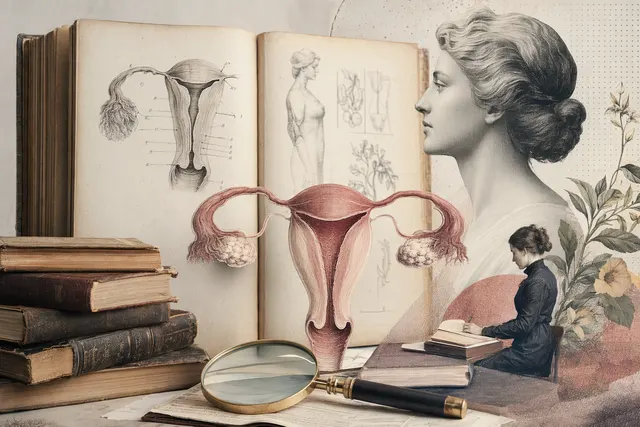
¿Estudiar hacía encoger el útero? Lo que realmente prueban las fuentes
4 fuentes0Con las fuentes disponibles, no se demuestra que un libro de texto médico enseñara que leer o estudiar hacía encoger el útero.
GPT-5.5 vs. Claude Opus 4.7: cuál conviene más para programar
18 fuentes0Prueba GPT 5.5 primero si tu flujo depende de la terminal: aparece con 82,7 % en Terminal Bench 2.0 frente al 69,4 % de Claude Opus 4.7.[6][31]
GPT-5.5 vs Claude Opus 4.7 para programar: Claude para parches, GPT para terminal
19 fuentes0Para corregir bugs, preparar parches y hacer pasar tests en un repositorio existente, Claude Opus 4.7 es el primer candidato razonable: se cita con 64,3 % en SWE bench Pro frente al 58,6 % de GPT 5.5.[16][29]
Cómo usar DeepSeek: web, app y API paso a paso
23 fuentes0DeepSeek puede probarse desde la web oficial con Start Now, desde la app móvil oficial o mediante la API si quieres integrarlo en un producto o flujo de trabajo.[24][23][1]
GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: benchmarks por caso de uso
24 fuentes0No conviene leer estos resultados como un ranking definitivo: los benchmarks públicos cambian según esfuerzo de razonamiento, fecha de evaluación y metodología, así que la elección debe hacerse por caso de u...
GPT-5.5 en benchmarks: muy fuerte, pero no invencible
16 fuentes0GPT 5.5 aparece como uno de los modelos de frontera más sólidos: logra 82,7 en Terminal Bench 2.0, 51,7 en FrontierMath Tier 1–3 y 84,9 en GDPval, según comparativas públicas.[6][10]
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4: qué benchmarks sí se pueden comparar
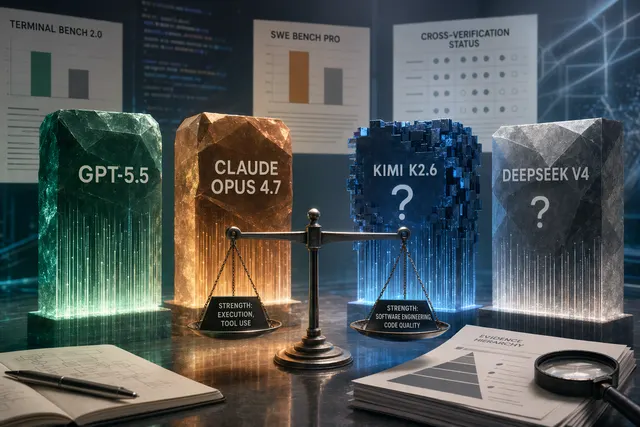
16 fuentes0No hay base suficiente para proclamar un “campeón” entre los cuatro modelos: en la tabla de OpenAI, Claude Opus 4.7 supera a GPT 5.5 en SWE Bench Pro, 64,3% frente a 58,6%, pero GPT 5.5 lidera Terminal Bench...