Publicaciones de AI en tendencia e investigación al día - Página 1730
Kimi K2.6: muy fuerte para programar, aún no demostrado como IA para todo
12 fuentes0Kimi K2.6 parece especialmente sólido en programación: MLQ.ai informa 58,6 en SWE Bench Pro y 65,8 % pass@1 en SWE bench Verified, aunque una revisión advierte que las evaluaciones independientes aún son pre...
Kimi K2.6 frente a GPT-5.5, Gemini y Claude: veredicto para desarrolladores
23 fuentes0Kimi K2.6 es el candidato de bajo coste más claro para agentes de programación: OpenRouter lista 262.144 tokens de contexto y $0.75/$3.50 por 1M tokens de entrada/salida [26].
GPT-5.5 vs Claude Opus 4.7: guía para elegir
21 fuentes0Si quieres pasar de una instrucción breve a investigación, código, análisis y documentos, GPT 5.5 es el candidato natural; si necesitas cargar mucho contexto y sostener flujos de agente, Claude Opus 4.7 gana...
DeepSeek V4 tras su preview: cerca de la élite, pero aún sin corona
18 fuentes0DeepSeek V4 figura en la documentación oficial de la API como «DeepSeek V4 Preview Release» con fecha del 24 de abril de 2026; eso confirma la vista previa, no necesariamente un despliegue estable y generali...
Cómo saber si tienes acceso a GPT-5.5 en España
18 fuentes0No hay indicios claros, en las fuentes disponibles, de un bloqueo específico de GPT 5.5 en España; si no aparece, lo más probable es que dependa del despliegue por cuenta, plan, organización o canal.
Cómo probar GPT-5.5 gratis en ChatGPT: comprueba tu acceso sin atajos dudosos
12 fuentes0La ruta oficial empieza en ChatGPT: inicia sesión o crea una cuenta gratuita y busca GPT 5.5 en el selector de modelos si está disponible [9][3].
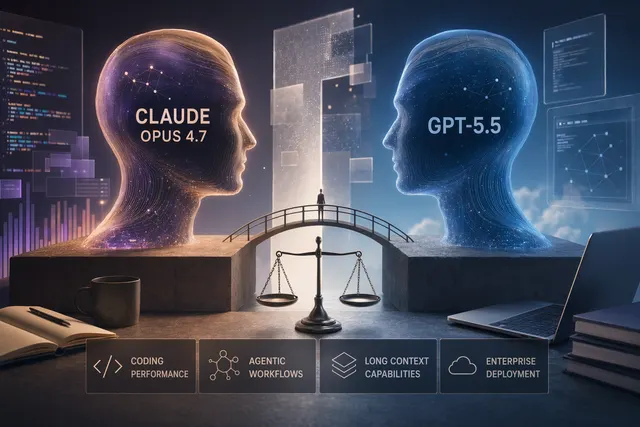
Claude Opus 4.7 vs GPT-5.5: cómo elegir para agentes, contexto largo y despliegue API
21 fuentes0Para compras de API, agentes con contexto largo o despliegues empresariales, Claude Opus 4.7 es hoy más fácil de evaluar: Anthropic publica ventana de contexto de 1 millón, sin recargo por contexto largo en...
Claude Opus 4.7 vs. GPT-5.5: benchmarks, límites y cuál conviene probar primero
11 fuentes0No hay una comparativa pública completa en igualdad de condiciones: Claude Opus 4.7 lidera GDPval AA con 1.753 Elo, mientras GPT 5.5 high, low y non reasoning puntúan 59, 51 y 41 en el Intelligence Index.[5]...
Claude Opus 4.7 vs GPT-5.5: qué modelo usar para código, agentes, investigación y diseño
17 fuentes0Claude Opus 4.7 es la primera opción mejor respaldada para programación y agentes con herramientas: Vellum reporta 87,6 % en SWE bench Verified y 77,3 % en MCP Atlas [3].
Claude Opus 4.7 vs GPT-5.5: qué revisar antes de desplegarlos en una empresa
26 fuentes0Para una PoC empresarial con API hoy, Claude Opus 4.7 tiene la posición más clara: Anthropic publica API, canales multicloud, ventana de contexto de 1 millón y precio de US$5/US$25 por millón de tokens de en...
Claude Opus 4.7 vs GPT-5.5 Spud: aún no hay ganador en benchmarks
24 fuentes0No se puede declarar un ganador fiable: Claude Opus 4.7 está verificado en documentación de Anthropic, mientras que GPT 5.5 Spud no queda confirmado aquí por una fuente primaria de OpenAI.
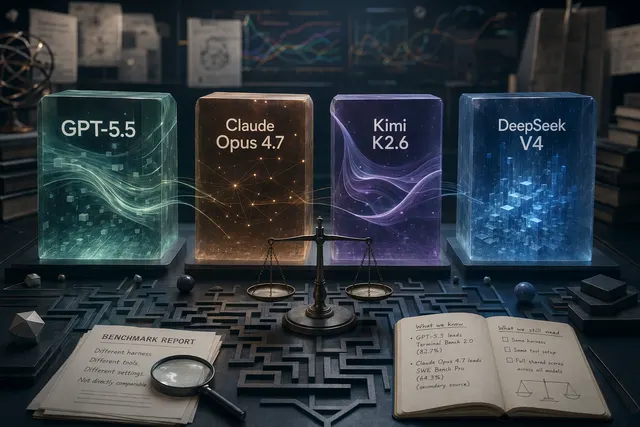
GPT-5.5, Claude Opus 4.7, Kimi K2.6 y DeepSeek V4-Pro: benchmarks y guía de elección
23 fuentes0No hay suficiente base pública para hacer un ranking absoluto: GPT 5.5 marca 82,7 % en Terminal Bench 2.0 y Claude Opus 4.7 aparece con 64,3 % en SWE Bench Pro, pero las cifras vienen de fuentes y configurac...