Qué modelo de IA conviene para contenido y marketing: OpenAI, Claude, DeepSeek, Gemini o Grok
Con los datos públicos disponibles, no hay base suficiente para declarar un ganador absoluto entre OpenAI, Claude, DeepSeek, Gemini y Grok en contenido y marketing. La selección debe separar tareas intensivas en entrada —briefs largos, transcripciones, competencia— de tareas intensivas en salida, como anuncios, fich...
Publicado porEditado con GPT-5.5Imágenes generadas con GPT Image 2
Con los datos públicos disponibles, no hay base suficiente para declarar un ganador absoluto entre OpenAI, Claude, DeepSeek, Gemini y Grok en contenido y marketing.
La selección debe separar tareas intensivas en entrada —briefs largos, transcripciones, competencia— de tareas intensivas en salida, como anuncios, fichas de producto y variantes para redes.
Más que la primera impresión del texto, conviene medir porcentaje publicable, tiempo de edición humana, consistencia de marca, errores factuales, estabilidad de formato y coste por tarea.
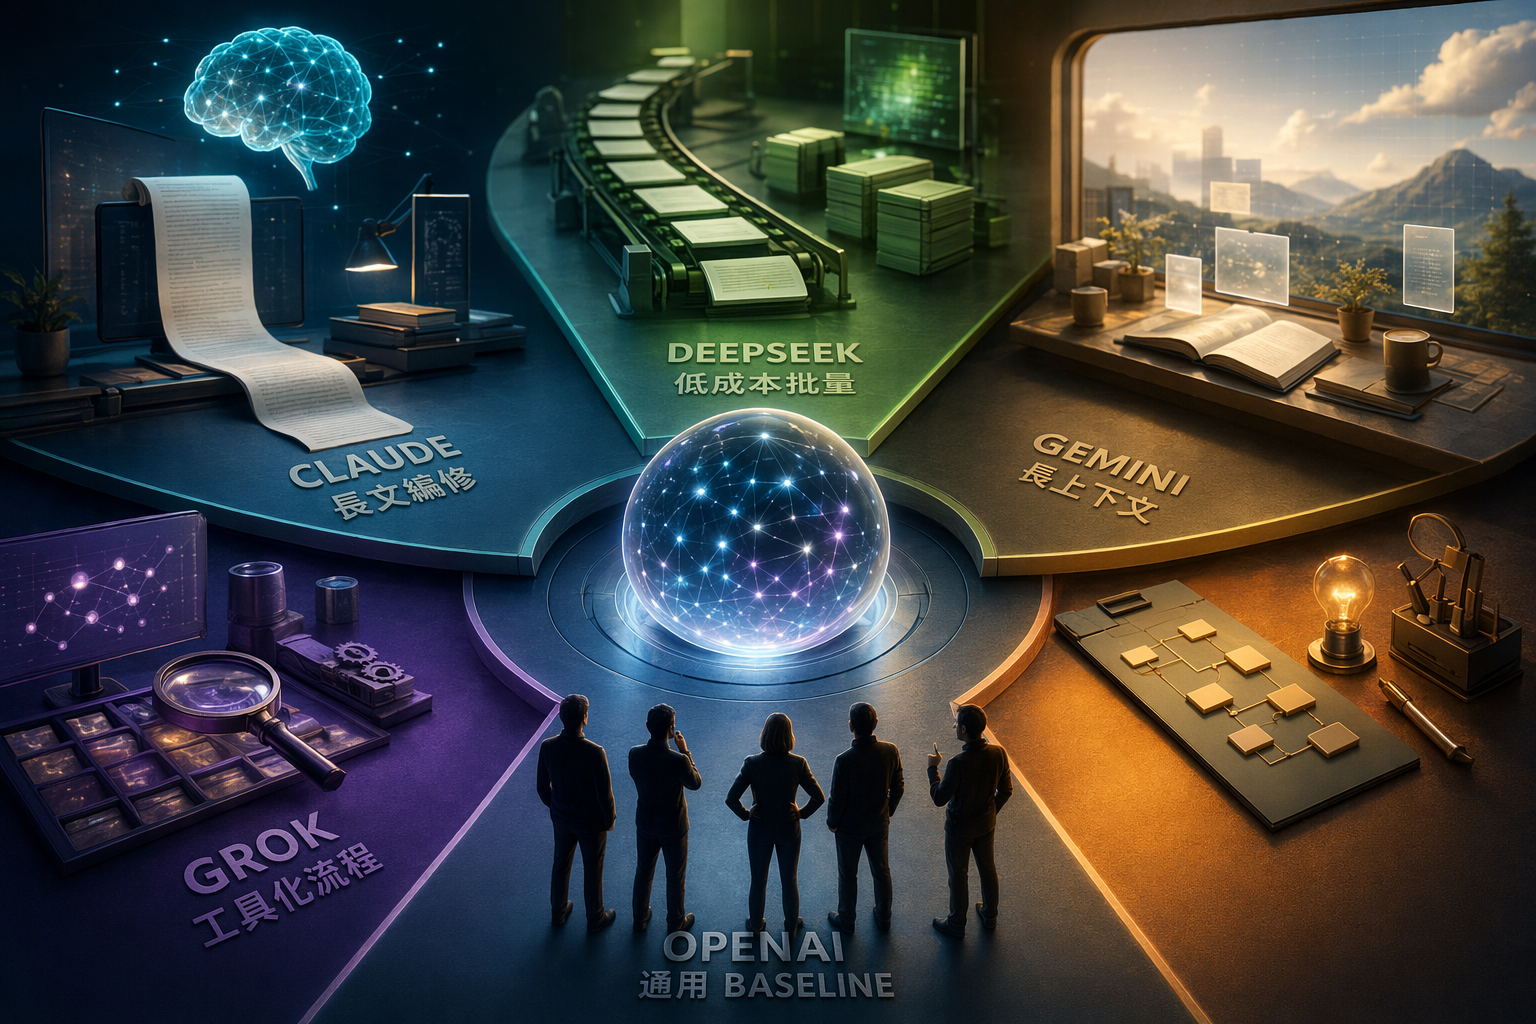
OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南AI 生成示意圖:內容團隊在研究、SEO、長文編修與自動化流程中比較不同 AI 模型。
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南. Article summary: 截至 2026 年可引用的公開資料,沒有證據支持五者中有單一內容行銷冠軍;更務實的分工是 OpenAI 當通用 baseline、Claude 測長文編修、DeepSeek 跑低成本批量、Gemini 處理長上下文、Grok 評估工具化流程。最後仍要用自家 KPI 實測。. Topic tags: ai, content marketing, seo, openai, claude. Reference image context from search candidates: Reference image 1: visual subject "# 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂. 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 全解析,付費、應用與安全性一次看懂"). 近幾年有多款大型語言模型 (LLM) 接連問世,對一般用戶來說,到底哪一款最適合日常需求。本次整理 5 款主流 LLM,分別為 GPT‑" source context "2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 | 鏈新聞 ABMedia" Reference image 2: visual subject "## Loading. ## Loading. # 生命不息,折腾不止. ## 要有最朴素的生活,与最遥远的梦想。即使明日天寒地冻、路远马亡。. # 【译】Grok 3 vs ChatGPT vs DeepSeek vs Claude vs Gemini:2025年2月哪款AI最好?. 人工智能(AI)的进步速度前所未有,几乎每周都有新的模型和技术问世。20" source c
openai.com
Para un equipo de contenidos, la trampa es elegir modelo por ranking. Los datos públicos permiten comparar precios de API, ventanas de contexto, prompt caching y herramientas ejecutadas del lado del servidor, pero no demuestran por sí solos qué modelo dará mejor posicionamiento SEO, más conversión publicitaria o una voz de marca más consistente. La pregunta útil no es cuál es el mejor modelo, sino qué parte del flujo debe resolver cada uno.
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
¿Cuál es la respuesta corta a "Qué modelo de IA conviene para contenido y marketing: OpenAI, Claude, DeepSeek, Gemini o Grok"?
Con los datos públicos disponibles, no hay base suficiente para declarar un ganador absoluto entre OpenAI, Claude, DeepSeek, Gemini y Grok en contenido y marketing.
¿Cuáles son los puntos clave a validar primero?
Con los datos públicos disponibles, no hay base suficiente para declarar un ganador absoluto entre OpenAI, Claude, DeepSeek, Gemini y Grok en contenido y marketing. La selección debe separar tareas intensivas en entrada —briefs largos, transcripciones, competencia— de tareas intensivas en salida, como anuncios, fichas de producto y variantes para redes.
¿Qué debo hacer a continuación en la práctica?
Más que la primera impresión del texto, conviene medir porcentaje publicable, tiempo de edición humana, consistencia de marca, errores factuales, estabilidad de formato y coste por tarea.
La recomendación rápida: monta un reparto, no una final
Necesidad del equipo
Probar primero
Por qué encaja
Qué vigilar
Investigación general, briefs, planificación, integración de ideas, primeros borradores y versión final
OpenAI
Comparadores de terceros listan varios niveles de modelos OpenAI con distintos precios de entrada/salida y opciones de contexto; TLDL describe la familia GPT-4.1 con ventana de contexto de 1 millón de tokens y precios de rango medio.
Úsalo como línea base de comparación, no como ganador automático para todos los casos.
Edición de textos largos, voz de marca y normas editoriales fijas
Claude
La documentación oficial de Anthropic separa Base Input Tokens, Cache Writes, Cache Hits y Output Tokens, útil cuando se reutilizan guías de marca, plantillas o criterios de revisión.
Mide porcentaje publicable, tiempo de edición humana y consistencia de marca, no solo si la primera versión suena bien.
Borradores SEO en volumen, descripciones de producto y variantes de anuncios
DeepSeek
DeepSeek tiene documentación oficial de Models & Pricing; una guía de DecodesFuture describe su precio unificado para chat y razonamiento en torno a US$0,28 por millón de tokens de entrada y US$0,42 por millón de tokens de salida, con una reducción de coste del 94–96 % frente a OpenAI o3 o GPT-4.1.
El bajo coste ayuda a producir mucho, pero no sustituye la verificación de datos ni la revisión de marca.
Briefs muy largos, análisis de competencia, transcripciones y paquetes de palabras clave
Gemini
MorphLLM lista Gemini 2.5 Flash con contexto de 1 millón de tokens, US$2,50 por millón de tokens de salida y capa gratuita; TLDL sitúa Gemini 2.5 Pro entre los modelos de 2 millones de tokens de contexto.
Estas cifras citadas proceden sobre todo de comparadores de terceros; antes de contratar, confirma límites y precios con tu proveedor.
Llamadas a herramientas, automatización y pipelines de contenido
Grok
La documentación oficial de xAI incluye Models and Pricing y separa el precio de server-side tools; TLDL también indica que xAI ofrece dos modelos con contexto de 2 millones de tokens.
Tiene sentido probarlo en flujos con herramientas, pero estos datos no prueban que gane de forma estable en copywriting general.
Antes de comparar calidad, separa coste de entrada y coste de salida
Las API de generación de texto suelen cobrar por uso de tokens. Cada proveedor define precios por millón de tokens; los input tokens son el prompt o el contexto que envías al modelo, y los output tokens son el texto que el modelo genera.
Eso divide las tareas de marketing en dos grupos muy distintos:
Trabajos intensivos en entrada: análisis de páginas de la competencia, resumen de entrevistas, transcripciones de llamadas de ventas, paquetes de palabras clave SEO, documentación de producto y briefs extensos. Aquí el coste se concentra en la cantidad de información que metes en el modelo.
Trabajos intensivos en salida: titulares de anuncios, fichas de producto, FAQ, publicaciones sociales, newsletters, localizaciones multilingües y variantes A/B. Aquí importa más el precio de los tokens de salida y el coste total de generar muchas versiones.
Si tu equipo incluye siempre una guía de voz de marca, restricciones legales, plantillas SEO o instrucciones de formato, también conviene mirar el prompt caching. En Claude, la documentación oficial separa cache writes y cache hits, lo que permite tratar el contexto repetido como una decisión de arquitectura y de coste, no solo como una cuestión de redacción del prompt.
OpenAI: una buena línea base para empezar
OpenAI es un buen punto de partida para comparar. No porque las fuentes públicas demuestren que sea el mejor en todas las tareas de marketing, sino porque los comparadores de precios muestran varios niveles de modelos OpenAI. Eso facilita usar modelos más capaces para estrategia, síntesis de investigación y cierre editorial, y modelos más económicos para resúmenes, reescrituras o variantes en volumen.
TLDL describe la familia GPT-4.1 como una opción con ventana de contexto de 1 millón de tokens y precios de rango medio, por lo que encaja bien en pruebas iniciales con briefs largos, resúmenes de investigación y planificación de campañas. La cautela importante es que, en este artículo, los datos de precios y contexto de OpenAI proceden principalmente de recopilaciones de terceros, no de una cita directa de documentación oficial.
Tareas razonables para probar primero: esquemas de páginas pilar SEO, mensajes de campaña, síntesis de research, borradores de artículos largos, variantes de titulares, bloques para email marketing y reutilización de contenido para redes. Registra calidad y coste por separado, porque dentro de un mismo proveedor pueden cambiar mucho la ventana de contexto y el precio por millón de tokens.
Claude: edición larga, tono de marca y procesos con reglas fijas
El valor más claro de Claude para equipos editoriales está en la edición de textos largos y en los procesos que repiten normas. La documentación oficial de Anthropic muestra precios diferenciados para Base Input Tokens, Cache Writes, Cache Hits y Output Tokens; eso es relevante cuando se reutilizan guías de estilo, criterios legales, estructuras de artículo o plantillas de revisión.
La prueba correcta no es preguntar si Claude escribe bonito. Es comprobar si reduce el trabajo de edición en tareas como reescritura de artículos largos, resumen de white papers, unificación de voz de marca, revisión contra una guía editorial o corrección de estructura. Al final, lo que cuenta es cuántas piezas quedan listas para publicar, cuánto tarda el editor humano y cuántos errores sobreviven.
DeepSeek: volumen barato para borradores y variantes
El atractivo principal de DeepSeek es el coste. DeepSeek ofrece documentación oficial de Models & Pricing; además, la guía de DecodesFuture para 2026 describe un precio unificado para chat y razonamiento de unos US$0,28 por millón de tokens de entrada y US$0,42 por millón de tokens de salida, y lo presenta como una reducción del 94–96 % frente a OpenAI o3 o GPT-4.1.
Por eso tiene sentido ubicarlo al inicio de la producción: primeros borradores de SEO long tail, descripciones de producto, FAQ, variantes de anuncios, primeras versiones de localización multilingüe y publicaciones sociales. Pero el ahorro no convierte automáticamente un borrador en una pieza publicable. Cuanto más volumen generes, más necesitas controles claros de factualidad, tono de marca, formato y cumplimiento.
Gemini: candidato fuerte cuando el problema es el contexto largo
Gemini destaca en esta comparación por la ventana de contexto. MorphLLM lista Gemini 2.5 Flash con contexto de 1 millón de tokens, US$2,50 por millón de tokens de salida y capa gratuita; TLDL coloca Gemini 2.5 Pro entre los modelos de contexto de 2 millones de tokens.
Para marketing, esto importa cuando el modelo debe leer mucho antes de escribir: varias páginas de la competencia, transcripciones de llamadas, paquetes de keywords, documentación técnica, entrevistas con clientes y contenido histórico de la marca. Muchas piezas fallan no porque el modelo no sepa redactar, sino porque no recibió suficiente contexto. Aun así, estas especificaciones de Gemini proceden principalmente de comparadores de terceros; el presupuesto final y los límites reales deben confirmarse con la documentación del proveedor que vayas a usar.
Grok: mejor evaluarlo en flujos con herramientas
Grok no debería juzgarse solo con una prueba aislada de copy. La documentación oficial de xAI incluye Models and Pricing y separa el coste de las herramientas ejecutadas del lado del servidor, algo relevante para equipos que quieren conectar el modelo con fuentes de datos, herramientas internas o pipelines automatizados de contenido.
TLDL también señala que xAI cuenta con dos modelos de contexto de 2 millones de tokens y diferencia el posicionamiento de Grok 4 y Grok 4.1 Fast. Con las fuentes citadas, sin embargo, no basta para afirmar que Grok supere de forma estable a OpenAI o Claude en copywriting general. Su lugar más prudente en la matriz es este: si tu flujo depende de llamadas a herramientas, conexión de datos o automatización, inclúyelo en la prueba.
Cómo hacer una prueba justa entre modelos
Las tablas de precios y especificaciones sirven para acotar candidatos, no para tomar la decisión final. Una prueba pequeña, con los mismos materiales de marca y las mismas restricciones para todos los modelos, suele decir más que cualquier ranking general.
Puedes montar cinco ejercicios:
Brief SEO: entrega palabra clave, intención de búsqueda, resumen de competencia y datos del producto. Pide estructura, puntos por sección y afirmaciones que requieren verificación.
Edición de artículo largo: da un borrador y una guía de voz de marca. Pide reescritura sin cambiar hechos y una lista de cambios principales.
Variantes publicitarias: genera varias opciones de headline, texto principal y CTA. Revisa si cumplen tono, promesa, restricciones de plataforma y límites de formato.
Reutilización de contenido: convierte un artículo largo en piezas para LinkedIn, X, Threads, newsletter y guion corto de vídeo.
Control de incertidumbre: pide al modelo que marque frases que deben verificarse, en lugar de completarlas con seguridad aparente.
No puntúes solo qué texto suena mejor. Registra porcentaje publicable, tiempo de edición humana, coherencia con la marca, tasa de errores factuales, estabilidad del formato, coste por tarea y coste total si el proceso se ejecuta a gran escala. Como los costes de API dependen por separado de tokens de entrada y salida, las tareas con mucho contexto y las tareas de generación masiva deben presupuestarse por separado.
La forma más práctica de empezar
Si necesitas una matriz inicial, usa OpenAI como baseline general, Claude para edición larga y voz de marca, DeepSeek para volumen de bajo coste, Gemini para contexto muy extenso y Grok para flujos con herramientas o automatización.
No es un ranking absoluto. El mejor modelo para tu equipo dependerá del idioma, el mercado, las reglas de marca, el proceso de revisión y los KPI de contenido que realmente midas.
platform.claude.comPricing - Claude API Docs
pecollective.comCross-Provider LLM API Pricing Comparison (April 2026)
tldl.ioLLM API Pricing 2026 — Compare GPT-5, Claude 4, Gemini 2.5 ...
docs.x.aiModels and Pricing - xAI Docs
aipricingcomparison.comCompare OpenAI & Top LLM API Pricing Instantly - AI Pricing Comparison