Trendende KI-Beiträge & schnelle Research-Updates - Seite 1707
IVF-Embryotransfer im Mai 2026: 6. Mai vor 5. Mai
6 Quellen0Sind der 5., 6. und 7.
GPT-5.5, Claude Opus 4.7, DeepSeek V4 und Kimi K2.6: Was Benchmarks wirklich zeigen
15 Quellen0Die sauberste gemeinsame Schnittmenge ist derzeit Terminal Bench 2.0: GPT 5.5 liegt dort mit 82,7 % vorn, vor Claude Opus 4.7, DeepSeek V4 Pro Max und Kimi K2.6 Thinking.[29][30][6]
GPT-5.5-Benchmark: Was 84,9 % auf GDPval wirklich bedeuten
10 Quellen0Der belastbarste Kurzbenchmark für GPT 5.5 ist 84,9 % auf GDPval: OpenAI nennt diesen Wert selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe hinweg.[1]
GPT-5.5 gegen Claude Opus 4.7: Coding-Vorteil für GPT, Design und Kreativität bleiben offen
19 Quellen0Beim Coding spricht die stärkste öffentliche Evidenz für GPT 5.5: berichtete 82,7 % in Terminal Bench und ein leichter Vorteil bei tool und dateinavigationslastigen SWE Bench Aufgaben [4][6].
Claude Opus 4.7 vs. GPT-5.5 beim Coding: Claude für PR-Patches, GPT für Terminal-Agenten
12 Quellen0Einen absoluten Coding Sieger gibt es nicht: In SWE Bench Pro liegt Claude Opus 4.7 mit 64,3 % vor GPT 5.5 mit 58,6 %, in Terminal Bench 2.0 führt GPT 5.5 mit 82,7 % vor Opus 4.7 mit 69,4 % [3][6].
Leonardo AI: Funktionen, Preise und kommerzielle Nutzung im Überblick
8 Quellen0Leonardo AI erstellt per Textprompt Bilder, Texturen und Concept Art; Tokens können auch für Videoerstellung, Hintergrundentfernung und Upscaling verbraucht werden [7][8].
Claude Code vs. OpenAI Codex: Welcher KI-Coding-Agent passt zu Ihrem Workflow?
15 Quellen0Claude Code passt besser zu enger, entwicklergeführter Arbeit im Repository; OpenAI Codex eignet sich eher für klar abgegrenzte Aufgaben, die ein Cloud Agent bearbeitet und zur Prüfung zurückgibt.
Fabian Society und Eugenik: Was die Quellen wirklich belegen
5 Quellen0Die Fabian Society wurde 1884 gegründet; die Quellen zeigen eine historische Überschneidung mit Eugenik Debatten, besonders über George Bernard Shaw, aber keinen Nachweis für heutige Eugenik Positionen [4][6...
KI-Trends in Taiwan 2025: 9 Themen für Marketing und Engineering
12 Quellen0Taiwanische Unternehmen erhöhen ihre KI Investitionen 2025 deutlich: Laut iThome steigen sie um 39 %, von durchschnittlich 8,19 Mio.
OpenAI-Modelle 2026: Was in ChatGPT, API und Codex aktuell ist
24 Quellen0Für ChatGPT sind in den zitierten OpenAI Dokumenten vor allem GPT 5.4 Thinking/Pro, GPT 5.3 Instant, GPT 5.4 mini und GPT 5.2 Zeilen relevant.
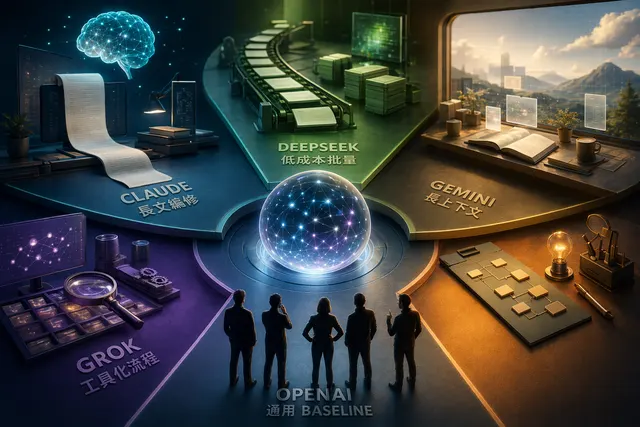
OpenAI, Claude, DeepSeek, Gemini oder Grok: Welches KI-Modell passt zum Content-Marketing?
18 Quellen0Öffentliche Preis und Spezifikationsdaten reichen nicht aus, um ein einzelnes bestes KI Modell für Content Marketing zu küren.
Hongkongs KI-Suche: Eine Top-10 der meistzitierten Quellen ist derzeit nicht belegbar
15 Quellen0Eine öffentlich verifizierbare „Top 10 der KI Suchquellen in Hongkong“ gibt es derzeit nicht.