GPT-5.5-Benchmark: Was 84,9 % auf GDPval wirklich bedeuten
Der belastbarste Kurzbenchmark für GPT 5.5 ist 84,9 % auf GDPval: OpenAI nennt diesen Wert selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe hinweg.[1] Andere Werte wie 73,1 % auf Expert SWE oder 80,5 % auf BixBench messen andere Aufgabenfelder und sollten nicht direkt mit GDP...
Veröffentlicht vonBearbeitet mit GPT-5.5Bilder erstellt mit GPT Image 2
Der belastbarste Kurzbenchmark für GPT 5.5 ist 84,9 % auf GDPval: OpenAI nennt diesen Wert selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe hinweg.[1]
Andere Werte wie 73,1 % auf Expert SWE oder 80,5 % auf BixBench messen andere Aufgabenfelder und sollten nicht direkt mit GDPval verglichen werden.[8][10]
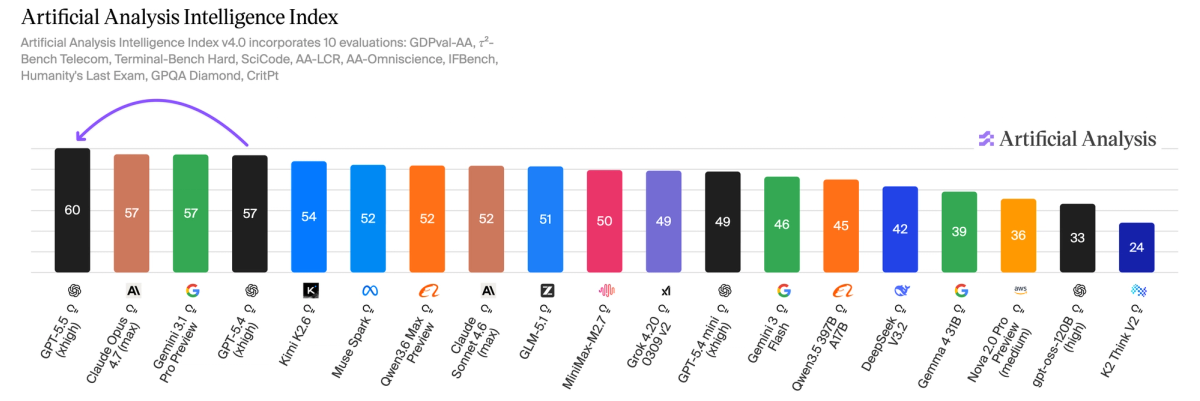
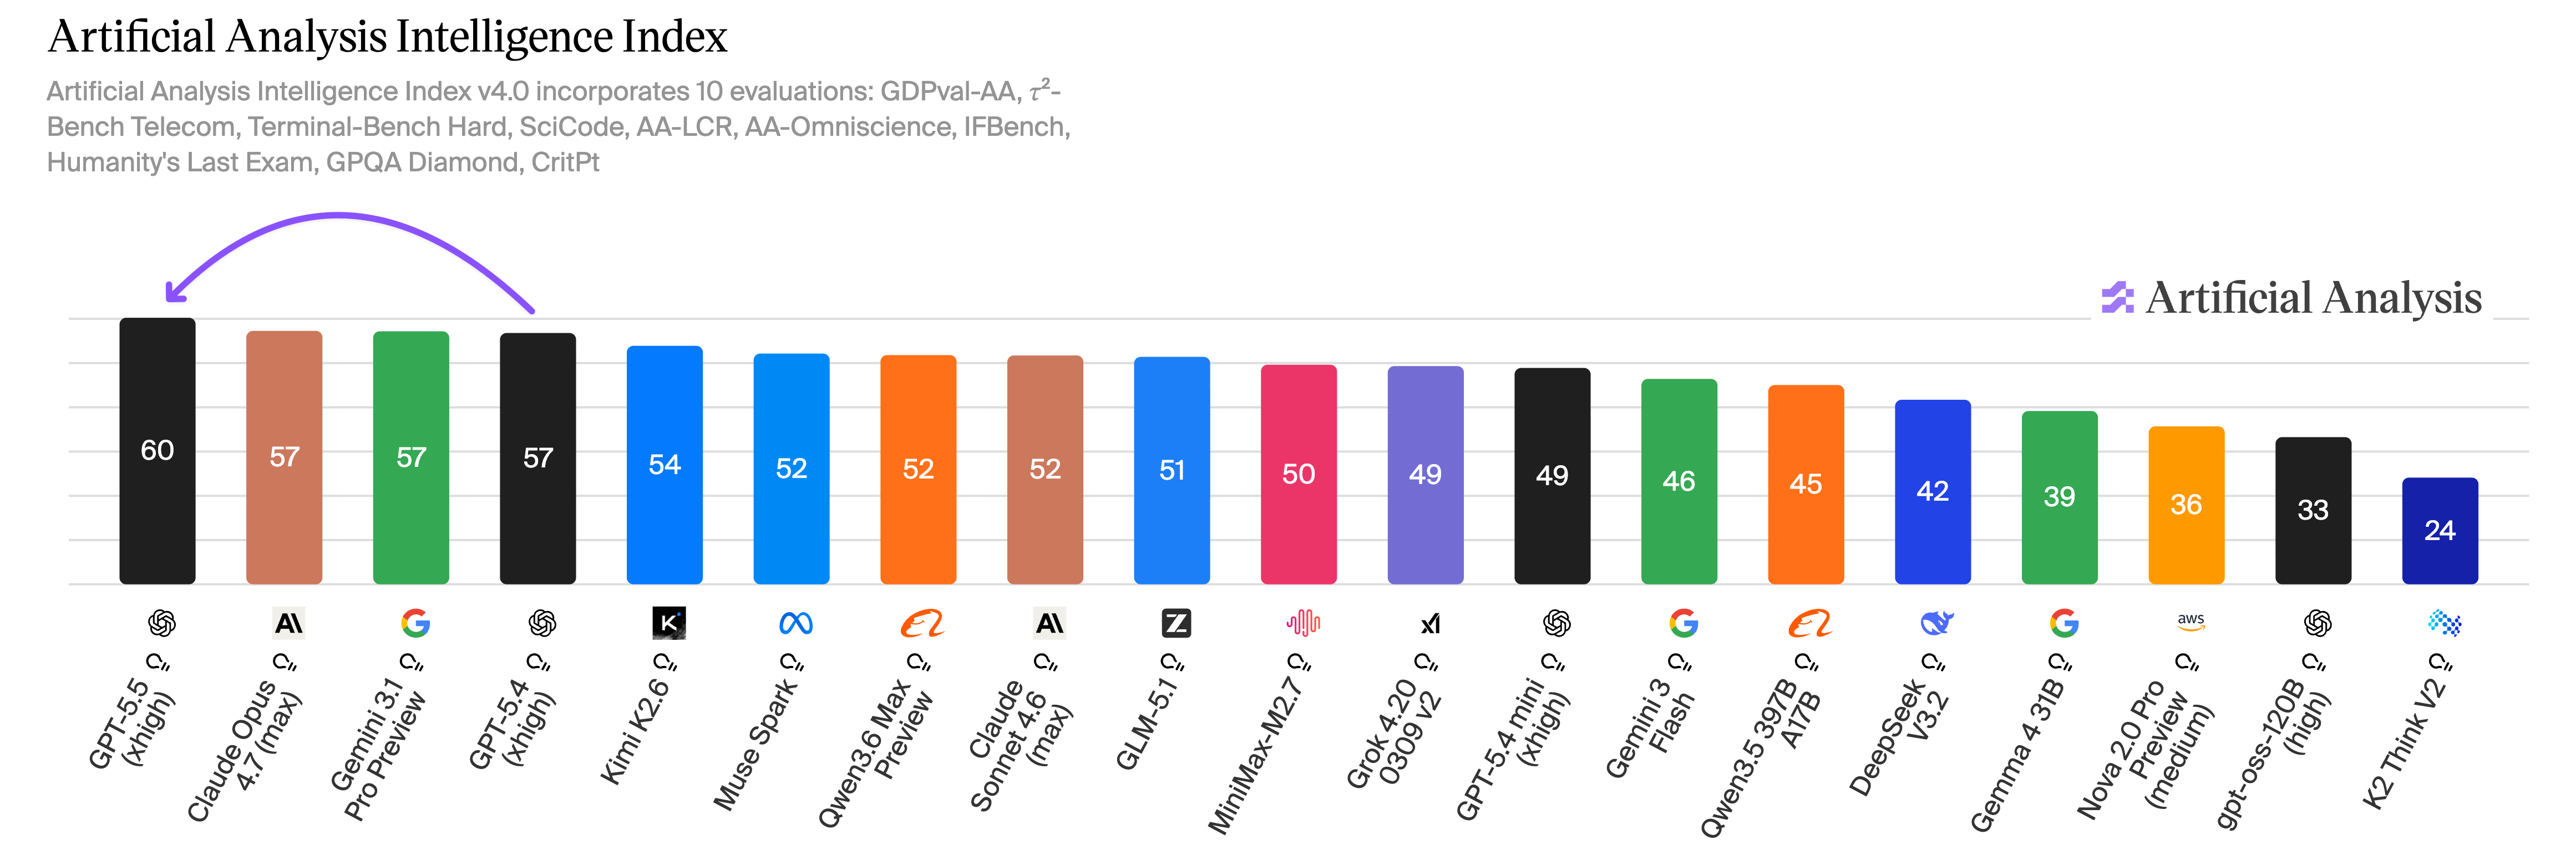
Für externe Modellvergleiche ist Artificial Analysis nützlich: Dort führt GPT 5.5 den Intelligence Index mit drei Punkten Vorsprung an, gewinnt aber nicht jeden Einzeltest.[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
KI-Prompt
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
Wer nach „dem“ Benchmark von GPT-5.5 fragt, braucht zuerst den Kontext. Für eine allgemeine Kurzantwort ist 84,9 % auf GDPval die stärkste Zahl: OpenAI nennt sie selbst und beschreibt GDPval als Benchmark für Agenten, die klar spezifizierte Wissensarbeit über 44 Berufe hinweg erstellen sollen.
Wichtig ist die Einschränkung: Dieser Wert ist keine universelle Intelligenz- oder Qualitätsnote. Er sagt vor allem etwas über berufsnahe Wissensarbeit, Aufgabenverständnis und die Erstellung definierter Arbeitsergebnisse aus.
Der wichtigste Kurzbenchmark: 84,9 % auf GDPval
Wenn nur eine Zahl genannt werden soll, ist diese Formulierung am präzisesten:
GPT-5.5 erreicht laut OpenAI 84,9 % auf GDPval, einem Benchmark für klar spezifizierte Wissensarbeit über 44 Berufe hinweg.
Studio Global AI
Setzen Sie Ihre Recherche fort
Diese Seite enthält eine quellengestützte Antwort, die Sie in Studio Global fortsetzen können.
Wie lautet die kurze Antwort auf „GPT-5.5-Benchmark: Was 84,9 % auf GDPval wirklich bedeuten“?
Der belastbarste Kurzbenchmark für GPT 5.5 ist 84,9 % auf GDPval: OpenAI nennt diesen Wert selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe hinweg.[1]
Was sind die wichtigsten Punkte, die zuerst validiert werden müssen?
Der belastbarste Kurzbenchmark für GPT 5.5 ist 84,9 % auf GDPval: OpenAI nennt diesen Wert selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe hinweg.[1] Andere Werte wie 73,1 % auf Expert SWE oder 80,5 % auf BixBench messen andere Aufgabenfelder und sollten nicht direkt mit GDPval verglichen werden.[8][10]
Was soll ich als nächstes in der Praxis tun?
Für externe Modellvergleiche ist Artificial Analysis nützlich: Dort führt GPT 5.5 den Intelligence Index mit drei Punkten Vorsprung an, gewinnt aber nicht jeden Einzeltest.[3]
Das ist besonders nützlich für eine schnelle Einordnung von GPT-5.5 als Arbeitsmodell. GDPval ist aber nicht dasselbe wie ein Coding-Test, ein Bioinformatik-Benchmark oder ein externer Modellindex. Genau deshalb führen andere Prozentwerte schnell in die Irre, wenn sie ohne Kontext nebeneinandergestellt werden.
Die wichtigsten öffentlich genannten Werte im Überblick
Benchmark oder Vergleich
Gemeldeter Wert
Wofür der Wert steht
Einordnung
GDPval
84,9 %
Klar spezifizierte Wissensarbeit über 44 Berufe
Direkt in OpenAIs GPT-5.5-Ankündigung genannt und deshalb der naheliegende Kurzbenchmark.
Expert-SWE
73,1 %
Coding-Aufgaben; laut Bericht eine interne Evaluation für Aufgaben mit geschätzter Bearbeitungszeit von 20 Stunden
Relevanter für Softwareentwicklung als GDPval, aber nicht direkt mit GDPval vergleichbar.
BixBench
80,5 %
Real-World-Bioinformatik-Benchmark
Thematisch relevant für Bioinformatik; in den vorliegenden Quellen schwächer belegt als der OpenAI-Wert zu GDPval.
Artificial Analysis Intelligence Index
Platz 1, plus 3 Punkte
Externer Modellindex von Artificial Analysis
Hilfreich für einen breiteren Modellvergleich, aber kein einzelner offizieller OpenAI-Benchmark.
Warum die Prozentwerte nicht direkt vergleichbar sind
84,9 %, 73,1 % und 80,5 % sehen aus wie Werte aus derselben Rangliste. Das sind sie nicht.
84,9 % auf GDPval bezieht sich auf spezifizierte Wissensarbeit über viele Berufe hinweg.
73,1 % auf Expert-SWE bezieht sich auf Coding-Aufgaben in einer internen Evaluation.
80,5 % auf BixBench bezieht sich auf Bioinformatik-Aufgaben.
Die bessere Frage lautet deshalb nicht: „Welcher Prozentwert ist am höchsten?“ Sondern: „Welcher Benchmark passt zum Einsatzfall?“ Für allgemeine Wissensarbeit ist GDPval der bessere Referenzpunkt; für Softwareentwicklung ist Expert-SWE näher am Problem; für Bioinformatik ist BixBench thematisch passender.
Was der Artificial-Analysis-Wert aussagt
Artificial Analysis berichtet, dass GPT-5.5 den eigenen Intelligence Index mit drei Punkten Vorsprung anführt. Gleichzeitig heißt es dort, OpenAI führe fünf der Headline-Evaluationen an und liege in drei weiteren hinter Gemini 3.1 Pro Preview.
Das ist eine wichtige Nuance: Platz 1 in einem externen Index bedeutet nicht, dass ein Modell jeden Einzeltest gewinnt. Es bedeutet, dass GPT-5.5 nach der Methodik dieses Drittanbieter-Index insgesamt vorn liegt.
Vorsicht bei isolierten Schlagzeilenwerten
Einige Berichte nennen weitere GPT-5.5-Zahlen, etwa 91,7 % im Zusammenhang mit Legal-AI-Fähigkeiten oder 82,7 % im Kontext von agentic coding. Solche Werte können für den jeweiligen Spezialfall interessant sein. Für eine allgemeine Benchmark-Antwort sind sie aber weniger geeignet, solange Testaufbau, Vergleichsgruppe und Messziel nicht genauso klar sind wie beim direkt von OpenAI genannten GDPval-Wert.
Welche Zahl sollte man zitieren?
Für die meisten allgemeinen Vergleiche ist diese Version am saubersten:
GPT-5.5 erzielt laut OpenAI 84,9 % auf GDPval; GDPval testet die Fähigkeit von Agenten, klar spezifizierte Wissensarbeit über 44 Berufe hinweg zu erstellen.
Wenn der Kontext enger ist, sollte der Benchmark entsprechend wechseln:
Allgemeine Wissensarbeit: 84,9 % auf GDPval.
Softwareentwicklung: 73,1 % auf Expert-SWE.
Bioinformatik: 80,5 % auf BixBench, mit Hinweis auf die begrenztere Beleglage.
Breiter Modellvergleich: Platz 1 im Artificial Analysis Intelligence Index mit drei Punkten Vorsprung.
Fazit
Der beste kurze Benchmark-Wert für GPT-5.5 ist 84,9 % auf GDPval. Er ist direkt bei OpenAI belegt und hat einen klar beschriebenen Messbereich: spezifizierte Wissensarbeit über 44 Berufe hinweg. Andere Zahlen können je nach Einsatzfall wichtiger sein, sollten aber immer zusammen mit ihrem jeweiligen Benchmark genannt werden.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
Das ist besonders nützlich für eine schnelle Einordnung von GPT-5.5 als Arbeitsmodell. GDPval ist aber nicht dasselbe wie ein Coding-Test, ein Bioinformatik-Benchmark oder ein externer Modellindex. Genau deshalb führen andere Prozentwerte schnell in die Irre, wenn sie ohne Kontext nebeneinandergestellt werden.
Die wichtigsten öffentlich genannten Werte im Überblick
Benchmark oder Vergleich
Gemeldeter Wert
Wofür der Wert steht
Einordnung
GDPval
84,9 %
Klar spezifizierte Wissensarbeit über 44 Berufe
Direkt in OpenAIs GPT-5.5-Ankündigung genannt und deshalb der naheliegende Kurzbenchmark.
Expert-SWE
73,1 %
Coding-Aufgaben; laut Bericht eine interne Evaluation für Aufgaben mit geschätzter Bearbeitungszeit von 20 Stunden
Relevanter für Softwareentwicklung als GDPval, aber nicht direkt mit GDPval vergleichbar.
BixBench
80,5 %
Real-World-Bioinformatik-Benchmark
Thematisch relevant für Bioinformatik; in den vorliegenden Quellen schwächer belegt als der OpenAI-Wert zu GDPval.
Artificial Analysis Intelligence Index
Platz 1, plus 3 Punkte
Externer Modellindex von Artificial Analysis
Hilfreich für einen breiteren Modellvergleich, aber kein einzelner offizieller OpenAI-Benchmark.
Warum die Prozentwerte nicht direkt vergleichbar sind
84,9 %, 73,1 % und 80,5 % sehen aus wie Werte aus derselben Rangliste. Das sind sie nicht.
84,9 % auf GDPval bezieht sich auf spezifizierte Wissensarbeit über viele Berufe hinweg.
73,1 % auf Expert-SWE bezieht sich auf Coding-Aufgaben in einer internen Evaluation.
80,5 % auf BixBench bezieht sich auf Bioinformatik-Aufgaben.
Die bessere Frage lautet deshalb nicht: „Welcher Prozentwert ist am höchsten?“ Sondern: „Welcher Benchmark passt zum Einsatzfall?“ Für allgemeine Wissensarbeit ist GDPval der bessere Referenzpunkt; für Softwareentwicklung ist Expert-SWE näher am Problem; für Bioinformatik ist BixBench thematisch passender.
Was der Artificial-Analysis-Wert aussagt
Artificial Analysis berichtet, dass GPT-5.5 den eigenen Intelligence Index mit drei Punkten Vorsprung anführt. Gleichzeitig heißt es dort, OpenAI führe fünf der Headline-Evaluationen an und liege in drei weiteren hinter Gemini 3.1 Pro Preview.
Das ist eine wichtige Nuance: Platz 1 in einem externen Index bedeutet nicht, dass ein Modell jeden Einzeltest gewinnt. Es bedeutet, dass GPT-5.5 nach der Methodik dieses Drittanbieter-Index insgesamt vorn liegt.
Vorsicht bei isolierten Schlagzeilenwerten
Einige Berichte nennen weitere GPT-5.5-Zahlen, etwa 91,7 % im Zusammenhang mit Legal-AI-Fähigkeiten oder 82,7 % im Kontext von agentic coding. Solche Werte können für den jeweiligen Spezialfall interessant sein. Für eine allgemeine Benchmark-Antwort sind sie aber weniger geeignet, solange Testaufbau, Vergleichsgruppe und Messziel nicht genauso klar sind wie beim direkt von OpenAI genannten GDPval-Wert.
Welche Zahl sollte man zitieren?
Für die meisten allgemeinen Vergleiche ist diese Version am saubersten:
GPT-5.5 erzielt laut OpenAI 84,9 % auf GDPval; GDPval testet die Fähigkeit von Agenten, klar spezifizierte Wissensarbeit über 44 Berufe hinweg zu erstellen.
Wenn der Kontext enger ist, sollte der Benchmark entsprechend wechseln:
Allgemeine Wissensarbeit: 84,9 % auf GDPval.
Softwareentwicklung: 73,1 % auf Expert-SWE.
Bioinformatik: 80,5 % auf BixBench, mit Hinweis auf die begrenztere Beleglage.
Breiter Modellvergleich: Platz 1 im Artificial Analysis Intelligence Index mit drei Punkten Vorsprung.
Fazit
Der beste kurze Benchmark-Wert für GPT-5.5 ist 84,9 % auf GDPval. Er ist direkt bei OpenAI belegt und hat einen klar beschriebenen Messbereich: spezifizierte Wissensarbeit über 44 Berufe hinweg. Andere Zahlen können je nach Einsatzfall wichtiger sein, sollten aber immer zusammen mit ihrem jeweiligen Benchmark genannt werden.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News