熱門 - 第 286 頁
浪潮元腦 SD200 Ultra 集結 128 顆 AI 晶片:Kimi K3 速度宣稱怎麼看?
17 個來源0浪潮信息稱,元腦 SD200 Ultra 以 128 顆本土 AI 加速晶片運行 2.8 兆參數的 Kimi K3,每生成一個詞元的時間低於 5.85 毫秒;這並非獨立驗證結果。[1][3]
中國軌道資料中心逐步成形:衛星已能運算,離「太空雲端」還有多遠?
25 個來源0截至 2026 年 9 月,中國已有首批 12 顆三體計算星座衛星入軌、天算星座提供常態化在軌實驗服務,並測得衛星對地雷射下傳峰值 120 Gbps。[11][46][21]
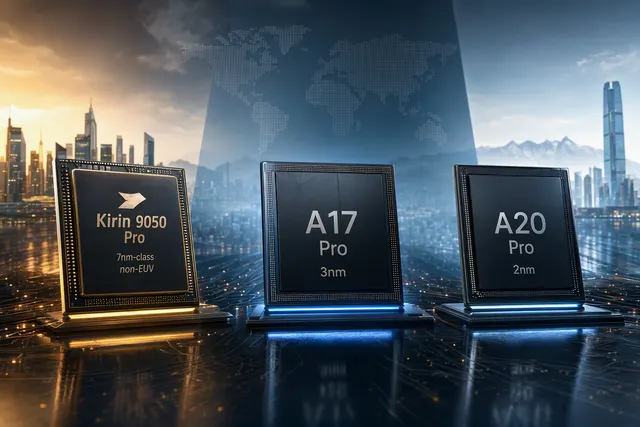
麒麟 9050 Pro 跑贏蘋果?先看清楚贏的是哪一項測試
21 個來源0據伯恩斯坦評估,麒麟 9050 Pro 在 Geekbench 6 多核心測試勝過 A17 Pro,但整體效能仍落後較新的 A20 Pro 約 30%。[1][6]
Qwen 4 還在訓練中:阿里巴巴雲棲大會公布了什麼?
23 個來源0阿里巴巴於2026年9月22日表示,Qwen 4 正在訓練,尚未發布;5兆至10兆參數的目標指向後續的 Qwen 4.5 與 Qwen 5 系列,並非 Qwen 4 的已確認規格。[3]
阿里雲 Agentic Cloud 怎麼運作?看懂 AgentCore、CPFS 與 HPN 8.0 Pro 的分工
17 個來源0阿里雲將 Model、Harness、Context 三種需求,分別對應 AI Native Cloud、Agent Native Cloud 與 Context Engine。[3][4]
阿里巴巴雲棲大會語音模型一次看:即時翻譯與 Qwen-Audio-3.1 有何不同?
16 個來源0Qwen3.8 LiveTranslate 主打同聲傳譯;阿里巴巴稱,其翻譯延遲指標由約 2.8 秒降至 2.3 秒,數據尚非獨立測試結果。[3][7]
ZCode 上傳程式碼庫風波:智譜修掉了什麼,第三方查到了什麼?
22 個來源0研究人員發現,ZCode 可將登入使用者的本機工作區連同 Git 歷史加密上傳;智譜隨後致歉、公開程式碼,並在 v3.14.0 移除 Repo Wiki 及相關上傳流程。[2][4][13]
華為 OceanStor M900 如何讓 AI 推理共用 64 PB KV 快取?
19 個來源0華為稱 OceanStor M900 可透過 UnifiedBus,在晶片記憶體、DRAM 與 SSD 之間建立共享 KV 快取;64 PB 指單一叢集容量,不是單顆 NPU 的記憶體。[3][6][17]
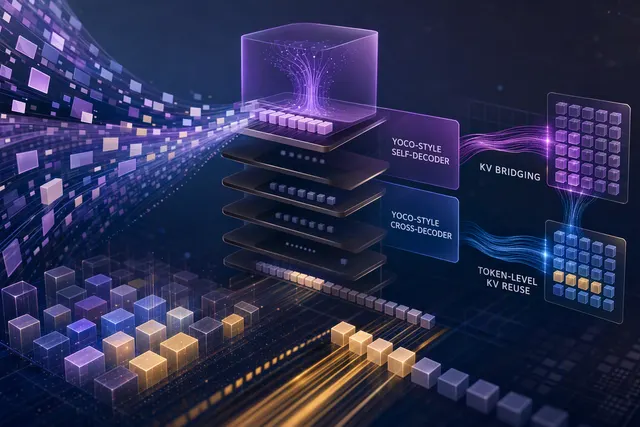
小米 HySparse2 如何減輕百萬 Token 長文本的預填充負擔
14 個來源0在總參數 800 億、每個 Token 約啟用 30 億參數的 MoE 比較中,HySparse2 於百萬 Token 下的預填充 FLOPs 為 Hybrid SWA 的 1/5.02,KV 快取為 2.69 GB,對照組則為 12.09 GB。[6][15]
阿里巴巴 Qwen Intelligence 是什麼?榮耀 Magic9 將率先導入的手機 AI 智能體
25 個來源0Qwen Intelligence 是供手機廠商整合的 AI 智能體軟體平台;阿里巴巴並未因此推出自家手機。
Qwen Book 想讓 AI 不只回答問題:阿里雲的「OS as Harness」是什麼?
17 個來源0阿里雲在 2026 年雲棲大會發表 Qwen Book,構想是讓 AI 智慧體以作業系統為工作環境,跨應用程式延續任務。[1][6]
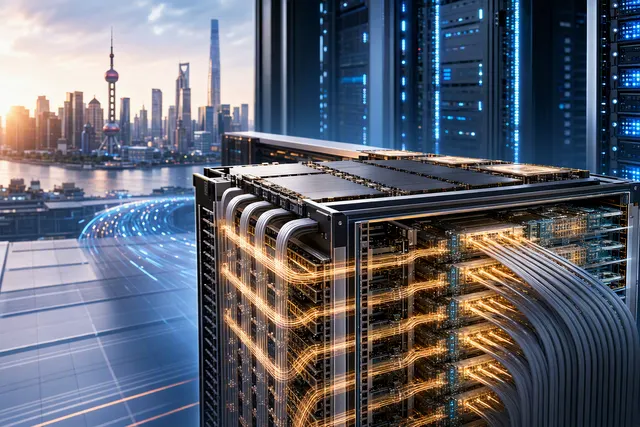
華為 Atlas 960E 如何串起 4,096 顆 NPU?關鍵在光互連
20 個來源0華為於 2026 年 9 月 17 日在上海發表 Atlas 960E SuperPoD,宣稱單套系統最多可擴充至 4,096 顆 NPU;FP8 與 FP4 峰值算力分別為 8 與 16 EFLOPS。[1][3][6]