答案已發布26 個來源
三星 zHBM:直接堆疊在 AI 加速器上的 HBM,能帶來什麼改變?
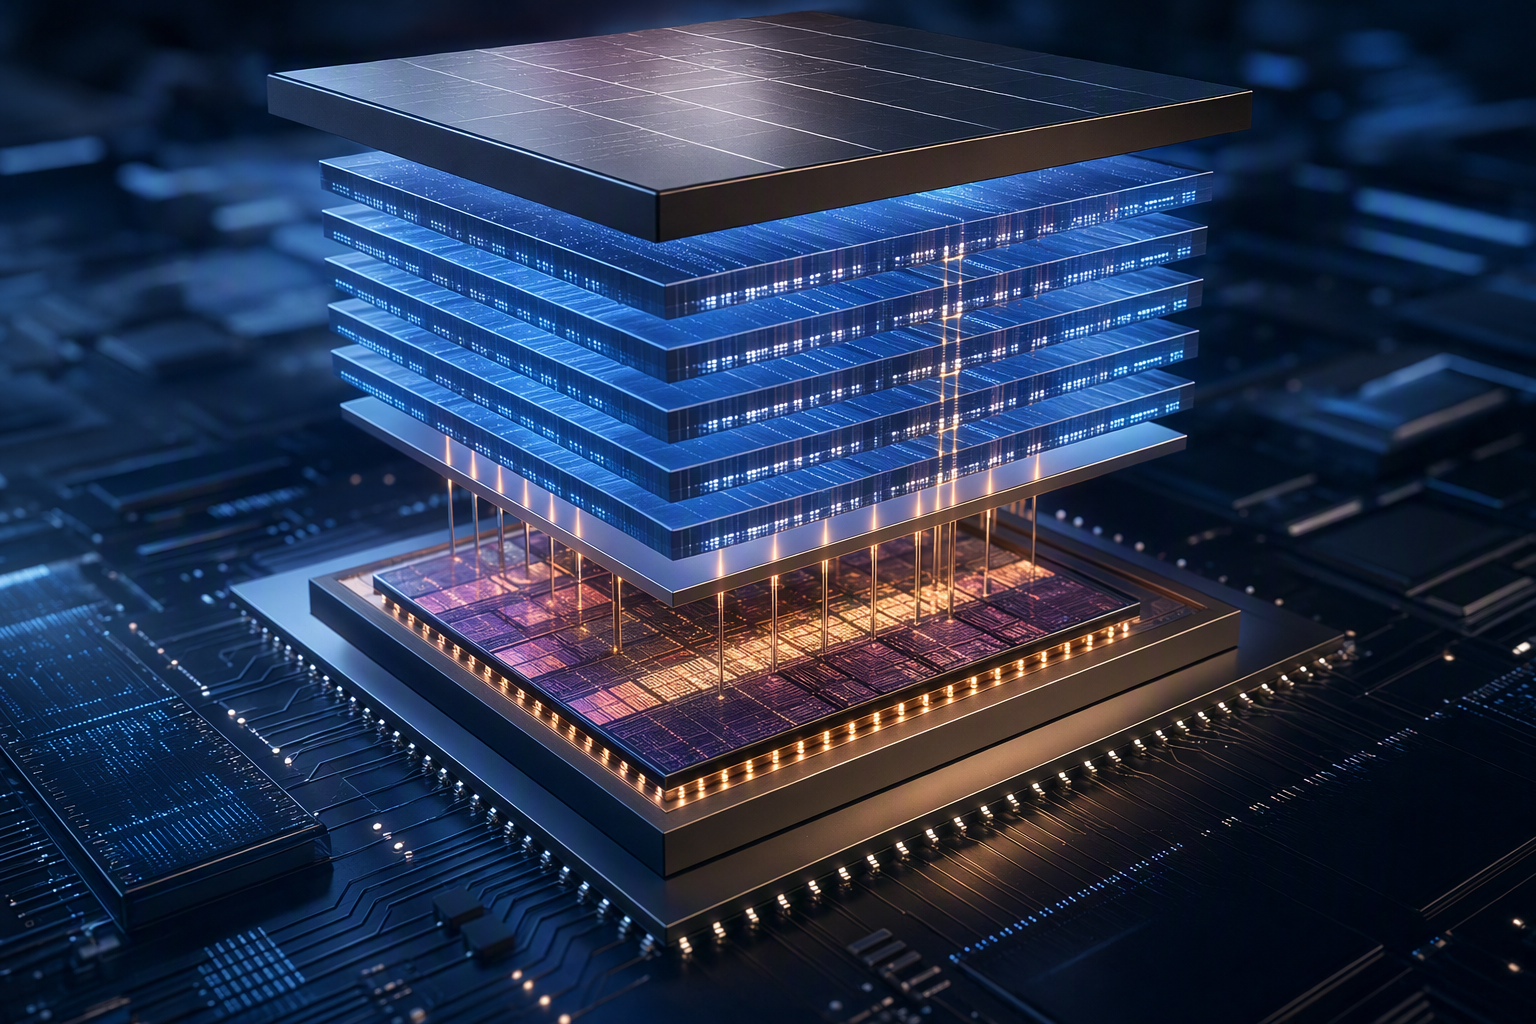
三星的 zHBM 構想,是將高頻寬記憶體直接堆疊在 AI 加速器上方,而非像現行 HBM 封裝般並排配置。 三星預估,採用 zHBM 的次世代介面可達約 HBM5 的 8 倍效能、超過 10 倍記憶體密度、3 倍能源效率,並將熱阻降低逾 50%;這些均為公司對未來架構的目標。
發布者使用 GPT-5.6 Terra 編輯圖片由 GPT Image 2 生成
研究答案
重點整理
- 三星的 zHBM 構想,是將高頻寬記憶體直接堆疊在 AI 加速器上方,而非像現行 HBM 封裝般並排配置。
- 三星預估,採用 zHBM 的次世代介面可達約 HBM5 的 8 倍效能、超過 10 倍記憶體密度、3 倍能源效率,並將熱阻降低逾 50%;這些均為公司對未來架構的目標。
- OpenAI 與 Intel 工程人員認為,CXL 較適合補充容量或存放低頻資料,難以取代 HBM 在 AI 模型即時運算中的角色。
AI 提示詞
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
三星電子在 9 月 16 日於美國加州聖塔克拉拉舉行的 AI Infrastructure Summit 上,將 zHBM 描述為面向 AI 代理(agentic AI)的下一代記憶體架構:不再把高頻寬記憶體(HBM)放在 GPU 或其他 AI 加速器旁邊,而是直接垂直堆疊在處理器上方。三星認為,這可把 AI 系統反應速度推升逾 10 倍,目標指向每秒 1,000 個 token。 1
9
這項訊息的重點不只是「記憶體更快」,而是 AI 效能的瓶頸正從純運算能力,轉向資料在運算晶片與記憶體之間移動時所造成的頻寬、耗電、容量與熱問題。
zHBM 與現行 2.5D HBM 封裝有何不同?
目前常見的 HBM 設計,通常是把 HBM 與 GPU、AI 加速器放在同一平面,透過先進封裝互連;這類配置常被歸入 2.5D 封裝。zHBM 則進一步把 HBM 直接堆到 AI 加速器上方,形成邏輯與記憶體的 3D 垂直整合。 12
13
直觀來說,資料要走的路變短了。三星主張,較短的實體傳輸距離可提高頻寬與能源效率,也能在相同面積中容納更多記憶體。實現此一設計的關鍵,是次世代晶圓鍵合技術,包括混合銅鍵合(hybrid copper bonding)。 7
48
不過,zHBM 目前仍是三星展示的概念模型,尚未公布商業化時程;它不是已可直接取代所有既有 HBM 封裝的量產產品。 13
14
三星提出哪些效能與能效目標?
三星對導入 zHBM 的次世代介面提出以下目標:
此外,三星在 AI Infrastructure Summit 表示,zHBM 可望讓 AI 系統的回應速度提高超過 10 倍,並以每秒 1,000 個 token 為目標。 1
9
這些數字應視為三星針對未來架構提出的公司目標,而非已上市加速器的第三方實測成績。把記憶體直接堆在邏輯晶片上,還必須克服量產良率、散熱、可靠度,以及與加速器合作夥伴共同驗證等難題。
為何 AI 代理特別在意記憶體距離?
AI 代理不只是一次性生成文字。它需要反覆讀取上下文、執行推論、呼叫工具、處理結果並輸出回應。在這類工作負載中,即使運算晶片很強,只要仍在等待資料搬移,整體回應就會延遲。
zHBM 的設計正是針對這個「記憶體與資料傳輸瓶頸」。三星的基本邏輯是:讓 HBM 更靠近加速器,有助於提升資料搬移的效率與系統反應性。 1
7
但能否達到所宣稱的端到端反應速度增益,仍取決於完整系統,包括加速器架構、軟體、模型設計與封裝方式,並非只靠記憶體位置改變就能保證。
zNAND-O:與 zHBM 搭配的高容量記憶體層
三星同時提出 zNAND-O,這是一種面向資料密集與邊緣 AI 環境的高效能 NAND 架構。它被定位在 DRAM 與傳統 NAND 儲存之間:目標是在提供比 DRAM 更高密度的同時,改善傳統 NAND 的 I/O 效能、延遲與電力效率。 49
51
兩者處理的是 AI 記憶體階層中不同的任務:
三星提及一項使用 1,200 億參數 GPT 模型的測試:zNAND-O 的 tokens-per-second 可達到傳統 DRAM 伺服器相同水準,而營運成本為後者的六分之一。這是三星公布的測試結果,不能直接理解為所有大型模型部署都能取得同等成本優勢。 54
55
三星也將 zNAND-O 與更長期的裝置端 AI 挑戰連結,指出到 2030 年,兆參數等級的裝置端 AI 可能成為重要需求。 53
CXL 不太可能取代 HBM 的即時運算角色
同場峰會也突顯一個現實:AI 系統需要更多容量,不代表各類記憶體可以互相替代。
OpenAI 的加速器研究人員 Daniel Morris 表示,他尚未找到 CXL 可用於「實際執行 AI 模型」的案例;不過,CXL 或可用來放置大型模型中較少使用的資料。Intel 的 Vidia Thiagarajan 也認為,CXL 記憶體池化較接近次級儲存的補充,而不是 HBM 的替代方案,原因之一是 CXL 連接記憶體與 HBM 之間仍存在頻寬差距。 18
22
CXL 並非沒有用處;更合理的走向是分層架構:HBM 放在加速器附近,處理對頻寬最敏感的活躍運算;CXL 與其他儲存、記憶體層則承擔偏容量導向的工作。
對三星與 SK hynix 的意義:概念之外,量產執行更重要
短期的 HBM 競爭,仍取決於供應商能否針對特定 AI 加速器平台製造、完成驗證並穩定出貨。zHBM 為三星提供了差異化的長期架構方向,但不會自動解決良率、熱管理、可靠度與客戶整合問題。
另一方面,OpenAI 與 Intel 對 CXL 取代 HBM 的保留態度,也凸顯加速器近端高頻寬記憶體的重要性仍在。對整個 HBM 市場而言,競爭不只在誰提出更積極的 3D 記憶體概念,更在誰能最早把先進封裝與記憶體設計轉化為通過驗證、可量產出貨的產品。 18
33
36
結論
三星這次的核心訊息是:AI 的限制愈來愈不只是運算吞吐量,而是記憶體的資料搬移、容量、功耗與散熱。zHBM 以「記憶體直接疊在加速器上」的 3D 設計回應這些限制;zNAND-O 則為更大規模 AI 工作負載補上一個高密度層級。
三星宣稱的潛在提升幅度很大,但現階段仍屬概念技術目標。對採購端與 AI 基礎設施規劃者而言,眼前最重要的訊號不是 zHBM 即將上市,而是未來 AI 系統很可能採用更專門化、垂直整合程度更高的分層記憶體架構,而 HBM 仍將位居最高效能運算路徑的核心。 13
14
18
Studio Global AI
繼續深入研究
這個頁面包含附來源佐證的答案,你可以在 Studio Global 內繼續追問。
大家也會問
「三星 zHBM:直接堆疊在 AI 加速器上的 HBM,能帶來什麼改變?」的簡短答案是什麼?
三星的 zHBM 構想,是將高頻寬記憶體直接堆疊在 AI 加速器上方,而非像現行 HBM 封裝般並排配置。
最值得優先驗證的重點是什麼?
三星的 zHBM 構想,是將高頻寬記憶體直接堆疊在 AI 加速器上方,而非像現行 HBM 封裝般並排配置。 三星預估,採用 zHBM 的次世代介面可達約 HBM5 的 8 倍效能、超過 10 倍記憶體密度、3 倍能源效率,並將熱阻降低逾 50%;這些均為公司對未來架構的目標。
接下來在實務上該怎麼做?
OpenAI 與 Intel 工程人員認為,CXL 較適合補充容量或存放低頻資料,難以取代 HBM 在 AI 模型即時運算中的角色。
來源
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push
semiconductor.samsung.comSamsung Unveils Next-Gen 3D-Memory Vision at FMS ...