答案已發布16 個來源
語意搜尋 vs 關鍵字搜尋:AI 如何找出你真正想表達的內容
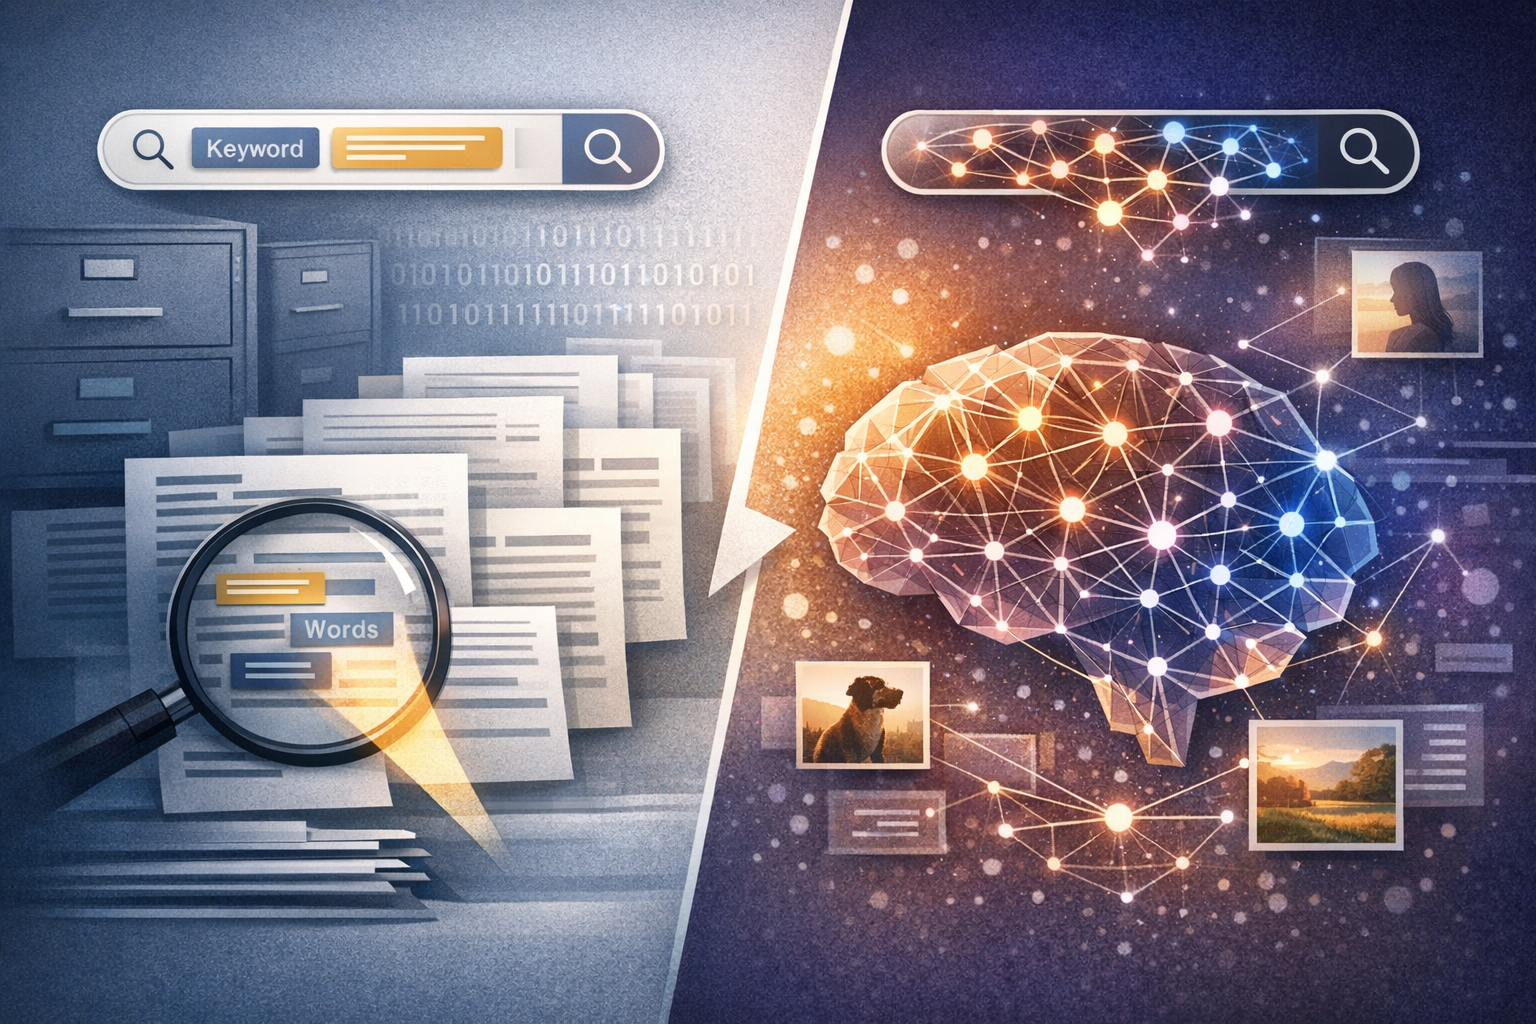
關鍵字搜尋比對文件中的精確或部分文字;語意搜尋則利用神經網路理解查詢背後的意義、脈絡與意圖,即使沒有完全相同的詞彙也能找到相關內容 [1][3][4]。 語意搜尋將查詢與文件轉換為向量嵌入——一種意義的數學表示——透過向量距離計算找出概念相似的結果 [1][9]。
發布者使用 DeepSeek-V4-Flash 編輯圖片由 GPT Image 1.5 生成
研究答案
重點整理
- 關鍵字搜尋比對文件中的精確或部分文字;語意搜尋則利用神經網路理解查詢背後的意義、脈絡與意圖,即使沒有完全相同的詞彙也能找到相關內容 [1][3][4]。
- 語意搜尋將查詢與文件轉換為向量嵌入——一種意義的數學表示——透過向量距離計算找出概念相似的結果 [1][9]。
- 混合搜尋同時執行關鍵字與語意檢索,並整合兩者結果,在精確度與召回率之間取得最佳平衡,已成為現代 AI 工具的主流架構 [2][9]。
AI 提示詞
openai.comCreate a landscape editorial hero image for this Studio Global article: Searching with cited sources for What is the difference between semantic search and keyword search in AI tools?. Article summary: Semantic search and keyword search are fundamentally different approaches to information retrieval. **Keyword search matches exact or partial literal terms** in a document, while **semantic search uses AI/neural networks. Topic tags: general, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbna
如果你曾經用口語化的方式對 AI 工具提問,並且立刻得到精準的回答;或者反過來,你輸入了完整的產品型號,卻得到一堆不相干的結果——那麼你已經親身體驗過語意搜尋與關鍵字搜尋之間的核心差異。
關鍵字搜尋比對文件中精確或部分的字詞,本質上就像是把 Ctrl+F 的功能放大到整個資料庫。而 語意搜尋則運用 AI 與神經網路,理解查詢背後的意義、脈絡與意圖,即使搜尋詞與文件內容沒有一個字完全吻合,也能找出概念上相關的資訊 。這兩種方法沒有絕對的優劣之分;它們各有適合的場景,而目前最聰明的工具通常會將兩者結合,形成所謂的混合搜尋 。
Studio Global AI
繼續深入研究
這個頁面包含附來源佐證的答案,你可以在 Studio Global 內繼續追問。
大家也會問
「語意搜尋 vs 關鍵字搜尋:AI 如何找出你真正想表達的內容」的簡短答案是什麼?
關鍵字搜尋比對文件中的精確或部分文字;語意搜尋則利用神經網路理解查詢背後的意義、脈絡與意圖,即使沒有完全相同的詞彙也能找到相關內容 [1][3][4]。
最值得優先驗證的重點是什麼?
關鍵字搜尋比對文件中的精確或部分文字;語意搜尋則利用神經網路理解查詢背後的意義、脈絡與意圖,即使沒有完全相同的詞彙也能找到相關內容 [1][3][4]。 語意搜尋將查詢與文件轉換為向量嵌入——一種意義的數學表示——透過向量距離計算找出概念相似的結果 [1][9]。
接下來在實務上該怎麼做?
混合搜尋同時執行關鍵字與語意檢索,並整合兩者結果,在精確度與召回率之間取得最佳平衡,已成為現代 AI 工具的主流架構 [2][9]。