答案已發布15 個來源
AI模型崩潰:為何用AI生成資料訓練AI,可能讓模型逐漸「忘記現實」
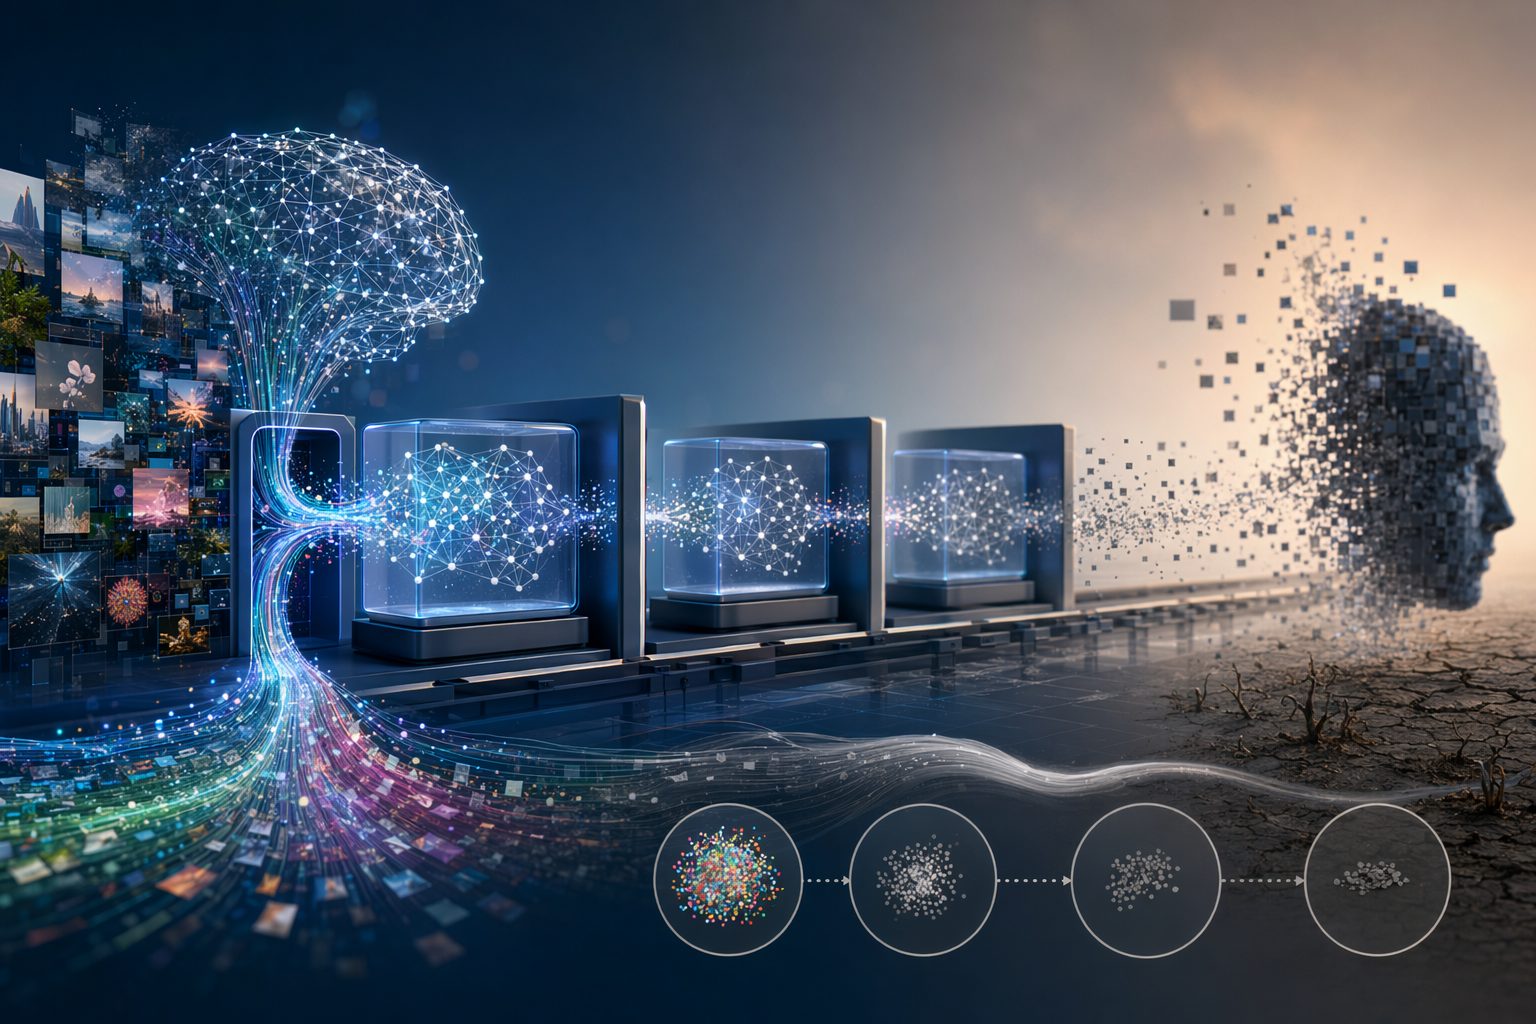
研究指出,若AI模型反覆以AI生成的資料訓練,會出現「模型崩潰」,罕見模式逐漸消失,模型對原始資料分布的理解變得扭曲。[1][4] 遞迴訓練會放大取樣偏差:高機率模式被過度複製,而位於資料分布「尾端」的罕見事件會逐代消失。[1][9] 分析顯示,即使只加入極少量真實世界資料,或在模型中加入先驗知識限制,也可能阻止模型崩潰。[7][33]
發布者使用 GPT-5.5 編輯圖片由 GPT Image 2 生成
研究答案
重點整理
- 研究指出,若AI模型反覆以AI生成的資料訓練,會出現「模型崩潰」,罕見模式逐漸消失,模型對原始資料分布的理解變得扭曲。[1][4]
- 遞迴訓練會放大取樣偏差:高機率模式被過度複製,而位於資料分布「尾端」的罕見事件會逐代消失。[1][9]
- 分析顯示,即使只加入極少量真實世界資料,或在模型中加入先驗知識限制,也可能阻止模型崩潰。[7][33]
AI 提示詞
openai.comCreate a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
生成式人工智慧(Generative AI)越來越常使用**合成資料(synthetic data)**來訓練——也就是由先前AI模型生成的內容。然而研究發現,這種做法存在一個重要風險:模型崩潰(model collapse)。這是一種逐漸發生的退化現象,模型會慢慢失去對原始資料多樣性的理解。
當AI一代又一代用AI產生的資料訓練時,模型會開始遺忘那些在資料中出現頻率較低、但仍然真實存在的模式。久而久之,模型對世界的表徵會變得越來越狹窄,甚至偏離現實。
Studio Global AI
繼續深入研究
這個頁面包含附來源佐證的答案,你可以在 Studio Global 內繼續追問。
大家也會問
「AI模型崩潰:為何用AI生成資料訓練AI,可能讓模型逐漸「忘記現實」」的簡短答案是什麼?
研究指出,若AI模型反覆以AI生成的資料訓練,會出現「模型崩潰」,罕見模式逐漸消失,模型對原始資料分布的理解變得扭曲。[1][4]
最值得優先驗證的重點是什麼?
研究指出,若AI模型反覆以AI生成的資料訓練,會出現「模型崩潰」,罕見模式逐漸消失,模型對原始資料分布的理解變得扭曲。[1][4] 遞迴訓練會放大取樣偏差:高機率模式被過度複製,而位於資料分布「尾端」的罕見事件會逐代消失。[1][9]
接下來在實務上該怎麼做?
分析顯示,即使只加入極少量真實世界資料,或在模型中加入先驗知識限制,也可能阻止模型崩潰。[7][33]
來源
pmc.ncbi.nlm.nih.govAI models collapse when trained on recursively generated data - PMC
pure.ed.ac.uk[PDF] AI models collapse when trained on recursively generated data
openreview.net[PDF] How Bad is Training on Synthetic Data? A Statistical Analysis of ...
techxplore.comA single real-world data point may stop AI model collapse, analysis suggests