答案已發布18 個來源
Kirin 9050 Pro 如何以 LogicFolding 實踐華為的 Tau Scaling
Kirin 9050 Pro 是華為首款採用 LogicFolding 的商用手機處理器:將部分邏輯分布於垂直層次,以縮短關鍵訊號路徑,而非只靠平面製程微縮。 華為的 Tau(τ)Scaling 主張以壓縮訊號傳播延遲為核心,並延伸到元件、電路、晶片、軟體與系統的協同最佳化。
發布者使用 GPT-5.6 Terra 編輯圖片由 GPT Image 2 生成
研究答案
重點整理
- Kirin 9050 Pro 是華為首款採用 LogicFolding 的商用手機處理器:將部分邏輯分布於垂直層次,以縮短關鍵訊號路徑,而非只靠平面製程微縮。
- 華為的 Tau(τ)Scaling 主張以壓縮訊號傳播延遲為核心,並延伸到元件、電路、晶片、軟體與系統的協同最佳化。
- Mate XT 2 是這套架構的首個商用載體;垂直互連的延遲、封裝良率、可靠性與長時間負載下的散熱,仍是必須獨立檢驗的關鍵。
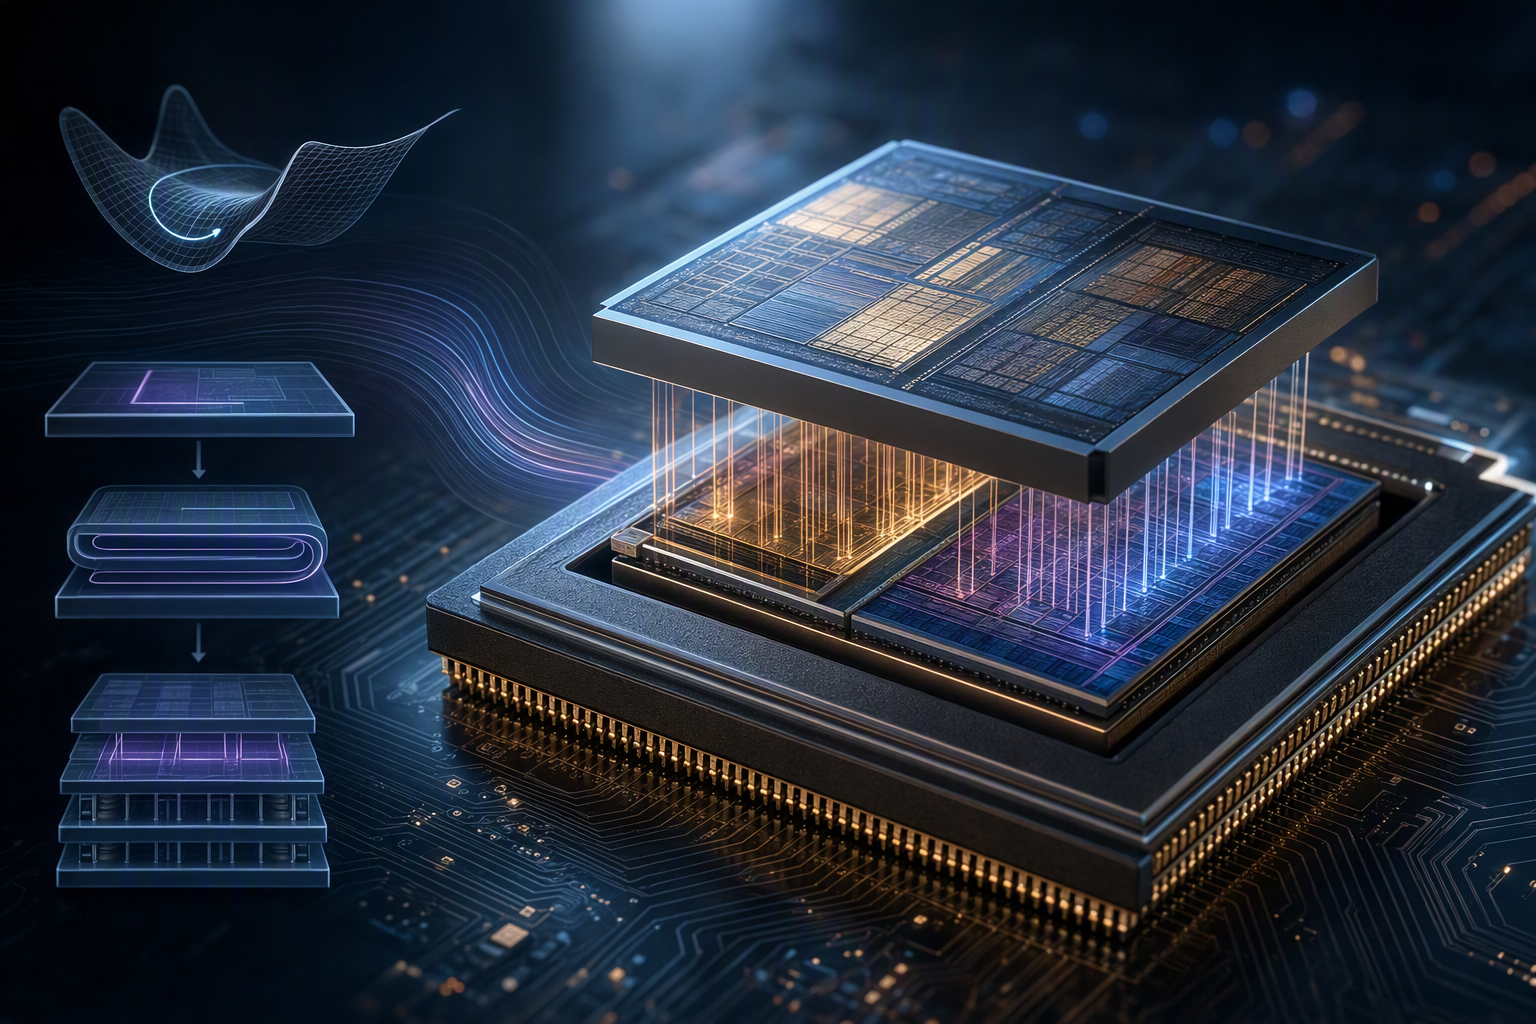
AI 提示詞
openai.comCreate a landscape editorial hero image for this Studio Global article: How does Huawei’s commercially shipped Kirin 9050 Pro implement LogicFolding under He Tingbo’s Tao’s Law, including its two-active-die verti. Article summary: Huawei describes Kirin 9050 Pro as the first commercial implementation of its Tau (τ) Scaling Law: instead of relying primarily on smaller lateral transistor dimensions, it uses LogicFolding to stack logic vertically and. Topic tags: general, general web. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clic
華為將 Kirin 9050 Pro 定位為首款商用導入 LogicFolding 的手機處理器,也是其 Tau(τ)Scaling 架構的首次產品化嘗試。重點不在於完全取代製程微縮,而是藉由把部分邏輯電路改為垂直配置,縮短訊號在晶片內往返的距離,進而降低延遲、提升電晶體密度與能源效率。17
18
從追求「更小」轉向壓縮延遲 τ
傳統晶片演進大多著眼於橫向尺寸的縮小,也就是把電晶體與線路做得更精細。華為在 IEEE ISCAS 2026 提出的 Tau Scaling,則將核心目標放在系統性降低特徵訊號延遲時間 τ;其涵蓋範圍從半導體元件、電路,到晶片與整個運算系統。18
19
在電路層級,LogicFolding 是這套思路的具體作法。原本主要鋪在單一矽晶平面上的邏輯單元,會有選擇地分配到上下層,並透過垂直連接溝通。對於彼此頻繁交換資料的模組而言,較短的走線理論上可降低電阻與寄生電容造成的負擔,從而壓縮關鍵路徑的傳播延遲。18
19
這不是把某個既有製程節點直接變成更先進節點,而是一種結合電路架構與封裝整合的縮放策略:利用第三維空間,改善密度、延遲與功耗之間的取捨。
Kirin 9050 Pro 的垂直邏輯整合意味著什麼?
華為的官方說法是,LogicFolding 會把晶片內選定的邏輯區塊配置於垂直層次,藉此提升電晶體密度、效能與能源效率。17 相關報導則將其描述為:讓原先像單層平面配置的電路,改為類似多層樓的排列,再用垂直互連縮短訊號路徑。
13
這種設計尤其適合處理高頻、低延遲的資料交換需求。不過,外界不應將「垂直堆疊」直接等同於「更先進製程」:前者主要是在既定製程條件下,透過布局與互連方式來爭取效率;後者則涉及電晶體幾何尺寸與製造技術本身。
華為提出了哪些效能主張?
根據已公開的相關報導與公司資料,Kirin 9050 Pro 的電晶體密度據稱由約每平方毫米 1.55 億顆提升至約 2.38 億顆,增幅約 54% 至 55%;同時,SRAM 頻率據稱提高逾 40%。對特定工作負載,報導稱其 NPU、GPU 與效能 CPU 核心的功耗分別可降低約 66%、58% 與 41%。16
這些數字目前應視為華為主張或基於公司資料的報導,而不是已經由第三方重複測得的結論。華為另稱,搭載該晶片的 Mate XT 2 相較前代整體裝置效能提升 42%;報導則提及效能核心時脈為 3.1 GHz。6
13
功能面上,Kirin 9050 Pro 的 GPU 支援硬體加速光線追蹤,NPU 則支援裝置端多模態 mixture-of-experts(MoE,混合專家模型)能力。1 Mate XT 2 採用 HarmonyOS 7.0;這一點也很重要,因為編譯器、執行環境、記憶體調度與模型部署方式,將決定硬體縮短路徑的優勢能否真正反映在日常應用上。
20
3D 邏輯最大的考題:熱與持續效能
垂直整合的代價很直接:更多主動電路層靠近彼此,散熱設計會比純平面布局更棘手。若高負載區塊同時集中運作,局部熱點可能限制持續時脈與效能表現。
因此,對這類架構而言,短時間跑分並不足以回答全部問題。真正值得觀察的是:長時間 CPU、GPU 與 NPU 混合負載下,裝置是否能維持效能、溫度與功耗表現;而目前公開資料尚不足以提供完整的獨立拆解、封裝分析與持續負載功耗測試。
Mate XT 2 是起點,不是終點
Kirin 9050 Pro 在 Mate XT 2 首發,華為也將其稱為 LogicFolding 架構首次走向商用的例子。17 這項意義超過一款摺疊手機的規格升級:它讓 Tau Scaling 從架構論述進入必須實際量產、測試並長期可靠運作的產品階段。
華為提出的方向,是讓 LogicFolding 成為未來晶片與電子系統可延用的方法。但能否擴大採用,不會只取決於電晶體密度或單次效能數字。
接下來仍待獨立驗證的四件事
- 垂直互連的延遲與頻寬:縮短物理距離是否能在真實資料流量下轉化為穩定優勢。
- 封裝良率、成本與測試難度:多層主動電路與高密度連接會提高製造和測試要求。
- 長期可靠性:垂直連接必須承受反覆熱循環與長時間使用。
- 持續效能與散熱:需要在長時間 CPU、GPU、NPU 壓力下測試,而非僅看短暫基準跑分。
簡單說,LogicFolding 是一條由封裝、架構與軟體共同推動的縮放路線:把需要密集溝通的邏輯拉近到三維空間,再針對這種幾何關係調整整個系統。Kirin 9050 Pro 是它首次公開的商業實作;其真正價值,仍要等待第三方針對延遲、功耗、散熱、可靠性與量產效率做出完整檢驗。
Studio Global AI
繼續深入研究
這個頁面包含附來源佐證的答案,你可以在 Studio Global 內繼續追問。
大家也會問
「Kirin 9050 Pro 如何以 LogicFolding 實踐華為的 Tau Scaling」的簡短答案是什麼?
Kirin 9050 Pro 是華為首款採用 LogicFolding 的商用手機處理器:將部分邏輯分布於垂直層次,以縮短關鍵訊號路徑,而非只靠平面製程微縮。
最值得優先驗證的重點是什麼?
Kirin 9050 Pro 是華為首款採用 LogicFolding 的商用手機處理器:將部分邏輯分布於垂直層次,以縮短關鍵訊號路徑,而非只靠平面製程微縮。 華為的 Tau(τ)Scaling 主張以壓縮訊號傳播延遲為核心,並延伸到元件、電路、晶片、軟體與系統的協同最佳化。
接下來在實務上該怎麼做?
Mate XT 2 是這套架構的首個商用載體;垂直互連的延遲、封裝良率、可靠性與長時間負載下的散熱,仍是必須獨立檢驗的關鍵。