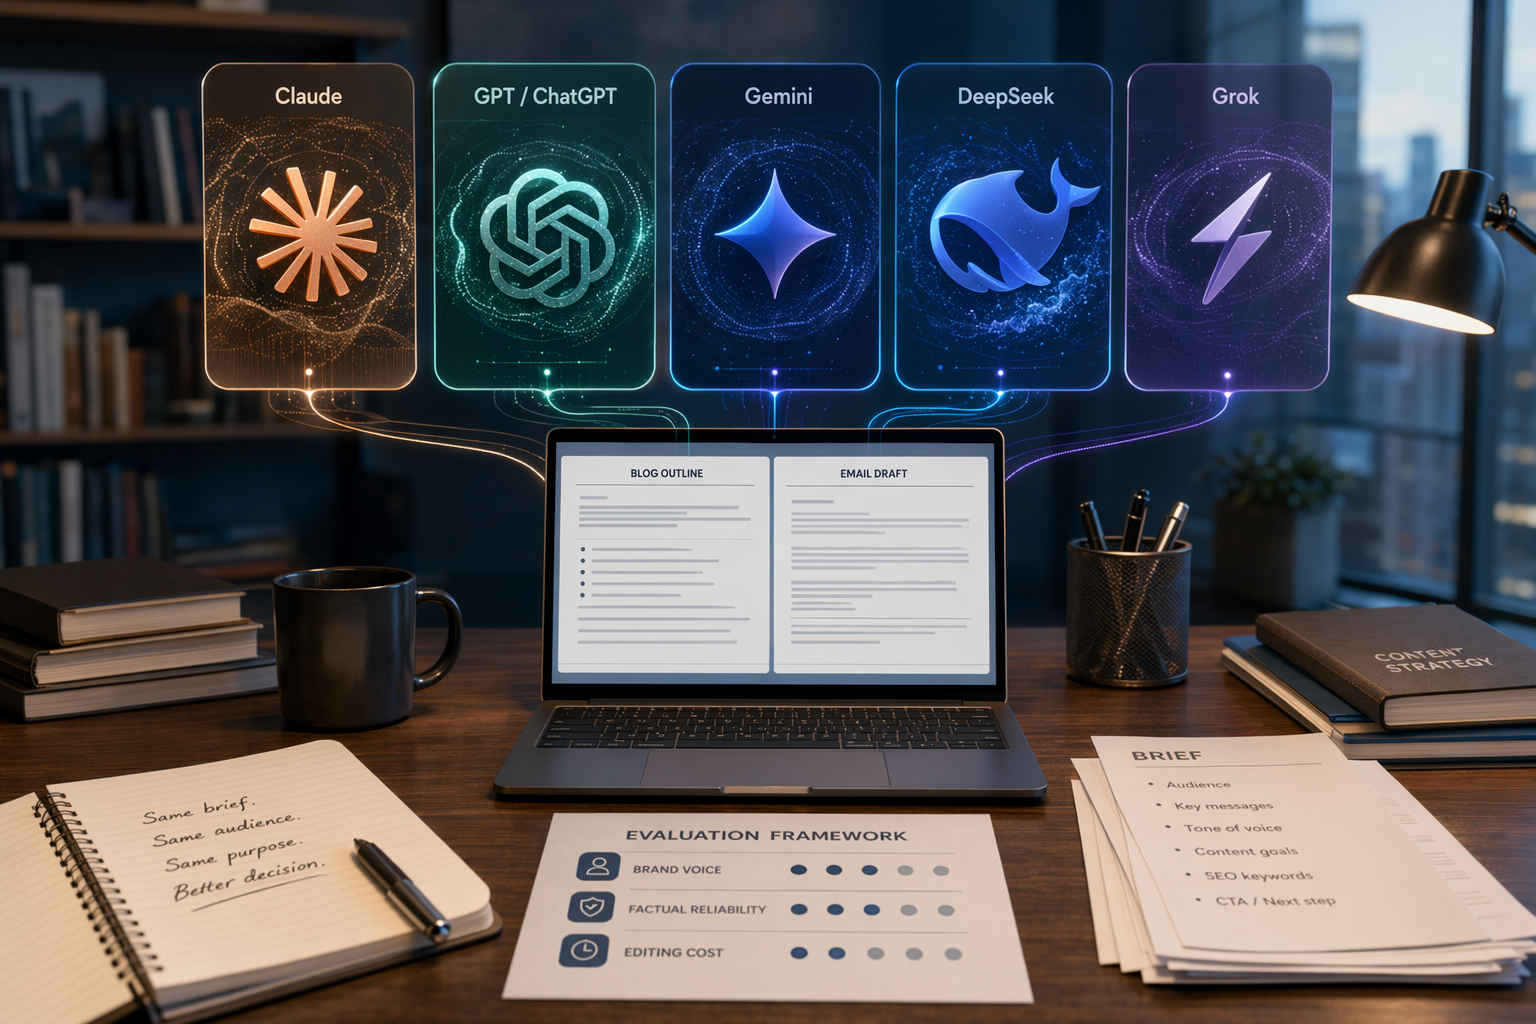
2026 年没有一个单一权威榜单能直接决定“营销写作 AI 前五名”;更实用的做法,是把 Claude、GPT/ChatGPT、Gemini、DeepSeek、Grok 作为优先测试名单。 Claude 适合长文和品牌语气打磨,GPT/ChatGPT 适合全流程营销内容,Gemini 适合长资料和多模态输入,DeepSeek、Grok 则更适合成本、速度或实时社交语境测试。 团队选型不能只看底层模型,还要评估品牌语气设置、内容模板、SEO、审稿流程,以及与 CMS、邮件平台等工具的衔接。 2026 行銷寫作 AI 模型前五名:部落格與 Email 先測這 5 個 行銷寫作模型不該只看通用排行榜;用同一份 brief 實測,才能看出哪個模型最省編修時間。 AI 提示 Create a landscape editorial hero image for this Studio Global article: 2026 行銷寫作 AI 模型前五名:部落格與 Email 先測這 5 個. Article summary: 2026 年沒有單一官方榜單能決定行銷寫作 AI 前五名;最實用的縮小範圍,是先測 Claude、GPT/ChatGPT、Gemini、DeepSeek、Grok,並用同一份 brief 比較品牌語氣、事實可靠度與編修成本。. Topic tags: ai, content marketing, email marketing, seo, copywriting. Reference image context from search candidates: Reference image 1: visual subject "《時代》雜誌公布2026年十大最具影響力人工智能公司榜單,字節跳動、智譜(02513.HK) -34.000 (-3.553%)) 沽空 $9.12千萬; 比率 6.295%) 及阿里-W(09988.HK) -0.700 (-0.532%)) 沽空 $15.97億; 比率 17.830%) 入選。. 《時代》雜誌指出,字節跳動旗下AI助理「豆包」已累積超過" source context "《時代》雜誌公布2026年十大最具影響力AI公司榜單字節跳動" Reference image 2: visual subject "《時代》雜誌公布2026年十大最具影響力人工智能公司榜單,字節跳動、智譜(02513.HK) -34.000 (-3.553%)) 沽空 $9.12千萬; 比率 6.295%) 及阿里-W(09988.HK) -0.700 (-0.532%)) 沽空 $15.97億; 比率 17.830%) 入選。. 《時代》雜誌指出,字節跳動旗下AI助理「豆包」已累積超過" source context "《時代》雜誌公布2026年十大最具影響力AI公司榜單字節跳動" Style: pre
openai.com 人们还问 “2026 营销写作 AI 模型怎么选:Claude、GPT、Gemini、DeepSeek、Grok 对比”的简短答案是什么? 2026 年没有一个单一权威榜单能直接决定“营销写作 AI 前五名”;更实用的做法,是把 Claude、GPT/ChatGPT、Gemini、DeepSeek、Grok 作为优先测试名单。
首先要验证的关键点是什么? 2026 年没有一个单一权威榜单能直接决定“营销写作 AI 前五名”;更实用的做法,是把 Claude、GPT/ChatGPT、Gemini、DeepSeek、Grok 作为优先测试名单。 Claude 适合长文和品牌语气打磨,GPT/ChatGPT 适合全流程营销内容,Gemini 适合长资料和多模态输入,DeepSeek、Grok 则更适合成本、速度或实时社交语境测试。
接下来在实践中我应该做什么? 团队选型不能只看底层模型,还要评估品牌语气设置、内容模板、SEO、审稿流程,以及与 CMS、邮件平台等工具的衔接。
先看结论:5 个模型各适合什么营销任务 优先试用顺序 模型家族 适合先测的任务 为什么值得测 1 Claude 长篇博客、专业型邮件、品牌语气改写、深度编辑 公开比较把 Claude/Claude Opus 4.5 与 professional writing、prose quality 联系在一起;如果你重视文字质感和可编辑性,它很适合作为第一轮测试对象。 2 GPT/ChatGPT 营销简报、大纲、初稿、邮件标题、行动号召、广告文案 GPT 在比较中被描述为 balanced professional work 或 all-around ecosystem,适合作为营销团队的通用基准模型。 3 Gemini 长文档摘要、多素材输入、演示文稿转文章、多模态内容策划 Gemini 常被放在 long context、multimodal workflows、cost efficiency,以及 real-time and multimodal tasks 的语境下比较,适合先消化大量材料再产出内容的流程。 4 DeepSeek 大量标题变体、研究型初稿、资料整理、成本敏感实验 DeepSeek 出现在营销模型同场评估中;另一份比较也把 DeepSeek V3 放在 value for developers 的语境下讨论,可作为批量和效率导向的候选。 5 Grok 社交话题发想、实时趋势语境、速度优先的草稿 GrokAI 出现在营销模型评估名单中;另有比较把 Grok 与 speed、real-time X data 联系在一起,适合需要即时社交语境的内容流程。
这个顺序不是说 Claude 永远第一、Grok 永远第五,而是给内容团队一个更省时间的起跑线:先测最可能影响成稿质量的模型,再把成本、速度、实时性和特殊工作流纳入比较。
为什么不能只看“排行榜第一名” 营销内容不是一个单一 benchmark 就能评完的任务。博客文章要兼顾搜索意图、结构和可读性;邮件要看标题、开头吸引力和行动号召(CTA);落地页要看卖点排序和转化逻辑;品牌内容还要保持语气一致,并避免事实错误。
5 个模型怎么选
1. Claude:优先测试长文质量和品牌语气 如果你的内容偏长、偏专业,或者需要细腻语气,例如 B2B 博客、白皮书、创始人信、客户教育邮件或高客单价产品文案,Claude 值得排在第一轮。公开资料把 Claude Opus 4.5 与 professional writing 联系起来;另一份比较也用 Claude for code and prose quality 来概括它的优势。
测试时,不要只让 Claude 写一版初稿。更值得看的,是它的编辑能力:能不能把一篇普通初稿改得更像你的品牌,能不能把冗长段落改清楚,能不能把邮件语气调整得更专业、更温和,或者更有说服力。这类任务最能体现它是否真正节省人工润色时间。
2. GPT/ChatGPT:作为全能型营销基准 GPT/ChatGPT 适合做第一轮“全流程内容工作台”:从 campaign idea、受众洞察、文章大纲、邮件标题,到广告变体和 CTA,都可以放在同一套测试里跑。公开比较把 GPT 放在 balanced professional work 与 all-around ecosystem 的语境下,说明它适合作为营销团队的通用对照组。
如果你刚开始搭建 AI 内容流程,可以先用 GPT/ChatGPT 跑完整流程,再用其他模型挑战它在长文质感、品牌语气、成本或实时性上的短板。
3. Gemini:适合长资料、多素材和多模态流程 Gemini 的重点不只是“会不会写”,而是能不能先处理大量素材再写。公开比较反复把 Gemini 与 context、multimodal workflows、cost efficiency 放在一起讨论;另一份比较也把 Gemini 2.0 Ultra 放在 real-time and multimodal tasks 的语境下。
如果你的内容生产经常要处理演示文稿、会议逐字稿、研究文档、产品资料、图片或多份材料整合,Gemini 很值得测试。典型任务包括:把 PPT 改写成博客,把多份资料整理成邮件序列,或把研究摘要改写成社交媒体内容。
4. DeepSeek:放进成本、批量和研究型初稿测试 DeepSeek 不一定要直接作为品牌最终文案的首选,但很适合进入大量实验环节。营销模型评测把 DeepSeek 与 ChatGPT、Gemini、Claude、GrokAI 同场比较;另一份模型比较则把 DeepSeek V3 放在 value for developers 的位置。
对内容团队来说,DeepSeek 可以先用于大量标题变体、竞品资料整理、FAQ 草稿、研究型初稿或初步分类。若内容最终要发布,仍建议由人工编辑,或再交给更擅长品牌语气的模型做最后收敛。
5. Grok:适合实时社交语境和 X 话题 Grok 不是每个内容团队都必须优先测试的模型;但如果你的品牌高度依赖社交趋势、热点语境、X 平台讨论或即时话题,它值得列入测试名单。公开营销比较把 GrokAI 放进候选名单;另一份模型比较则把 Grok 与 speed、real-time X data 联系在一起。
Grok 适合测试社交帖角度、趋势解读、实时回应草稿和短文变体。不过,越依赖实时信息,越需要人工核查关键事实和品牌风险。
模型不等于完整内容系统 很多营销团队需要的不是单个底层模型,而是一套能落地的内容生产流程。内容工具资料指出,Jasper、AI Writer、Writesonic 等工具常建立在 ChatGPT、Claude、Gemini 这些大型语言模型之上,再叠加品牌语气设置、内容模板、SEO 集成等功能。
这点很关键:个人创作者可能直接使用模型就够;团队如果要稳定产出可发布内容,就要同时评估工具层能力。AI 写作工具的常见营销场景包括 landing page headlines、email sequences、social posts、ad variations 等内容工作。
能不能保存品牌语气、禁用词和常用产品表述?
有没有博客、邮件、社交媒体、广告、落地页模板?
是否支持 SEO 规划、关键词和内容 brief?
多人审稿、版本管理和权限设置是否方便?
能不能接入现有 CMS、邮件平台或营销自动化工具?
底层模型决定文字能力的上限,工具层决定团队能不能稳定复制好结果。
最实用的测试方法:同一份 brief,5 个模型一起跑 比较模型时,不要只输入一句“帮我写一篇博客”。更好的做法是准备同一份营销 brief,让 Claude、GPT/ChatGPT、Gemini、DeepSeek、Grok 跑同一组任务,再用一致标准评分。
产品或服务介绍
目标受众与购买场景
内容格式:博客、邮件、社交帖、落地页或广告
品牌语气:专业、温暖、直接、幽默或高端
必须包含的卖点、资料来源和禁用说法
CTA 与转化目标
字数、语言、地区和合规要求
一份内容大纲
一版完整初稿
三个标题或邮件主题
三个 CTA 版本
一版更符合品牌语气的改写
一段对自身输出的风险检查和待核事实清单
评分项 重点看什么 品牌语气 是否像你的品牌,而不是像通用 AI 文案 可读性 是否清楚、自然、有节奏 搜索意图 博客是否回答了读者真正想知道的问题 邮件转化力 标题、开头、CTA 是否指向明确行动 事实可靠度 是否出现错误、夸大或需要大量人工校正的说法 修改成本 从初稿到可发布需要花多少时间 工作流整合 是否适合你的 SEO、邮件、CMS 或审稿流程
测完后,你要找的不是“最会说漂亮话”的模型,而是最能稳定产出、稍作修改就能发布的模型。
最后建议 如果你只想快速开始,建议试用顺序是:Claude → GPT/ChatGPT → Gemini → DeepSeek → Grok 。
但真正的答案不会只存在于排行榜。对营销内容来说,最好的 AI 模型,是能在你的产品信息、品牌语气、目标受众和转化目标下,稳定降低修改成本、提高可发布质量的模型。
yourgpt.aiLLM Leaderboard 2026 | Compare GPT-5, Claude, Gemini & More
chapters-eg.comAI Models Ranking: Which AI Should You Use for Marketing in 2026
chatsmith.ioBest AI Models in 2026: Compare the Top 8 AI Tools Head- ...
appscribed.comBest AI Models 2026: Claude Vs GPT Vs Gemini Compared | Appscribed
whatllm.orgBest AI Model January 2026 | Top 3 LLMs Ranked (Expert Picks)