报告已发布18 来源
内容营销 AI 模型怎么选:OpenAI、Claude、DeepSeek、Gemini、Grok 实务分工
公开资料可以比较 API 价格、上下文窗口、提示词缓存和服务端工具,但不足以证明某个模型一定带来更高 SEO 排名、广告转化率或品牌一致性。 更实用的分工是:OpenAI 做通用 baseline,Claude 测长文与品牌编辑,DeepSeek 跑低成本批量,Gemini 处理长上下文,Grok 评估工具化 pipeline。
发布者使用 GPT-5.5 编辑图片由 GPT Image 2 生成
研究答案
要点
- 公开资料可以比较 API 价格、上下文窗口、提示词缓存和服务端工具,但不足以证明某个模型一定带来更高 SEO 排名、广告转化率或品牌一致性。
- 更实用的分工是:OpenAI 做通用 baseline,Claude 测长文与品牌编辑,DeepSeek 跑低成本批量,Gemini 处理长上下文,Grok 评估工具化 pipeline。
- 选型时要把 input tokens 与 output tokens 分开算,并实测可发布比例、人工修改时间、品牌一致性、事实错误率、格式稳定性和单次任务成本。
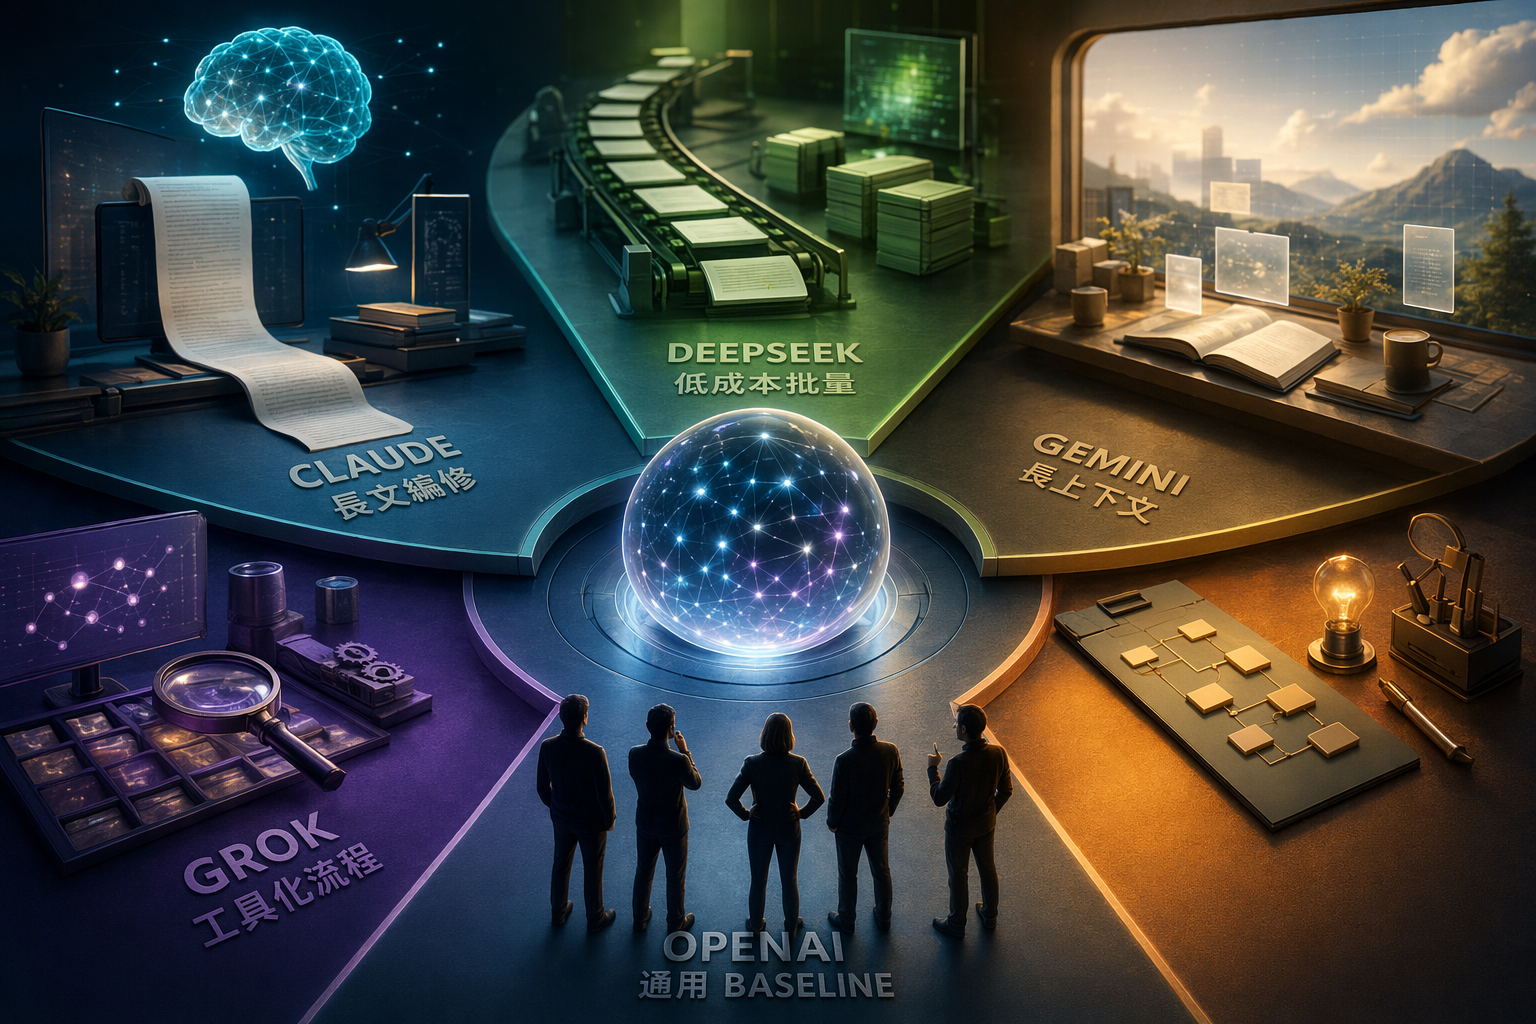
AI 提示
openai.comCreate a landscape editorial hero image for this Studio Global article: OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南. Article summary: 截至 2026 年可引用的公開資料,沒有證據支持五者中有單一內容行銷冠軍;更務實的分工是 OpenAI 當通用 baseline、Claude 測長文編修、DeepSeek 跑低成本批量、Gemini 處理長上下文、Grok 評估工具化流程。最後仍要用自家 KPI 實測。. Topic tags: ai, content marketing, seo, openai, claude. Reference image context from search candidates: Reference image 1: visual subject "# 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂. 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 全解析,付費、應用與安全性一次看懂"). 近幾年有多款大型語言模型 (LLM) 接連問世,對一般用戶來說,到底哪一款最適合日常需求。本次整理 5 款主流 LLM,分別為 GPT‑" source context "2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 | 鏈新聞 ABMedia" Reference image 2: visual subject "## Loading. ## Loading. # 生命不息,折腾不止. ## 要有最朴素的生活,与最遥远的梦想。即使明日天寒地冻、路远马亡。. # 【译】Grok 3 vs ChatGPT vs DeepSeek vs Claude vs Gemini:2025年2月哪款AI最好?. 人工智能(AI)的进步速度前所未有,几乎每周都有新的模型和技术问世。20" source c
内容创作与营销团队选 AI 模型时,最容易被排行榜带偏。公开资料能帮助你比较 API pricing、context window、prompt caching 和 server-side tools,但这些信息本身不足以证明哪家模型一定能带来更高 SEO 排名、广告转化率或品牌一致性。
Studio Global AI
继续你的研究
此页面包含一个有来源支持的答案,您可以在 Studio Global 内继续。
人们还问
“内容营销 AI 模型怎么选:OpenAI、Claude、DeepSeek、Gemini、Grok 实务分工”的简短答案是什么?
公开资料可以比较 API 价格、上下文窗口、提示词缓存和服务端工具,但不足以证明某个模型一定带来更高 SEO 排名、广告转化率或品牌一致性。
首先要验证的关键点是什么?
公开资料可以比较 API 价格、上下文窗口、提示词缓存和服务端工具,但不足以证明某个模型一定带来更高 SEO 排名、广告转化率或品牌一致性。 更实用的分工是:OpenAI 做通用 baseline,Claude 测长文与品牌编辑,DeepSeek 跑低成本批量,Gemini 处理长上下文,Grok 评估工具化 pipeline。
接下来在实践中我应该做什么?
选型时要把 input tokens 与 output tokens 分开算,并实测可发布比例、人工修改时间、品牌一致性、事实错误率、格式稳定性和单次任务成本。
来源
platform.claude.comPricing - Claude API Docs
pecollective.comCross-Provider LLM API Pricing Comparison (April 2026)
tldl.ioLLM API Pricing 2026 — Compare GPT-5, Claude 4, Gemini 2.5 ...
docs.x.aiModels and Pricing - xAI Docs
aipricingcomparison.comCompare OpenAI & Top LLM API Pricing Instantly - AI Pricing Comparison