Posts de IA em alta e atualização rápida de pesquisa - Página 1726
Como testar o GPT-5.5 de graça no ChatGPT — sem cair em link errado
12 fontes0O caminho legítimo é pelo ChatGPT: entre ou crie uma conta gratuita, abra uma nova conversa e selecione GPT 5.5 se ele aparecer nas opções do modelo.
Claude Opus 4.7 vs GPT-5.5: como escolher para agentes, código e empresas
21 fontes0Para compras de API, agentes com contexto longo e implantação corporativa, Claude Opus 4.7 é mais fácil de avaliar agora: há janela de contexto de 1 milhão de tokens, sem sobretaxa de contexto longo na API p...
Claude Opus 4.7 vs. GPT-5.5: como ler os benchmarks e escolher na prática
11 fontes0Não há base pública suficiente para declarar um vencedor absoluto: o Claude Opus 4.7 lidera o GDPval AA com 1.753 Elo, enquanto o GPT 5.5 aparece com resultados claros no Intelligence Index em versões high,...
Claude Opus 4.7 vs GPT-5.5: qual IA usar para código, agentes, pesquisa e design
17 fontes0Claude Opus 4.7 é o primeiro teste mais bem sustentado para programação e agentes com muitas ferramentas: a Vellum informa 87,6% no SWE bench Verified e 77,3% no MCP Atlas [3].
Claude Opus 4.7 vs GPT-5.5: o que avaliar antes de levar para a empresa
25 fontes0Claude Opus 4.7 é o ponto de partida mais claro para PoCs via API: a Anthropic já informa disponibilidade no Claude API, Amazon Bedrock, Google Cloud Vertex AI e Microsoft Foundry, além de preço de US$ 5/US$...
Claude Opus 4.7 vs GPT-5.5 Spud: ainda não há vencedor confiável
24 fontes0Não dá para apontar um vencedor: o Claude Opus 4.7 é verificado na documentação da Anthropic, enquanto o GPT 5.5 Spud não é confirmado aqui por fonte primária da OpenAI.
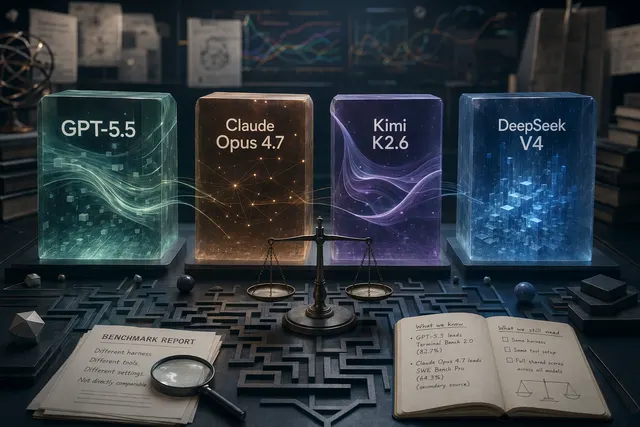
GPT-5.5, Claude Opus 4.7, Kimi K2.6 e DeepSeek V4-Pro: benchmarks e como escolher
23 fontes0Ainda não há base pública suficiente para cravar um campeão geral: GPT 5.5 aparece com 82,7% no Terminal Bench 2.0, enquanto Claude Opus 4.7 aparece com 64,3% no SWE Bench Pro, mas esse último número vem de...
Como testar o GPT-5.5 agora: o que funciona no ChatGPT, no Codex e na API
15 fontes0O jeito mais direto de tentar usar o GPT 5.5 agora é pelo ChatGPT ou pelo Codex.
GPT-5.5, Claude Opus 4.7, DeepSeek V4 e Kimi K2.6: quem vence em cada benchmark
24 fontes0Não há base suficiente para cravar um líder geral. GPT 5.5 aparece forte em Terminal Bench 2.0, com 82,7%, enquanto Claude Opus 4.7 lidera em SWE Bench Pro, com 64,3%, e SWE Bench Verified, com 87,6% [19][27...
Benchmarks do Claude Opus 4.7: o que significa 87,6% no SWE-bench Verified
12 fontes0A cifra principal do Claude Opus 4.7 é 87,6% no SWE bench Verified, reportada pela AWS a partir de dados da Anthropic; é um sinal forte para programação agêntica, não uma garantia de desempenho universal [7].
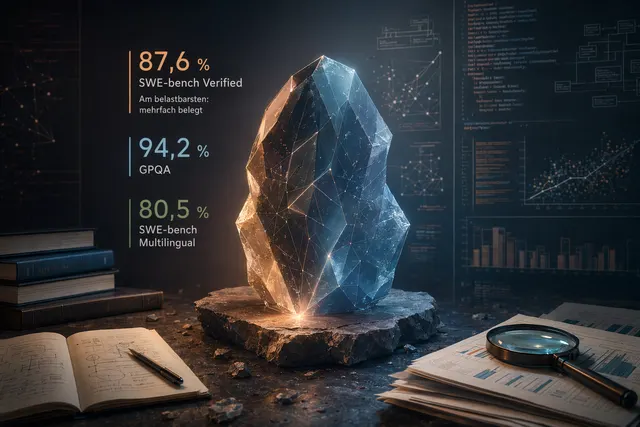
Claude Opus 4.7: benchmarks e grau de confiança dos números públicos
16 fontes0Os principais números públicos para Claude Opus 4.7 são 87,6% no SWE bench Verified, 94,2% no GPQA e 80,5% no SWE bench Multilingual.
Claude Mythos Preview: como ler os 93,9% no SWE-bench
17 fontes0O número mais citado para Claude Mythos Preview é 93,9% no SWE bench, um benchmark voltado a tarefas de software, especialmente útil para avaliar código e agentes de programação [1][2].