Claude Opus 4.7: os benchmarks mais citados — e o quanto dá para confiar neles
Os principais números públicos para Claude Opus 4.7 são 87,6% no SWE bench Verified, 94,2% no GPQA e 80,5% no SWE bench Multilingual. O SWE bench Verified é o dado mais bem sustentado nesta seleção de fontes, pois aparece de forma consistente em mais de uma referência.
Publicado porEditado com GPT-5.5Imagens geradas com GPT Image 2
Os principais números públicos para Claude Opus 4.7 são 87,6% no SWE bench Verified, 94,2% no GPQA e 80,5% no SWE bench Multilingual.
O SWE bench Verified é o dado mais bem sustentado nesta seleção de fontes, pois aparece de forma consistente em mais de uma referência.
Para decidir migração ou uso em produção, benchmarks devem ser combinados com testes reais de contexto, visão, uso de ferramentas, latência e consumo de tokens.
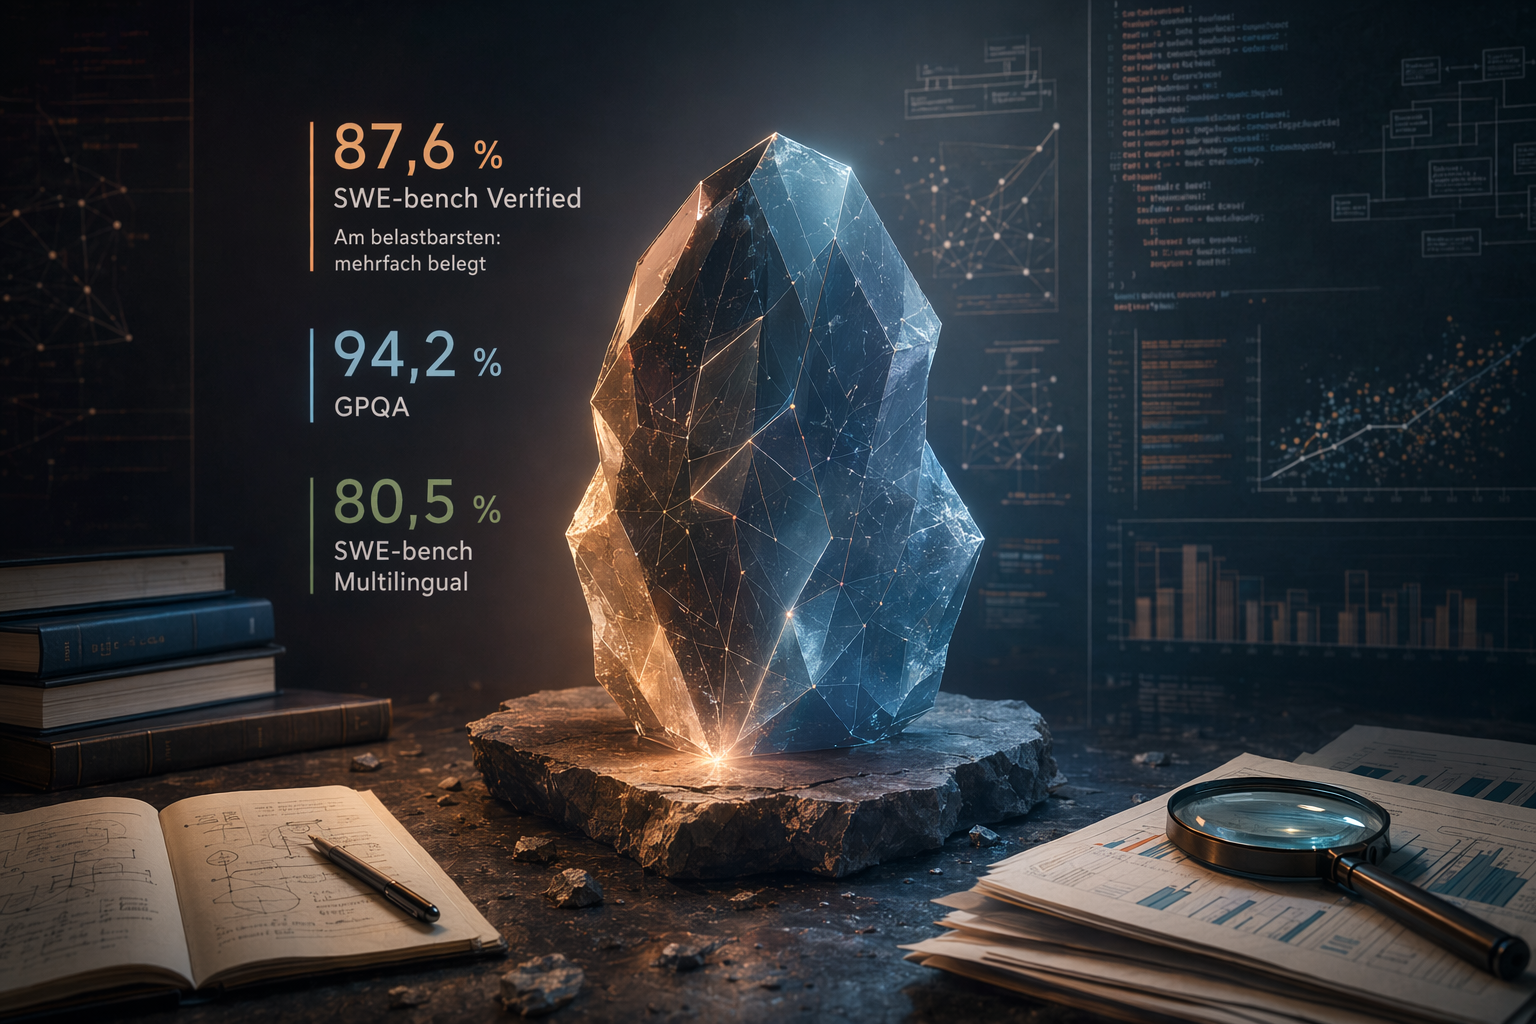
Claude Opus 4.7 Benchmarks: Die wichtigsten Werte und ihre BelastbarkeitAI-generierte Illustration zu den öffentlichen Benchmark-Werten von Claude Opus 4.7.
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 Benchmarks: Die wichtigsten Werte und ihre Belastbarkeit. Article summary: Claude Opus 4.7 wird öffentlich mit 87,6 % auf SWE bench Verified, 94,2 % auf GPQA und 80,5 % auf SWE bench Multilingual genannt; am belastbarsten ist der SWE bench Verified Wert, weil er mehrfach belegt ist.. Topic tags: ai, anthropic, claude, llm, benchmarks. Reference image context from search candidates: Reference image 1: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In short: Anthropic has released Claude Opus 4.7, its most capable generally available" source context "Claude Opus 4.7 leads on SWE-bench and agentic reasoning ..." Reference image 2: visual subject "# Anthropic releases Claude Opus 4.7 with benchmark-leading coding and agentic performance. *In sh
openai.com
Os benchmarks públicos mais fáceis de verificar para o Claude Opus 4.7 se concentram, hoje, em três números: 87,6% no SWE-bench Verified, 94,2% no GPQA e 80,5% no SWE-bench Multilingual. Entre eles, o dado mais sólido nesta base de fontes é o SWE-bench Verified, porque aparece explicitamente em mais de uma referência disponível.
Os principais números em uma tabela
Benchmark
Valor citado para Claude Opus 4.7
Como ler esse dado
SWE-bench Verified
Studio Global AI
Continue sua pesquisa
Esta página inclui uma resposta baseada na fonte que você pode continuar em Studio Global.
Qual é a resposta curta para "Claude Opus 4.7: os benchmarks mais citados — e o quanto dá para confiar neles"?
Os principais números públicos para Claude Opus 4.7 são 87,6% no SWE bench Verified, 94,2% no GPQA e 80,5% no SWE bench Multilingual.
Quais são os pontos-chave para validar primeiro?
Os principais números públicos para Claude Opus 4.7 são 87,6% no SWE bench Verified, 94,2% no GPQA e 80,5% no SWE bench Multilingual. O SWE bench Verified é o dado mais bem sustentado nesta seleção de fontes, pois aparece de forma consistente em mais de uma referência.
O que devo fazer a seguir na prática?
Para decidir migração ou uso em produção, benchmarks devem ser combinados com testes reais de contexto, visão, uso de ferramentas, latência e consumo de tokens.
É o principal ponto de referência público para programação nesta seleção de fontes; o mesmo valor aparece em mais de uma fonte.
GPQA
94,2%
O valor aparece claramente no LLM-Stats, mas não está visível como tabela de benchmark no recorte disponível da página oficial da Anthropic.
SWE-bench Multilingual
80,5%
Um resultado adicional cita esse número e o compara a 77,8% no Opus 4.6; por aparecer em menos fontes, merece leitura mais cautelosa.
Essa é uma leitura conservadora. A tabela acima usa apenas valores que aparecem explicitamente nas fontes fornecidas. Para contratação, migração ou escolha de modelo em produção, esses números ajudam a montar uma lista inicial — mas não substituem uma avaliação no seu próprio repositório, com suas ferramentas e seus critérios de aceite.
Por que o SWE-bench Verified é o dado mais forte
O resultado de 87,6% no SWE-bench Verified é o benchmark mais bem ancorado para o Claude Opus 4.7 neste conjunto de fontes. Ele aparece tanto em um artigo de benchmark e migração quanto no LLM-Stats.
O LLM-Stats também apresenta esse resultado como uma alta de 6,8 pontos percentuais em relação ao Opus 4.6. Já a ALM Corp posiciona o Opus 4.7 como um modelo com desempenho mais forte em tarefas difíceis de programação e em workflows de agentes.
Para times de engenharia, a leitura prática é simples: o SWE-bench Verified é o melhor ponto de partida público para comparar o Claude Opus 4.7 em tarefas de código. Ainda assim, ele deve ser o começo da análise, não o fim. O que realmente importa é como o modelo se comporta no código real da equipe, com a stack usada no dia a dia, limites de custo, integração com ferramentas e padrões internos de revisão.
GPQA: sinal relevante, mas menos confirmado aqui
O valor de 94,2% no GPQA aparece de forma clara no LLM-Stats. A página oficial da Anthropic é uma fonte primária importante, mas o trecho disponível neste contexto confirma principalmente que desenvolvedores podem usar claude-opus-4-7 pela Claude API; nesse recorte, não há uma tabela de benchmarks totalmente citável com o número do GPQA.
Por isso, o GPQA deve ser lido como um sinal relevante, especialmente para raciocínio geral, mas com um pouco mais de cautela do que o SWE-bench Verified. Se esse número for decisivo para uma compra, migração ou comparação com outros modelos, vale confrontá-lo com material primário completo ou com testes próprios.
SWE-bench Multilingual: útil para bases de código multilíngues
O SWE-bench Multilingual de 80,5% chama atenção para equipes que lidam com bases de código, documentação ou ambientes de desenvolvimento em mais de um idioma. Um resultado disponível cita esse número e o compara a 77,8% para o Opus 4.6.
A ressalva é importante: esse dado não aparece com a mesma força do SWE-bench Verified nas fontes analisadas. Ele é um bom indício para cenários internacionais ou stacks com mistura de idiomas, mas não deve ser tratado como prova definitiva de desempenho em todos os contextos multilíngues.
O que os benchmarks deixam de fora
O Claude Opus 4.7 não está sendo posicionado apenas por pontuações. A VentureBeat descreveu o lançamento como o modelo de linguagem grande mais poderoso já disponibilizado publicamente pela Anthropic. A ALM Corp, por sua vez, enquadra o Opus 4.7 como um modelo Opus geralmente disponível para programação avançada, tarefas longas com agentes, raciocínio sobre documentos, visão de alta resolução e workflows profissionais.
Na prática, alguns recursos podem pesar tanto quanto um benchmark isolado:
Janela de contexto: o LLM-Stats cita uma janela de 1 milhão de tokens.
Visão: o LLM-Stats cita processamento visual com 3,3 vezes mais resolução.
Nível de esforço: LLM-Stats e ALM Corp mencionam um novo nível xhigh.
Tokenizador: a ALM Corp destaca um tokenizador atualizado, que pode aumentar a contagem de tokens para a mesma entrada.
Esses pontos podem afetar custo, latência e qualidade percebida. Em especial, mudanças no tokenizador merecem teste antes de uma migração, porque podem alterar previsões de consumo e orçamento.
Como usar esses números na decisão
Para programação: comece pelo SWE-bench Verified. O resultado de 87,6% é o número público mais bem sustentado nesta base de fontes.
Para workflows com agentes: além do SWE-bench, considere a posição do modelo em tarefas difíceis de programação e agentes, bem como o novo nível de esforço xhigh.
Para raciocínio geral: o GPQA é relevante, mas o valor de 94,2% aparece menos amplamente confirmado aqui do que o SWE-bench Verified.
Para bases multilíngues: o SWE-bench Multilingual de 80,5% é um indicador útil, mas deve ser validado com testes próprios por ter apoio mais estreito nas fontes disponíveis.
Para produção: teste contexto longo, uso de ferramentas, casos com imagem, consumo de tokens, latência e estabilidade sob carga real. As mudanças em janela de contexto, visão, nível de esforço e tokenizador podem mudar bastante a experiência prática.
Conclusão
A leitura mais segura é: o Claude Opus 4.7 aparece publicamente com 87,6% no SWE-bench Verified, 94,2% no GPQA e 80,5% no SWE-bench Multilingual. O SWE-bench Verified é o dado mais forte nesta seleção, porque é citado de forma consistente em mais de uma fonte.
GPQA e SWE-bench Multilingual acrescentam sinais importantes, mas exigem mais cautela. Para decisões sérias de modelo, os benchmarks devem servir como filtro inicial — não como substituto de uma avaliação com tarefas reais, orçamento real e critérios técnicos próprios.
rabinarayanpatra.comClaude Opus 4.7: Benchmarks, Breaking Changes, Migration Guide | Rabinarayan Patra
llm-stats.comClaude Opus 4.7: Benchmarks, Pricing, Context & What's New
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
binance.comAnthropic Launches Claude Opus 4.7 With Higher ...
almcorp.comClaude Opus 4.7: Pricing, Benchmarks & Context Window - ALM Corp