Posts de IA em alta e atualização rápida de pesquisa - Página 1725
Aprender fazia o útero encolher? O que as fontes realmente mostram
4 fontes0As fontes disponíveis não comprovam a existência de um livro didático de medicina que ensinasse que ler, estudar ou se instruir faria o útero encolher.
GPT-5.5 vs Claude Opus 4.7: qual modelo escolher para programar?
18 fontes0Não há vencedor absoluto: GPT 5.5 aparece melhor no Terminal Bench 2.0, enquanto Claude Opus 4.7 lidera no SWE Bench Pro nas fontes citadas.[6][36]
GPT-5.5 vs Claude Opus 4.7 para programação: Claude em patches, GPT no terminal
19 fontes0Para corrigir código em repositórios, resolver bugs e fazer testes passarem, o Claude Opus 4.7 é o primeiro candidato a avaliar: no SWE bench Pro, ele aparece com 64,3%, contra 58,6% do GPT 5.5.[16][29]
Como usar o DeepSeek: web, app e API sem confusão
23 fontes0Para experimentar sem programar, use o Start Now no site oficial ou instale o app por canais oficiais; a página do DeepSeek também leva à API.[24][23]
GPT-5.5, Claude Opus 4.7, DeepSeek V4 e Kimi K2.6: qual modelo usar?
24 fontes0Não há um ranking definitivo e perfeitamente comparável: os benchmarks variam por configuração de raciocínio, metodologia, data e fonte dos números.
GPT-5.5 é tão forte assim? O que os benchmarks públicos mostram
16 fontes0O GPT 5.5 aparece como um dos modelos de ponta mais fortes em benchmarks práticos, com 82,7 no Terminal Bench 2.0 e 84,9 no GDPval.[6][10]
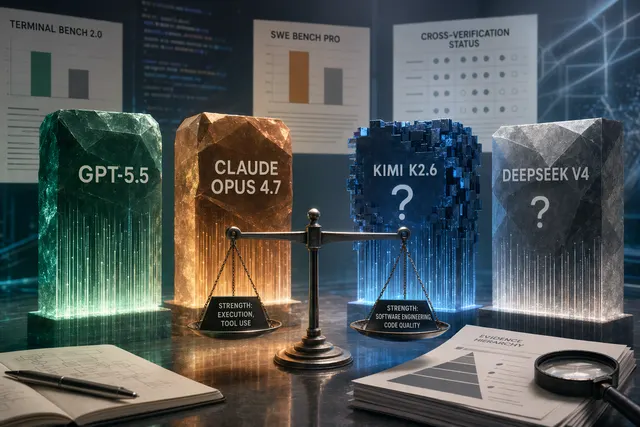
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4: benchmarks e nível de evidência
16 fontes0Não há base suficiente para declarar um “campeão geral” entre os quatro modelos: na tabela comparável da OpenAI, Claude Opus 4.7 faz 64,3% no SWE Bench Pro contra 58,6% do GPT 5.5, enquanto o GPT 5.5 faz 82,...
Kimi K2.6 em análise: muito forte em código, ainda incerto como IA para tudo
12 fontes0O sinal mais forte do Kimi K2.6 está em programação: MLQ.ai reporta 58,6 no SWE Bench Pro e 65,8% pass@1 no SWE bench Verified, mas uma análise observa que avaliações independentes ainda são preliminares [8]...
Kimi K2.6 vs. GPT-5.5, Gemini e Claude: o veredito para devs
23 fontes0Para agentes de código em alto volume, o Kimi K2.6 é um primeiro teste forte: o OpenRouter lista 262.144 tokens de contexto e US$ 0,75/US$ 3,50 por 1 milhão de tokens de entrada/saída [26].
GPT-5.5 vs Claude Opus 4.7: qual escolher para trabalho, código e agentes
21 fontes0Se a prioridade é partir de um briefing curto e avançar por pesquisa, código, análise e documentação, GPT 5.5 tende a ser a opção mais natural; se o fluxo exige contexto muito longo e agentes com várias etap...
DeepSeek V4 em teste: perto da fronteira, mas ainda sem prova de “melhor do mundo”
18 fontes0A documentação da API da DeepSeek lista o DeepSeek V4 Preview Release em 24 de abril de 2026, confirmando que o modelo entrou em fase de preview; isso não prova, por si só, que ele já seja o melhor modelo do...
GPT-5.5 na Espanha: como conferir se sua conta já tem acesso
18 fontes0As fontes disponíveis não mostram um bloqueio específico do GPT 5.5 para a Espanha; a disponibilidade parece depender mais de conta, plano, organização ou canal.