studioglobal
Discover

Descubra respostas, relatórios, códigos e fluxos de trabalho com IA - Página 1729

Descubra
TodosRespostasRelatóriosCódigoFluxos de trabalhoGaleriaEm alta
  • Split-screen editorial illustration comparing Claude Opus 4.7 and GPT-5.5 for coding, agents, research and design

    Claude Opus 4.7 vs GPT-5.5: qual IA usar para código, agentes, pesquisa e design

    há 7 meses17 fontes
  • Claude Opus 4.7 與 GPT-5.5 企業部署比較的抽象 AI 圖像

    Claude Opus 4.7 vs GPT-5.5: o que avaliar antes de levar para a empresa

    há 7 meses25 fontes
  • Editorial illustration of Claude Opus 4.7 and GPT-5.5 Spud benchmark claims being compared on scorecards

    Claude Opus 4.7 vs GPT-5.5 Spud: ainda não há vencedor confiável

    há 7 meses24 fontes
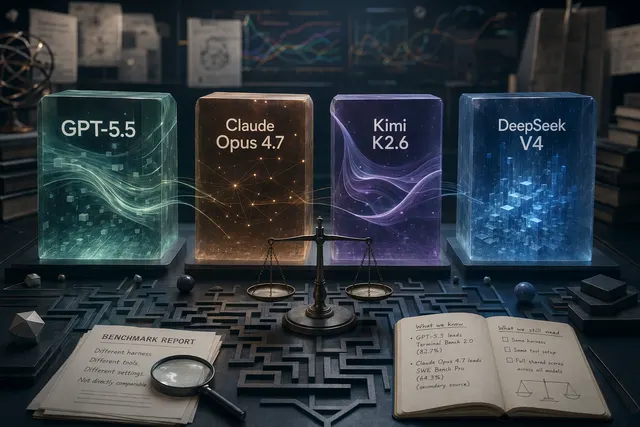
  • 四款 AI 模型的基準測試比較示意圖,包含 GPT-5.5、Claude Opus 4.7、Kimi K2.6 與 DeepSeek V4

    GPT-5.5, Claude Opus 4.7, Kimi K2.6 e DeepSeek V4-Pro: benchmarks e como escolher

    há 7 meses23 fontes
  • GPT-5.5の利用可否をChatGPT、Codex、APIで確認するイメージ

    Como testar o GPT-5.5 agora: o que funciona no ChatGPT, no Codex e na API

    há 7 meses15 fontes
  • 네 개의 AI 모델 벤치마크 점수를 비교하는 추상적인 대시보드 일러스트

    GPT-5.5, Claude Opus 4.7, DeepSeek V4 e Kimi K2.6: quem vence em cada benchmark

    há 7 meses24 fontes
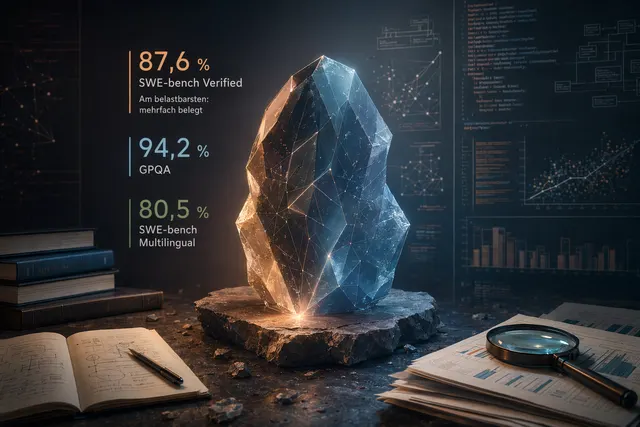
  • Ilustración editorial de benchmarks de Claude Opus 4.7 con gráficos de rendimiento y código

    Benchmarks do Claude Opus 4.7: o que significa 87,6% no SWE-bench Verified

    há 7 meses12 fontes
  • Abstrakte Visualisierung von Claude Opus 4.7 Benchmarks mit Diagrammen und Code-Elementen

    Claude Opus 4.7: benchmarks e grau de confiança dos números públicos

    há 7 meses16 fontes
  • Ilustración de un panel de benchmark de IA con código y métricas para Claude Mythos Preview

    Claude Mythos Preview: como ler os 93,9% no SWE-bench

    há 7 meses17 fontes
  • Abstrakte KI-Benchmark-Grafik zu Claude Mythos Preview mit Code- und Score-Elementen

    Claude Mythos: 93,9% no SWE-bench, mas o placar exige contexto

    há 7 meses17 fontes
  • Panel comparativo de modelos de IA generativa con Kimi K2.6, DeepSeek V4, GPT-5.5 y Claude Opus 4.7

    Kimi K2.6, DeepSeek V4, GPT-5.5 ou Claude Opus 4.7: qual LLM escolher?

    há 7 meses20 fontes
  • GPT-5.5 與 Claude Opus 4.7 基準測試比較的抽象 AI 對照圖

    GPT-5.5 vs Claude Opus 4.7: benchmarks, preço e quando usar cada modelo
    há 7 meses17 fontes
AnteriorPróximo