studioglobal
Discover

보고서 - 페이지: 10 | 발견하다
발견하다
모두답변보고서코드워크플로우갤러리트렌딩
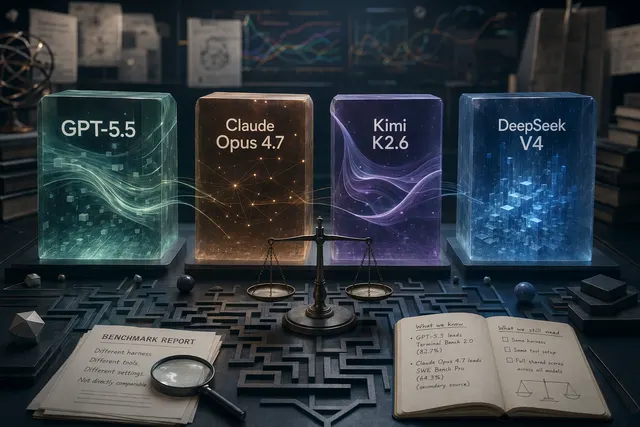
  • GPT-5.5、Claude Opus 4.7、DeepSeek V4、Kimi K2.6のベンチマーク比較を示す抽象的なAIダッシュボード

    GPT-5.5·Claude Opus 4.7·DeepSeek V4·Kimi K2.6 벤치마크 비교: 용도별 승자는 다르다

    6개월 전24 소스
  • 四個 AI 模型基準測試比較的抽象儀表板插圖

    GPT-5.5·Claude Opus 4.7·Kimi K2.6·DeepSeek V4 벤치마크: 승자보다 ‘같은 잣대’가 먼저다

    6개월 전16 소스
  • Claude Opus 4.7 與 GPT-5.5 在代理工作、編碼和長上下文場景中的比較示意圖

    Claude Opus 4.7 vs GPT-5.5: 긴 컨텍스트, 에이전트 코딩, 기업 배포 선택법

    6개월 전21 소스
  • Claude Opus 4.7 與 GPT-5.5 企業部署比較的抽象 AI 圖像

    Claude Opus 4.7 vs GPT-5.5: 기업 도입 전 API·비용·근거부터 보라

    6개월 전26 소스
  • Editorial illustration of Claude Opus 4.7 and GPT-5.5 Spud benchmark claims being compared on scorecards

    Claude Opus 4.7 vs GPT-5.5 Spud: 벤치마크 승자는 아직 없다

    6개월 전24 소스
  • 四款 AI 模型的基準測試比較示意圖,包含 GPT-5.5、Claude Opus 4.7、Kimi K2.6 與 DeepSeek V4

    GPT-5.5·Claude Opus 4.7·Kimi K2.6·DeepSeek V4-Pro 비교: 벤치마크와 선택 기준

    6개월 전23 소스
  • GPT-5.5 與 Claude Opus 4.7 基準測試比較的抽象 AI 對照圖

    GPT-5.5 vs Claude Opus 4.7: 벤치마크보다 중요한 업무 흐름

    6개월 전17 소스
  • GPT-5.5 與 DeepSeek V4 基準測試、coding、agent 任務與價格比較的抽象科技視覺

    GPT-5.5 vs DeepSeek V4: 코딩·에이전트 벤치마크와 가격 비교

    6개월 전19 소스
  • GPT-5.5 与 Claude Opus 4.7 在基准测试图表前对比的抽象插画

    GPT-5.5 vs Claude Opus 4.7: 코드 수정은 Claude, 터미널 에이전트는 GPT부터

    6개월 전17 소스
  • DeepSeek V4와 Kimi K2.6의 코딩, 콘텐츠, 번역 벤치마크를 비교하는 추상적 AI 그래픽

    DeepSeek V4 vs Kimi K2.6 벤치마크: 코딩은 DeepSeek, 콘텐츠·번역은 보류

    6개월 전18 소스
  • Сравнение четырёх AI-моделей GPT-5.5, Claude Opus 4.7, Kimi K2.6 и DeepSeek V4 на фоне графиков бенчмарков

    GPT-5.5·Claude Opus 4.7·Kimi K2.6·DeepSeek V4 벤치마크 비교

    6개월 전19 소스
  • GPT-5.5とClaude Opus 4.7をコーディング、デザイン、創作で比較するイメージ

    GPT-5.5 vs Claude Opus 4.7: 코딩·디자인·창작, 어디에 써야 할까

    6개월 전19 소스
이전다음