답변게시됨11 소스
Claude Opus 4.7 vs Opus 4.6: 차이점, 가격, 벤치마크와 업그레이드 판단
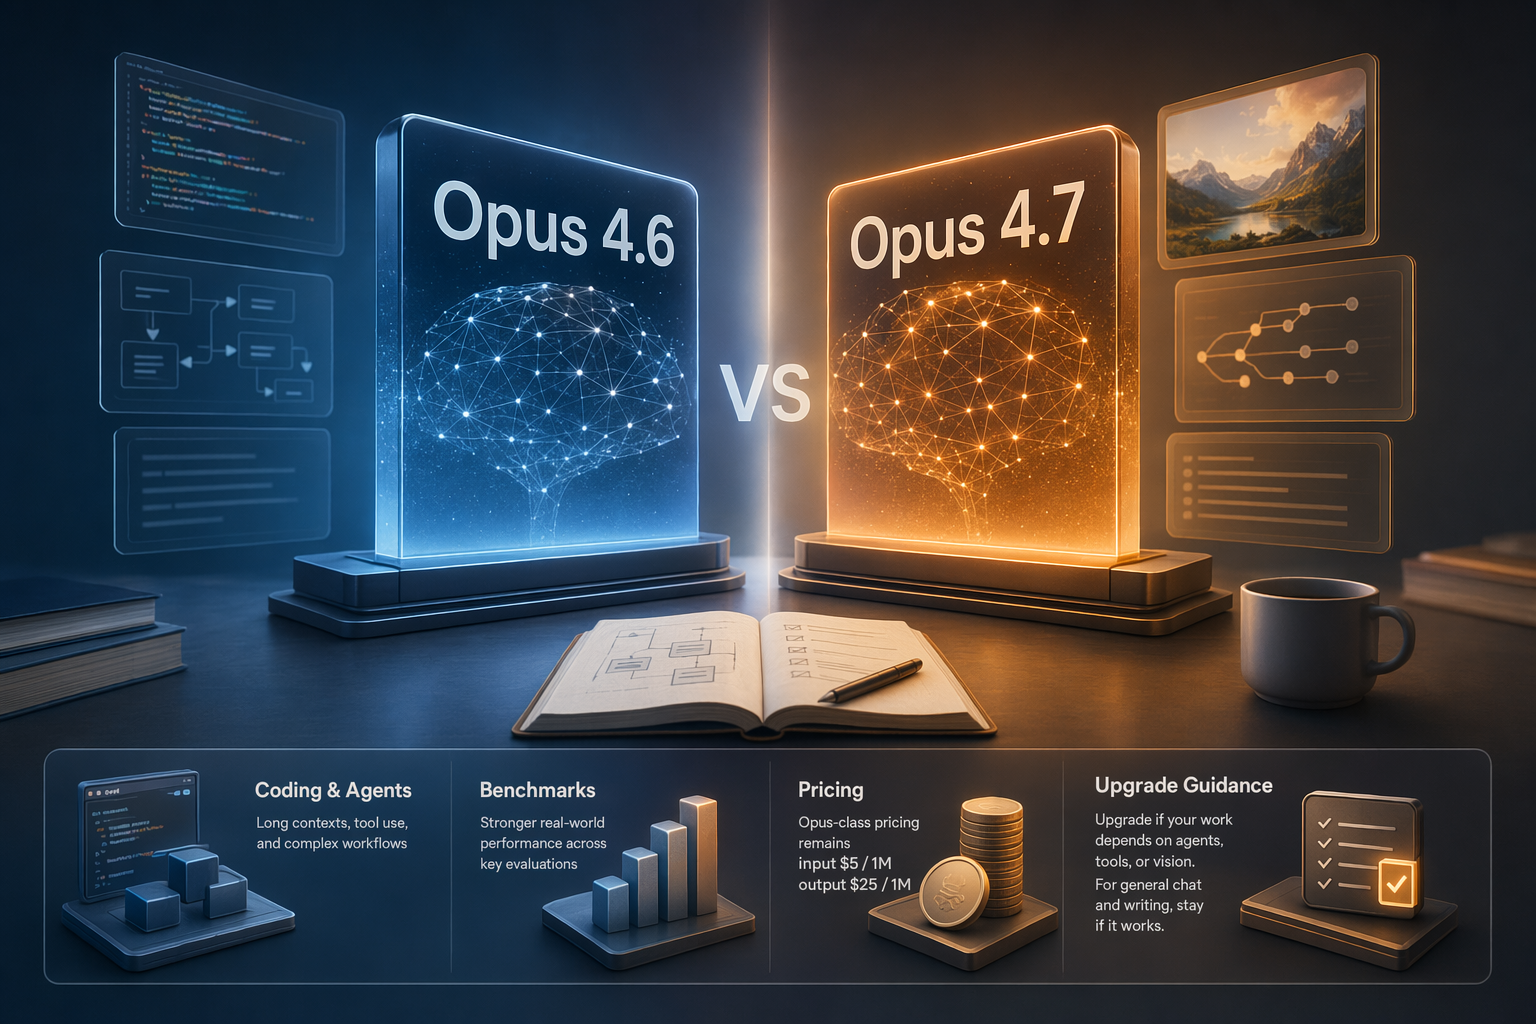
Claude Opus 4.7은 Opus 4.6의 같은 가격대 업그레이드로 정리된다. LLM Stats는 2026년 4월 16일 출시, 입력 100만 토큰당 5달러·출력 100만 토큰당 25달러의 동일 가격을 제시한다.[6][8] 개선 초점은 일반 대화보다 고난도 소프트웨어 엔지니어링, 장시간 에이전트 작업, 고해상도 이미지 이해에 있다.
게시자GPT-5.5로 편집GPT Image 2로 이미지 생성
연구 답변
주요 시사점
- Claude Opus 4.7은 Opus 4.6의 같은 가격대 업그레이드로 정리된다. LLM Stats는 2026년 4월 16일 출시, 입력 100만 토큰당 5달러·출력 100만 토큰당 25달러의 동일 가격을 제시한다.[6][8]
- 개선 초점은 일반 대화보다 고난도 소프트웨어 엔지니어링, 장시간 에이전트 작업, 고해상도 이미지 이해에 있다. Anthropic도 4.7을 claude opus 4 7 모델로 Claude API에서 사용할 수 있다고 안내한다.[8][9]
- 다만 주요 수치 상당수는 Anthropic의 self reported benchmark, 파트너 내부 사례 또는 proprietary benchmark에 기반한다는 점을 감안해야 한다.
AI 프롬프트
openai.comCreate a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議. Article summary: Claude Opus 4.7 在 2026 04 16 上線,公開資料顯示 Opus 級價格仍是每百萬 input $5、output $25;若你做 coding agent、長流程工具調用或視覺理解,值得優先試升,但一般聊天或文案不必只為版本號遷移。[6][8][9]. Topic tags: ai, anthropic, claude, llm, ai agents. Reference image context from search candidates: Reference image 1: visual subject "# Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade Now? A route-first upgrade guide that compares Claude Opus 4.7 and Claude Opus 4.6 through workflow fit, benchmark" source context "Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade ..." Reference image 2: visual subject "# Claude Opus 4.7 vs Opus 4.6. Head-to-head comparison of Claude Opus 4.7 vs Opus 4.6: benchmark deltas, pricing, effort levels, vision, tokenizer, and a migration checklist. Opus" source
결론부터 말하면, Claude Opus 4.7은 Opus 4.6 사용자를 위한 “무조건 교체”라기보다 “같은 Opus 가격대에서 코딩·에이전트·비전 작업을 더 밀어붙이는 업그레이드”에 가깝다. 이미 4.6으로 코드 수정, 저장소 분석, 멀티스텝 도구 호출, 이미지 이해를 많이 하고 있다면 4.7은 빠르게 A/B 테스트해볼 만하다. 반대로 일반 채팅, 요약, 번역, 문서 다듬기 정도가 주된 용도라면 공개 자료만으로는 즉시 전면 교체를 권하기 어렵다.
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
사람들은 또한 묻습니다.
"Claude Opus 4.7 vs Opus 4.6: 차이점, 가격, 벤치마크와 업그레이드 판단"에 대한 짧은 대답은 무엇입니까?
Claude Opus 4.7은 Opus 4.6의 같은 가격대 업그레이드로 정리된다. LLM Stats는 2026년 4월 16일 출시, 입력 100만 토큰당 5달러·출력 100만 토큰당 25달러의 동일 가격을 제시한다.[6][8]
먼저 검증할 핵심 포인트는 무엇인가요?
Claude Opus 4.7은 Opus 4.6의 같은 가격대 업그레이드로 정리된다. LLM Stats는 2026년 4월 16일 출시, 입력 100만 토큰당 5달러·출력 100만 토큰당 25달러의 동일 가격을 제시한다.[6][8] 개선 초점은 일반 대화보다 고난도 소프트웨어 엔지니어링, 장시간 에이전트 작업, 고해상도 이미지 이해에 있다. Anthropic도 4.7을 claude opus 4 7 모델로 Claude API에서 사용할 수 있다고 안내한다.[8][9]
실무에서는 다음으로 무엇을 해야 합니까?
다만 주요 수치 상당수는 Anthropic의 self reported benchmark, 파트너 내부 사례 또는 proprietary benchmark에 기반한다는 점을 감안해야 한다.
출처
verdent.aiClaude Opus 4.7 vs 4.6: Agentic Coding Comparison - Verdent AI
llm-stats.comClaude Opus 4.7 vs Opus 4.6 - LLM Stats
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
help.apiyi.comClaude Opus 4.7 VS 4.6 Comprehensive Comparison