トレンドAI投稿と注目リサーチのキャッチアップ - ページ1697
AIアプリ5本の試し方:Claude Opus 4.7と台湾繁体字対応はどう確認する?
11 ソース0今回の資料では、Claude Opus 4.7という名称が第三者ページ、Medium、YouTubeに出ていることは確認できる一方、Anthropicの公式発表や5つのAIアプリでの正式対応は確認できません [1][2][3][6][7][9]。
Claude Opus 4.7・Opus 4.6・Sonnet 4.6の選び方:coding agentと本番運用の現実解
13 ソース0本番の標準はSonnet 4.6、難しいcoding agentや長い出力はOpus 4.7へ上げるのが現実的です。両者は1M contextですが、max outputはOpus 4.7が128K、Sonnet 4.6が64Kです。[13]
GPT-5.5、Claude Opus 4.7、Kimi K2.6、DeepSeek V4比較:ベンチマークで分かる使い分け
22 ソース0端末操作型のコーディングエージェントはGPT 5.5、ソフトウェア修正系ベンチマークはClaude Opus 4.7が有力です [18][24]。
BWM条約監査マトリクス:条文、証拠、MEPC指針の整理法
9 ソース0監査指摘は、B 1は承認済みBWMP、B 2と附録IIはBWRB、D 1は交換、D 2は処理、D 3はBWMS承認、E 1/E 2は検査・証書という順で条文を起点に組み立てる [3][4][6][12]。
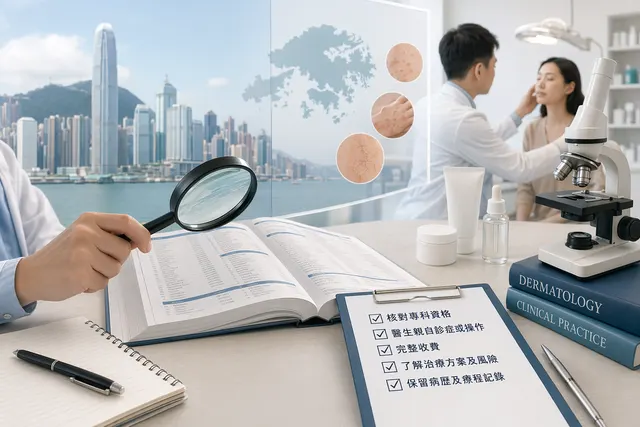
香港で皮膚科医を探す前に:名簿・診療内容・費用を確認する3ステップ
3 ソース0香港皮膚科医学院のCurrent Membersページは、医師の英語名・中国語名を照合する出発点として使えるが、推薦ランキングや料金表ではない[15]。
ランドリンのルームディフューザーとフレグランスジェル、部屋用ならどちら?
4 ソース0一般的な部屋で使うなら、ランドリンのルームディフューザーが選びやすい。炎やスプレー不要で、安定した香りが続くと説明されています[7]。
2026年5月のIVF胚移植日選び:通勝・八字では5月6日が第一候補
6 ソース0医療チームが2026年5月5日・6日・7日のいずれも胚移植可能と判断しているなら、通勝・八字上の優先順位は5月6日、5月5日、5月7日の順です。
GPT-5.5、Claude Opus 4.7、DeepSeek V4、Kimi K2.6のベンチマークはどう読むべきか
15 ソース0四者を直接横並びにできる公開項目として最も使いやすいのはTerminal Bench 2.0で、GPT 5.5が82.7%で先行する。ただし、出所が異なるため絶対的な総合順位にはできない。[29][30][6]
GPT-5.5のベンチマーク:GDPval 84.9%をどう読むか
10 ソース0一般的な短い説明で最も引用しやすいのは、OpenAIが公表したGDPvalの84.9%です。GDPvalは44の職業にまたがる知識労働を測るベンチマークです。[1]
GPT-5.5対Claude Opus 4.7:コーディングはGPT優勢、デザインと創作はまだ決めきれない
19 ソース0公開資料ベースでは、コーディングはGPT 5.5がやや優勢です。Terminal Benchで82.7%を記録しClaude Opus 4.7を上回ったとの報道や、SWE Bench Verifiedでの道具利用・ファイル探索の強さが主な根拠です。
Claude Opus 4.7とGPT-5.5のコーディング比較:PRパッチはClaude、端末エージェントはGPT
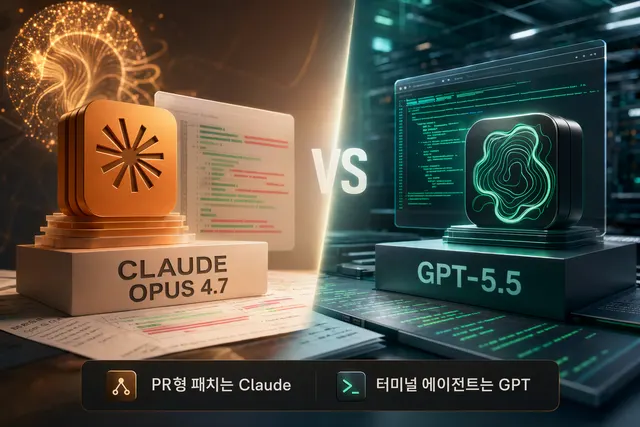
12 ソース0コーディングでの絶対王者は決めにくい。SWE Bench ProではClaude Opus 4.7が64.3%、GPT 5.5が58.6%でOpus優勢。一方、Terminal Bench 2.0ではGPT 5.5が82.7%、Opus 4.7が69.4%でGPT優勢です [3][6]。
Leonardo AIとは?機能・料金・商用利用の注意点を整理
8 ソース0Leonardo AIは、テキストプロンプトから画像・テクスチャ・コンセプトアートを作れるAIデザイン系プラットフォームとして紹介されています [7]。