答え公開済み10 ソース
GPT-5.5のベンチマーク:GDPval 84.9%をどう読むか
一般的な短い説明で最も引用しやすいのは、OpenAIが公表したGDPvalの84.9%です。GDPvalは44の職業にまたがる知識労働を測るベンチマークです。[1] Expert SWEの73.1%やBixBenchの80.5%は、それぞれコーディングやバイオインフォマティクスを測る別の指標で、GDPvalとは単純比較できません。[8][10] 外部比較ではArtificial AnalysisのIntelligence IndexでGPT 5.5が3ポイント差の首位とされていますが、全ての個別評価で勝っているという意味ではありません。[3]
公開者GPT-5.5 で編集GPT Image 2 で画像を生成
研究の答え
重要なポイント
- 一般的な短い説明で最も引用しやすいのは、OpenAIが公表したGDPvalの84.9%です。GDPvalは44の職業にまたがる知識労働を測るベンチマークです。[1]
- Expert SWEの73.1%やBixBenchの80.5%は、それぞれコーディングやバイオインフォマティクスを測る別の指標で、GDPvalとは単純比較できません。[8][10]
- 外部比較ではArtificial AnalysisのIntelligence IndexでGPT 5.5が3ポイント差の首位とされていますが、全ての個別評価で勝っているという意味ではありません。[3]
AI プロンプト
openai.comCreate a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject "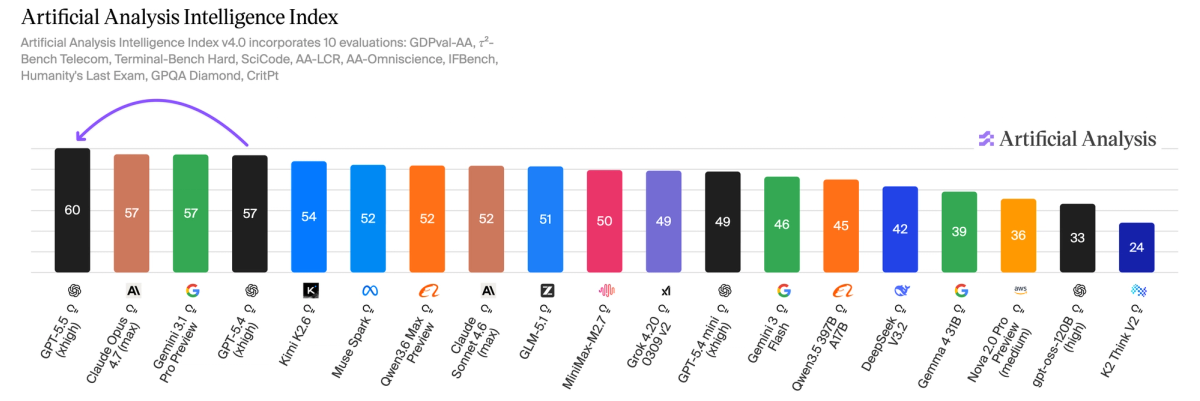 GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
GPT-5.5の性能を一言で示すなら、まず見るべきは GDPvalで84.9% という数値です。OpenAIはGDPvalを、44の職業にわたって「明確に仕様化された知識労働」をAIエージェントが作成できるかを見るベンチマークだと説明し、GPT-5.5のスコアを84.9%と公表しています。
ただし、この数字は「AIの総合点」や「知能そのものの点数」ではありません。GDPvalが見ているのは、仕事に近い知識作業を、条件に沿って成果物としてまとめる力です。 コーディング、バイオインフォマティクス、外部ランキングとは測っているものが違います。
まず引用するなら:GDPval 84.9%
一般向けに短く書くなら、次の表現が最も誤解が少ないでしょう。
GPT-5.5は、OpenAIによるとGDPvalで**84.9%**を記録した。GDPvalは、44の職業にまたがる明確に仕様化された知識労働をAIエージェントが作れるかを測るベンチマークです。
Studio Global AI
研究を続けてください
このページにはソースに裏付けされた回答が含まれており、Studio Global 内で続行できます。
人々も尋ねます
「GPT-5.5のベンチマーク:GDPval 84.9%をどう読むか」の短い答えは何ですか?
一般的な短い説明で最も引用しやすいのは、OpenAIが公表したGDPvalの84.9%です。GDPvalは44の職業にまたがる知識労働を測るベンチマークです。[1]
最初に検証する重要なポイントは何ですか?
一般的な短い説明で最も引用しやすいのは、OpenAIが公表したGDPvalの84.9%です。GDPvalは44の職業にまたがる知識労働を測るベンチマークです。[1] Expert SWEの73.1%やBixBenchの80.5%は、それぞれコーディングやバイオインフォマティクスを測る別の指標で、GDPvalとは単純比較できません。[8][10]
次の実践では何をすればいいでしょうか?
外部比較ではArtificial AnalysisのIntelligence IndexでGPT 5.5が3ポイント差の首位とされていますが、全ての個別評価で勝っているという意味ではありません。[3]
情報源
openai.comIntroducing GPT-5.5 - OpenAI
ca.finance.yahoo.comOpenAI releases GPT-5.5 with improved coding and research capabilities
linkedin.comOpenAI Releases GPT-5.5 With State-of-the-Art Scores on Coding, Science, and Computer Use
artificialanalysis.aiOpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis