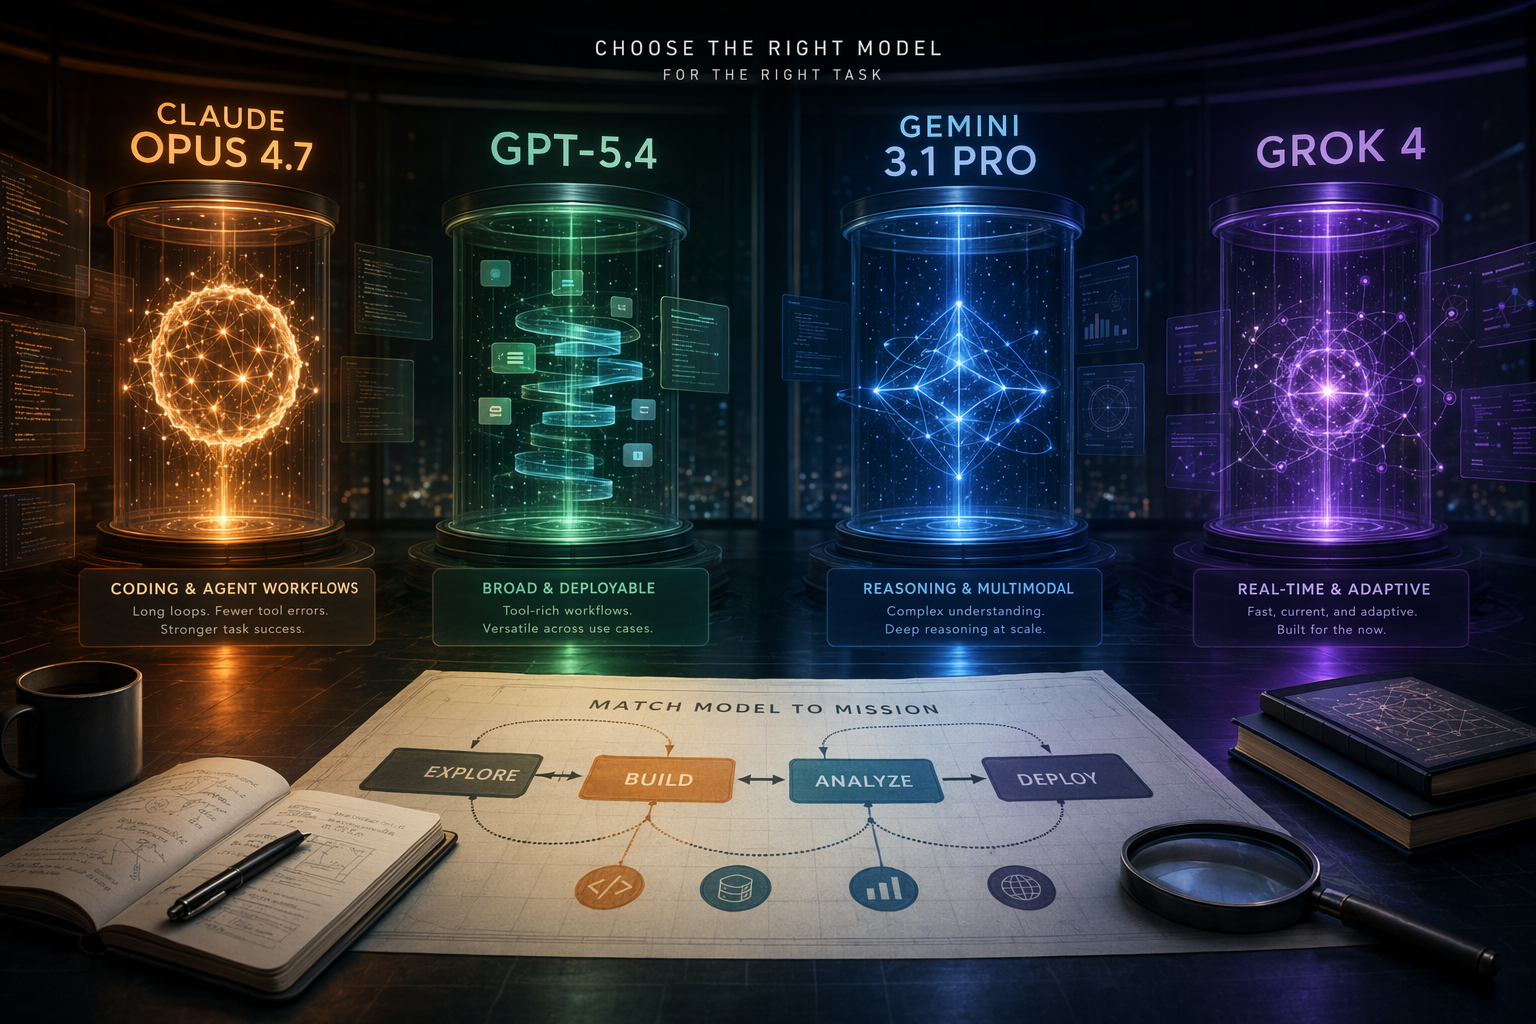
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
AI プロンプト
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
AIモデル選びで最初に捨てたい発想は、「結局どれが一番強いのか」という一問一答です。Claude Opus 4.7、GPT-5.4、Gemini 3.1 Pro、Grok 4はいずれも強力ですが、失敗しやすい場面が違います。第三者によるLLM選定ガイドも、単一のモデルがすべてのタスクを支配しているわけではなく、coding、構造化推論、多モーダル、科学系タスク、高難度推論で強みが分かれると整理しています。
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
AI プロンプト
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
AIモデル選びで最初に捨てたい発想は、「結局どれが一番強いのか」という一問一答です。Claude Opus 4.7、GPT-5.4、Gemini 3.1 Pro、Grok 4はいずれも強力ですが、失敗しやすい場面が違います。第三者によるLLM選定ガイドも、単一のモデルがすべてのタスクを支配しているわけではなく、coding、構造化推論、多モーダル、科学系タスク、高難度推論で強みが分かれると整理しています。
Claude Opus 4.7で最も注目すべき公開情報は、Anthropicが「タスク成功率」と「ツールエラーの少なさ」を前面に出している点です。公式ページでは、Claude Opus 4.7はOpus 4.6を上回り、Factory Droidsでのタスク成功率が10〜15%向上し、ツールエラーが少なく、より信頼性が高いとされています。
Claude Opus 4.7は、coding、エージェント型ワークフロー、ツールを使う長い作業で最初に試す価値が高いモデルです。Anthropicの公式情報では、Opus 4.6に比べてFactory Droidsのタスク成功率とツールエラー面で改善が示されており、Axiosもcodingとvisionを強化した旗艦モデルとして報じています。
Claude Opus 4.7で最も注目すべき公開情報は、Anthropicが「タスク成功率」と「ツールエラーの少なさ」を前面に出している点です。公式ページでは、Claude Opus 4.7はOpus 4.6を上回り、Factory Droidsでのタスク成功率が10〜15%向上し、ツールエラーが少なく、より信頼性が高いとされています。
Claude Opus 4.7は、coding、エージェント型ワークフロー、ツールを使う長い作業で最初に試す価値が高いモデルです。Anthropicの公式情報では、Opus 4.6に比べてFactory Droidsのタスク成功率とツールエラー面で改善が示されており、Axiosもcodingとvisionを強化した旗艦モデルとして報じています。
iternal.aiThe Definitive LLM Selection & Benchmarks Guide
anthropic.comClaude Opus 4.7 - Anthropic
axios.comAnthropic releases Claude Opus 4.7, concedes it trails ... - Axios
adam.holter.comAI Labs LLM Rankings 2026: Claude vs GPT-5 vs Gemini 3 vs Grok
failingfast.ioAI coding model comparison - Failing Fast