Postingan AI Trending & Rangkuman Riset Terbaru - Halaman 1723
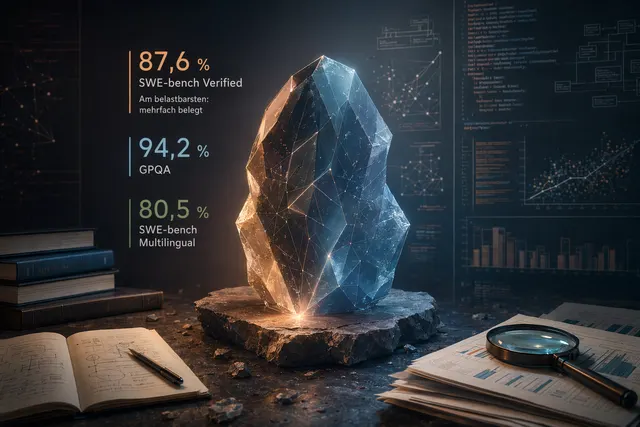
Benchmark Claude Opus 4.7: Angka Kunci dan Seberapa Kuat Buktinya
16 sumber0Angka publik utama untuk Claude Opus 4.7 adalah 87,6% di SWE bench Verified, 94,2% di GPQA, dan 80,5% di SWE bench Multilingual.
Claude Mythos Preview: Arti Skor 93,9% di SWE-bench
17 sumber0Angka yang paling sering dikutip untuk Claude Mythos Preview adalah 93,9% di SWE bench, benchmark untuk tugas perangkat lunak; relevan untuk coding dan agen, tetapi bukan nilai umum model [1][2].
Benchmark Claude Mythos: skor 93,9% di SWE-bench dan batas perbandingannya
17 sumber0Claude Mythos Preview menonjol dengan skor 93,9% di SWE bench Verified, tetapi Anthropic menempatkannya sebagai research preview Project Glasswing yang hanya dapat diakses lewat undangan.
Kimi K2.6 vs DeepSeek V4 vs GPT-5.5 vs Claude Opus 4.7: benchmark dan harga
20 sumber0Tidak ada juara universal: Claude Opus 4.7 paling kuat untuk kualitas dan tugas sulit; GPT 5.5 unggul di Terminal Bench 2.0; Kimi dan DeepSeek mengubah kalkulasi saat biaya dan volume ikut dihitung [3][4][16].
GPT-5.5 vs Claude Opus 4.7: Benchmark, Harga, dan Panduan Memilih
17 sumber0Tidak ada pemenang tunggal: LLM Stats menyebut Claude Opus 4.7 unggul di 6 dari 10 benchmark yang sama sama dilaporkan, sedangkan GPT 5.5 unggul di 4; tetapi skornya banyak berupa laporan vendor pada high re...
GPT-5.5 vs DeepSeek V4: Benchmark, Coding, Agent, dan Harga
19 sumber0Tidak ada bukti kuat bahwa GPT 5.5 atau DeepSeek V4 menang di semua sisi. BenchLM mencatat DeepSeek V4 Flash High unggul di coding dengan skor rata rata 72,2 vs 58,6, tetapi GPT 5.5 unggul di agentic tasks d...
GPT-5.5 vs Claude Opus 4.7: Claude untuk perbaikan kode, GPT untuk agen terminal
17 sumber0Tidak ada pemenang mutlak: Claude Opus 4.7 unggul di SWE Bench Pro dengan 64,3% berbanding 58,6%, sementara GPT 5.5 memimpin di Terminal Bench 2.0 dengan 82,7% berbanding 69,4%; angka ini berguna untuk penya...
DeepSeek V4 vs Kimi K2.6: coding condong ke DeepSeek, konten dan terjemahan belum jelas
18 sumber0Untuk coding, angka publik yang paling langsung mendukung DS V4 Pro Max: LiveCodeBench(Pass@1) 93,5, di atas K2.6 Thinking 89,6, dengan catatan ini berasal dari tabel DeepSeek [18][35].
DeepSeek V4 vs Kimi K2.6 vs Claude Opus 4.7 vs GPT-5.5: siapa unggul di benchmark?
16 sumber0Tidak ada juara mutlak: data resmi OpenAI mencatat GPT 5.5 82,7% di Terminal Bench 2.0 dan 58,6% di SWE Bench Pro, sementara data langsung untuk DeepSeek V4 lebih banyak baru soal ketersediaan API [24][25].
GPT-5.5 vs Claude Opus 4.7 vs Kimi K2.6 vs DeepSeek V4: siapa unggul di benchmark?
19 sumber0Tidak ada pemenang tunggal: GPT 5.5 memimpin ARC AGI 2 dengan 85% vs 75,8% untuk Claude, dan Terminal Bench 2.0 dengan 82,7%; Claude Opus 4.7 lebih kuat di HLE dan SWE Bench Pro.[1][3][9]
GPT-5.5 vs Claude Opus 4.7: Pilih Mana untuk Coding, Desain, dan Konten?
19 sumber0Pada 10 benchmark yang sama sama dilaporkan penyedia, Claude Opus 4.7 unggul di 6 kategori dan GPT 5.5 di 4 kategori.
Kimi K2.6 vs DeepSeek V4: Kimi unggul untuk coding, DeepSeek kuat di konteks panjang
23 sumber0Untuk coding praktis seperti memperbaiki repositori dan membantu implementasi, Kimi K2.6 layak dicoba lebih dulu.